Anthropic hat eine neue Version seines leistungsstärksten Modells veröffentlicht. Claude Fable 5.2 erscheint nur zwei Monate nach Version 5.1, und das Unternehmen gibt an, dass es besser programmiert, nachdenkt, Bilder sowie Diagramme analysiert und verständlicher mit Menschen kommuniziert. Gleichzeitig ist es um ein Fünftel günstiger geworden und antwortet bis zu 30 Prozent schneller. Laut der unabhängigen Messung von Artificial Analysis handelt es sich um das leistungsstärkste Modell, das derzeit jeder kaufen kann. Dennoch empfiehlt selbst Anthropic, dass die meisten Menschen mit dem günstigeren Opus 5.5 beginnen sollten.
Ein Modell und zwei Versionen
Zusammen mit Fable wurde auch Claude Mythos 5.2 veröffentlicht. Dabei handelt es sich nicht um zwei unterschiedliche Gehirne, denn beide basieren auf derselben Grundlage. Fable verfügt über strengere Sicherheitsvorkehrungen in den Bereichen Cybersicherheit und Biologie, weshalb Anthropic es öffentlich anbieten kann. Bei Mythos sind diese Einschränkungen gelockert, doch es wird nur geprüften Unternehmen und Laboren zur Verfügung gestellt. Wenn Fable eine sensible Anfrage blockiert, verfasst Opus stattdessen die Antwort.
Fable ist für große, langwierige und nicht ganz eindeutig definierte technische Aufgaben ausgelegt. Für gewöhnliche Arbeiten mit Code oder Texten empfiehlt Anthropic Opus 5.5 und rät dazu, erst dann zu Fable zu greifen, wenn die schwächere Version nicht ausreicht. Das neue Modell kann auch als Berater fungieren, den kleinere Modelle bei einem schwierigen Problem konsultieren, oder als Leiter, der einfachere Arbeiten unter den schnelleren Modellen verteilt.
Programmiert wie ein erfahrener Ingenieur
Am stärksten zeigt sich das neue Fable beim Programmieren. Ein Ingenieur von Anthropic beauftragte es damit, den Prototyp eines Betriebssystems zu entwerfen. Das Modell begann mit einem leeren Ordner, koordinierte mehr als tausend Hilfsagenten, und nach acht Tagen ununterbrochener Arbeit entstand ein System, das sich auf einem Notebook starten lässt. Es verfügt über einen eigenen Kernel, Treiber für Festplatte, Tastatur und Netzwerk, Fenster, einen Anmeldebildschirm sowie ein Installationsprogramm. Konkurrenz für Windows oder Linux sollte man allerdings nicht erwarten, denn es handelt sich um einen experimentellen Prototyp.
Ein Agententeam mit einer früheren Version des Modells schrieb einen der internen Dienste des Unternehmens von Python auf Rust um, und der Dienst startet nun etwa 26-mal schneller. Unternehmen, die Fable vor der Veröffentlichung testeten, loben vor allem, dass es auch vage Aufgabenstellungen versteht. Ein Ingenieur von Uber ließ damit zehn bis zwölf Stunden lang ein Sicherheitsaudit durchführen. Fable entsandte rund 170 Prüfagenten und lieferte einen Bericht, fertige Korrekturen sowie einen Entwurf für neue Regeln. Bei Oracle wiederum formulierte es eine Datenbankabfrage zu Staatsschulddaten korrekt, während zwei andere Modelle fünf- bis achtmal höhere Zahlen ausgaben.
Fermat in 30 Stunden und Schwarze Löcher
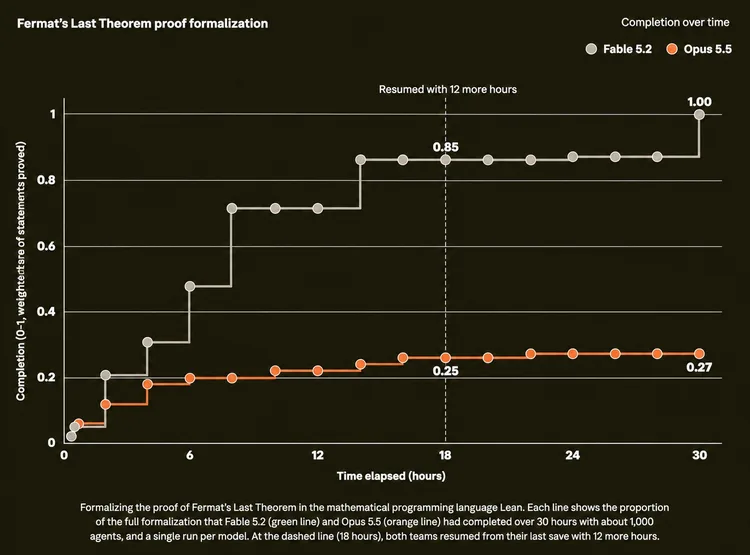
Anthropic präsentiert auch Ergebnisse außerhalb der Programmierung. Tausend Agenten von Fable 5.2 übertrugen den Beweis des Großen Fermatschen Satzes in die Sprache Lean, in der ein Computer ihn Schritt für Schritt überprüfen kann. Dies dauerte 30 Stunden, während ein früherer Versuch des Unternehmens 11 Tage in Anspruch genommen hatte. Opus 5.5 schaffte unter denselben Bedingungen in 18 Stunden etwa ein Viertel der Arbeit. Das Modell entwickelte dabei keinen neuen Beweis, sondern übertrug lediglich einen bereits bekannten Text.
In der Physik löste es laut Anthropic zwei Probleme im Zusammenhang mit Schwarzen Löchern und der Quantengravitation. Die Ergebnisse wurden als vorläufige wissenschaftliche Studien veröffentlicht, haben jedoch noch kein Peer-Review durch andere Wissenschaftler durchlaufen. Auf Grundlage einer ein Absatz langen Aufgabenstellung entwarf Fable anschließend drei elektronische Geräte, konkret einen sprachgesteuerten Heimassistenten, ein USB-Konferenztelefon und ein virtuelles Haustier im Taschenformat. Es wählte selbst die Komponenten aus und entwarf Leiterplatten, Gehäuse für den 3D-Druck sowie die Software. Alle drei Geräte funktionierten ohne eine einzige Änderung an der Schaltung. Auch bei der Steuerung von Robotern verbesserte es sich deutlich; diese lösten mit seiner Hilfe einen Zauberwürfel oder schraubten den Deckel einer Flasche ab.
Was sich gegenüber Fable 5.1 geändert hat
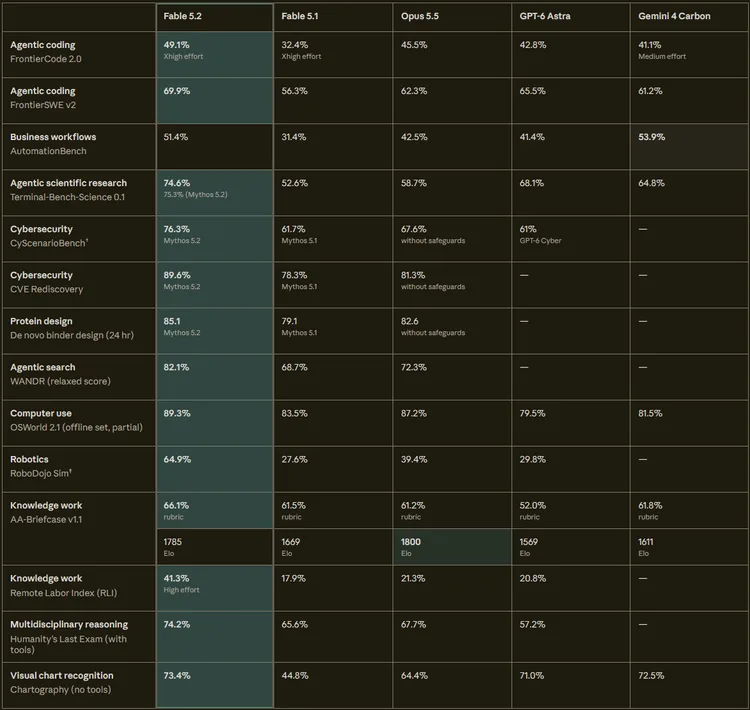
Die vorherige Version hatte Probleme. Im aktuellen Index von Artificial Analysis fiel sie hinter Opus 5.5 zurück, und Kunden zahlten mehr für eine schwächere Leistung. Fable 5.2 sprang bei derselben Messung von 49 auf 65 Punkte, was der höchste Wert aller Modelle und sechs Punkte mehr als bei Opus ist.
Die Tabellen von Anthropic zeigen die größten Sprünge bei langen Aufgaben. In einem Test, bei dem das Modell echte Aufträge vom Markt für freiberufliche Arbeit erledigt, bewältigte es 41 Prozent der Aufgaben gegenüber 18 Prozent beim Vorgänger. In einem Test, der misst, ob die Entwickler von Open-Source-Softwareprojekten seine Codeänderungen akzeptieren würden, stieg der Wert von 32 auf 49 Prozent. Bei der Steuerung eines simulierten Roboters hat sich die Erfolgsquote mehr als verdoppelt. All diese Zahlen wurden jedoch vom Hersteller selbst gemessen.
Auch gewöhnliche Nutzer werden die Veränderungen bemerken. Bei mittlerem Aufwand, den die Anwendungen Claude und Claude Code standardmäßig verwenden, verbraucht das Modell weniger Token als Version 5.1. Die Schutzfilter bremsen es unnötigerweise etwa halb so häufig aus, im Bereich Cybersicherheit sogar um 60 Prozent seltener. Tester stellen außerdem fest, dass das Modell häufiger zugibt, wenn es etwas nicht weiß, anstatt etwas zu erfinden.
Wo Fable 5.2 nicht führt
Fable 5.2 liegt nicht überall vorn. In einem Test zur Automatisierung von Unternehmensprozessen wurde es von Googles Gemini 4 Carbon geschlagen, und bei Büroarbeiten bleibt Opus 5.5 knapp überlegen. Diskussionsteilnehmer auf Hacker News weisen darauf hin, dass sie beim gewöhnlichen Programmieren kaum einen Unterschied zu Opus bemerken und dass Anthropic in seiner Tabelle Fable bei höchstem Aufwand mit Gemini bei mittlerem Aufwand vergleicht.
Der tschechische Publizist Patrick Zandl ließ Fable, Opus und Sonnet nach versteckten Fehlern in echtem Code suchen. Die meisten Fehler aus der Liste fand das günstigste Modell Sonnet 5.5, während Fable und Opus den schwerwiegendsten Fehler zuverlässiger erkannten. Fable schnitt bei mittlerem Aufwand besser ab als bei hohem und schlug das mit maximaler Leistung betriebene Opus in einem Viertel der Zeit. Einen eindeutigen Sieger zwischen den Modellen Fable und Opus konnte Zandl jedoch nicht ermitteln.
Professor Ethan Mollick von der Wharton School weist darauf hin, dass das Modell die Qualität seiner eigenen Arbeit schlecht einschätzt. Ein wissenschaftlicher Artikel, den Fable selbst verfasste, wuchs auf 182 Seiten an und enthielt weiterhin Fehler. Ein anderer Tester stellte fest, dass das Modell nicht weiß, wie spät es ist. Ein Nutzer beschwerte sich wiederum darüber, dass Fable mehr Agenten als vorgesehen startete und das Fünf-Stunden-Limit in weniger als zwanzig Minuten aufbrauchte.
Wie viel wir dafür bezahlen
Über die API kosten eine Million Eingabe-Token 8 Dollar und eine Million Ausgabe-Token 40 Dollar. Die Version Fable 5.1 kostete 10 beziehungsweise 50 Dollar. Laut TechCrunch ist die neue Version günstiger als der Hauptkonkurrent GPT-6 Astra von OpenAI. Opus 5.5 kostet jedoch weiterhin nur die Hälfte, nämlich 4 beziehungsweise 20 Dollar.
Für den doppelten Preis lässt sich ein schneller Modus aktivieren, der die Generierung um das bis zu Zweieinhalbfache beschleunigt. Anthropic behauptet zugleich, dass Fable bei hohem Aufwand beim Programmieren dasselbe Ergebnis wie Opus bei maximalem Aufwand erzielt, und zwar zu etwa der Hälfte der Aufgabenkosten. Unabhängig überprüft hat dies bislang jedoch niemand.
Verfügbarkeit
Fable 5.2 ist seit dem 9. November auf allen Plattformen von Anthropic verfügbar, konkret in den Claude-Anwendungen mit kostenpflichtigen Tarifen, in Claude Code und über die API unter der Bezeichnung claude-fable-5-2. Es wird außerdem von den Cloud-Plattformen von Amazon, Google und Microsoft angeboten. Im Pro-Tarif und bei Standardplätzen im Team-Tarif darf das Modell höchstens die Hälfte des wöchentlichen Limits verbrauchen. Wer Fable im Abonnement hat, erhält diese Woche je nach Länge des vorausbezahlten Zeitraums als Bonus ein bis drei Zurücksetzungen des Limits.
Unternehmen, die wegen der Sicherheitsüberprüfung Bedenken hinsichtlich der Datenspeicherung hatten, können das Modell nun über das System Enterprise Frontier Safeguards nutzen, ohne dass ihre Daten gespeichert werden; das System befindet sich derzeit in einer geschlossenen Betaphase. Die Version Mythos 5.2 erhalten nur Sicherheitsexperten und Wissenschaftler aus dem Bereich Biologie, die ein Überprüfungsprogramm durchlaufen. Kunden des Enterprise-Tarifs erhalten über das Tool Claude Security Zugriff darauf, das ihren Code prüft und darin nach Sicherheitslücken sucht.
Quellen: anthropic.com, gptunnel.en und techcrunch.com