Unternehmen, die KI-Assistenten entwickeln, unternehmen große Anstrengungen, damit sich ihre Programme an frühere Gespräche erinnern. Eine neue Studie aus Shanghai kommt jedoch zu einem Ergebnis, das Entwickler nicht erfreuen dürfte. Sobald ein Sprachmodell ausreichend fortgeschritten ist, hilft ihm ein spezieller Speicher kaum noch, und dessen Betrieb kostet mehr, als er einspart. Besser funktioniert eine künstliche Intelligenz, die Zugriff auf das vollständige Gesprächsprotokoll hat und die benötigten Informationen darin selbst sucht.
Zwei Arten, wie sich KI erinnert
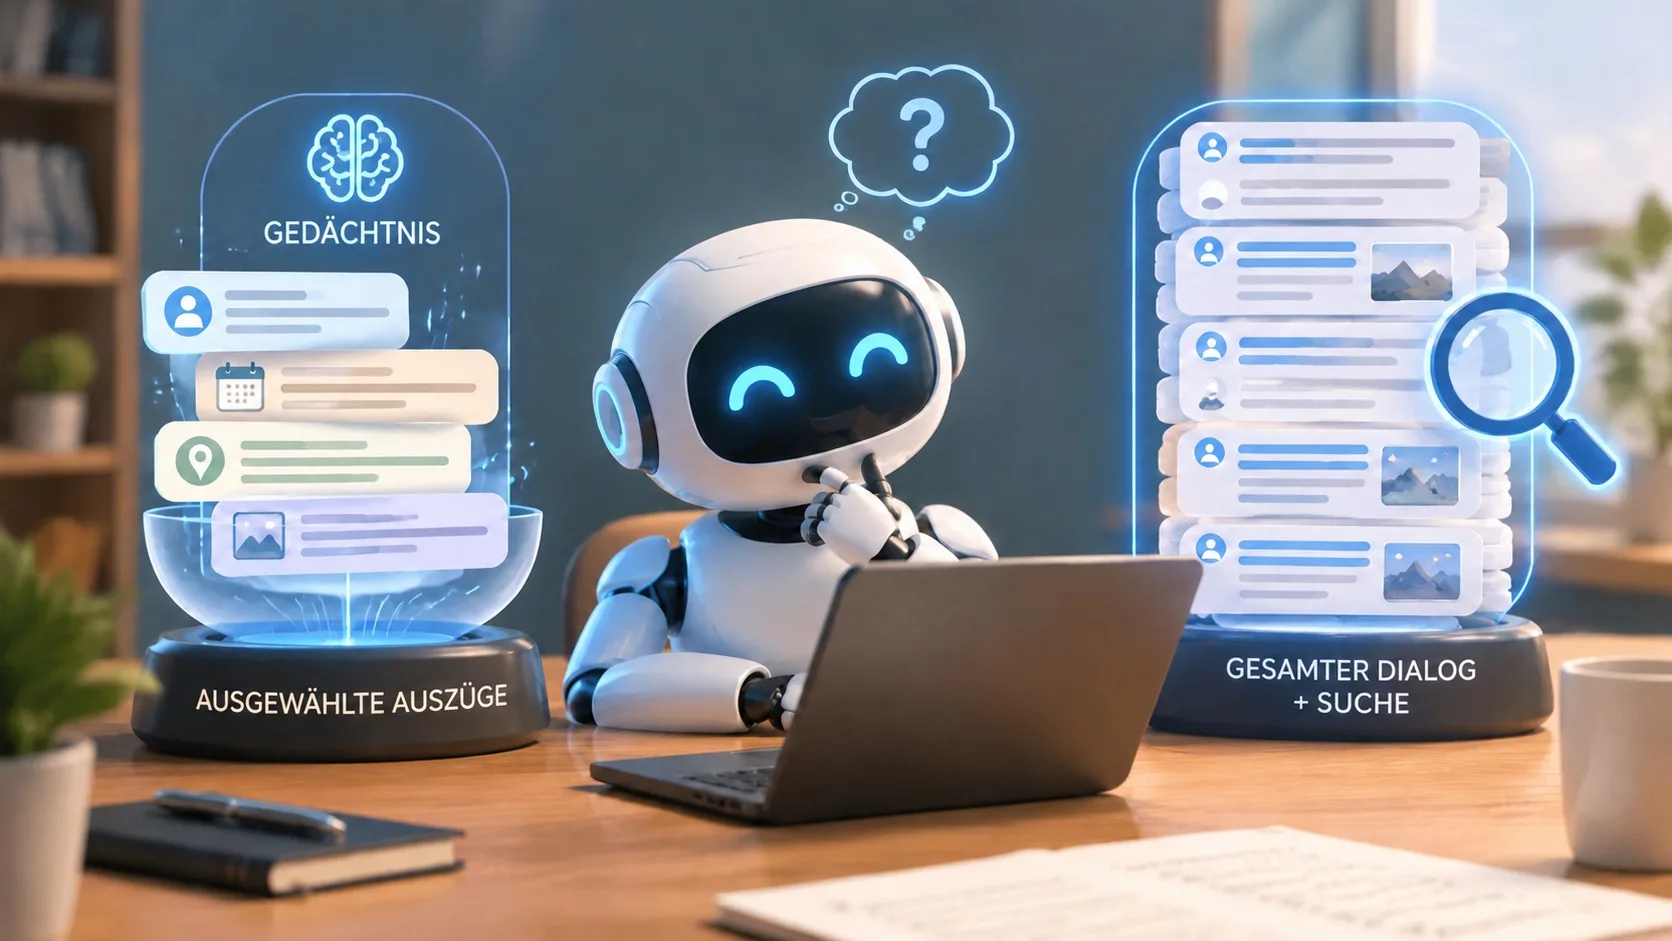
Der Autor der Studie, Zedong Peng von der Shanghai Jiao Tong University, verglich zwei Ansätze. Den ersten vertreten die Werkzeuge Mem0 und Zep, die vorab wichtige Punkte aus dem Gespräch auswählen. Mem0 extrahiert einzelne Fakten aus dem Text, während Zep eine Karte der Zusammenhänge zwischen Menschen, Dingen und Ereignissen erstellt. Bei einer Frage erhält das Modell dann nur einige ausgewählte Ausschnitte.
Den zweiten Ansatz nutzen Programmieragenten, also KI-Helfer, die ursprünglich für die Arbeit mit Code vorgesehen waren. Die Werkzeuge Pi, Codex von OpenAI und Claude Code von Anthropic sortieren im Vorfeld nichts. Sie arbeiten mit dem gesamten unverarbeiteten Protokoll und durchsuchen es mit eigenen Algorithmen, ähnlich wie ein Mensch in einem langen Dokument nach einem bestimmten Wort sucht.
Peng geht von einer Idee aus, die der Informatiker Richard Sutton 2019 beschrieb und die in der Branche als bittere Lektion bezeichnet wird. Demnach hilft in ein System eingebautes menschliches Wissen anfangs, stößt mit der Zeit jedoch an seine Grenzen. Am Ende setzen sich stets allgemeine Methoden durch, deren Effizienz mit der Rechenleistung steigt. Speicherwerkzeuge enthalten dieses voreingestellte Wissen, weil sie selbst entscheiden, was sie aufbewahren. Peng wollte herausfinden, ob sich ein solches Vorgehen auch bei Modellen lohnt, die selbstständig suchen können.
Ein langes Gespräch und 152 Fragen
Als Testmaterial diente ein Gespräch zwischen zwei Personen aus dem bekannten LoCoMo-Testdatensatz. Dieser Dialog umfasst 419 Gesprächsbeiträge, die auf 19 Sitzungen verteilt sind, und ist mit 152 Fragen verknüpft. Einige Fragen beziehen sich auf einfache Fakten, andere erfordern die Verknüpfung mehrerer Informationen oder die korrekte Bestimmung der zeitlichen Abfolge.
Sieben Methoden traten gegeneinander an. Neben den Werkzeugen Mem0, Zep und den drei Agenten bezogen die Forscher auch zwei einfache Möglichkeiten ein. Dabei erhält das Modell entweder das gesamte Gespräch auf einmal oder nur einige Gesprächsbeiträge, die durch eine gewöhnliche Stichwortsuche gefunden wurden. Peng testete jede Methode mit drei Modellen, vom schwächsten bis zum stärksten: GPT-4o-mini, GPT-6 Luna und Claude Opus 5.5. Bei jedem Versuch erfasste er außerdem die finanziellen Kosten.
Ein Speicher hilft einem schwachen Modell
Mit dem schwächsten Modell GPT-4o-mini schnitt das Werkzeug Mem0 am besten ab und beantwortete 78 % der Fragen richtig. Das gesamte Gespräch und die Stichwortsuche kamen jeweils auf 74 %, während Zep lediglich 43 % erreichte. Die Agenten versagten mit diesem schwachen Modell. Pi erledigte 63 % der Aufgaben erfolgreich, Codex und Claude Code schafften nicht einmal ein Drittel. Codex öffnete zwar in drei Vierteln der Fälle die Datei mit dem Gespräch, Claude Code jedoch fast nie. Ohne die Datei zu öffnen, antworteten beide Modelle dann praktisch blind und ausschließlich auf Grundlage der Aufgabenstellung.
Bei den stärkeren Modellen kehrte sich die Situation um. GPT-6 Luna ermittelte mit dem gesamten Gespräch 92 % der Antworten richtig, mit dem Werkzeug Mem0 jedoch nur 80 %. Beim Modell Claude Opus 5.5 erzielten Mem0 und das gesamte Gespräch mit jeweils 95 % das gleiche Ergebnis, doch die Agenten konnten sie übertreffen. Pi beantwortete 99 % der Fragen richtig, Codex 98 % und Claude Code 97 %.
Der Vorteil des Werkzeugs Mem0 beim schwachen Modell hat seinen Preis. Allein der Aufbau des Speichers kostet mehr als der gesamte Test mit dem vollständigen Gespräch. Bei GPT-4o-mini sind es 56 Cent gegenüber 43 Cent, beim Modell Claude Opus 5.5 fast 26 Dollar gegenüber knapp 18 Dollar. Abfragen des fertigen Speichers sind zwar günstiger, doch damit sich die anfänglichen Kosten amortisieren, müsste das Modell Hunderte Fragen zum selben Gespräch beantworten, bei Opus sogar fast sechshundert. Der Test umfasst jedoch nur 152 Fragen. Peng bezeichnet dieses Phänomen als Speichersteuer, also als unnötige Ausgaben für etwas, das ein stärkeres Modell überhaupt nicht benötigt.
Ein Speicher ist nur so gut wie das Modell, das ihn anlegt
Die Studie offenbart noch eine zweite Schwäche. Die Qualität des Speichers wird von dem Modell bestimmt, das ihn anlegt. Peng überprüfte dies, indem er Modelle Fragen aus einem Speicher beantworten ließ, den ein anderes Modell erstellt hatte. Aus der vom Werkzeug Zep erzeugten Karte, die das schwache GPT-4o-mini erstellt hatte, holte selbst das fortgeschrittene Claude Opus 5.5 lediglich 45 % heraus. Aus der Karte, die es selbst erstellt hatte, gewann es dagegen 87 %. Ein stärkerer Leser kann Informationen nicht finden, die ein schwächerer Verfasser ausgelassen hat. Beim Werkzeug Mem0 verhält es sich ähnlich, die Unterschiede sind jedoch geringer.
Pi gewann, aber teilweise dank der Fotos
Das beste Verhältnis von Preis und Ergebnis bot der Agent Pi mit dem Modell Claude Opus 5.5. Für 99 % richtige Antworten zahlte er rund sieben Dollar, während das gesamte Gespräch mit demselben Modell fast 18 Dollar kostete. Pi liest den Text nämlich nicht vollständig und durchsuchte bei jeder Frage nur etwa ein Drittel des Inhalts. Codex und Claude Code kosteten dagegen mehr als 25 beziehungsweise 28 Dollar.
Ein Teil des Vorsprungs hat jedoch nichts mit dem Speicher zu tun. Einige Gesprächsbeiträge enthalten Fotos, und die offizielle Datei umfasst dazu Textbeschreibungen. Die Agenten erhielten Zugriff auf die Datei einschließlich dieser Beschreibungen, während die Speichermethoden nur mit reinem Text arbeiteten. Die Fotos betreffen 116 Gesprächsbeiträge und 64 Fragen. Von den sieben Fragen, die Pi erfolgreich beantwortete, das gesamte Gespräch jedoch nicht, bezogen sich sechs gerade auf die Fotos. Bei den übrigen 88 Fragen ohne Bilder erreichte Pi eine Erfolgsquote von 100 %, während das gesamte Gespräch, Mem0, Codex und Claude Code jeweils auf 99 % kamen. Wenn also beide Ansätze denselben Text lesen, erreicht Pi das Niveau des gesamten Gesprächs für weniger als die Hälfte des Preises.
Ein kleiner Test mit großen Einschränkungen
Peng weist darauf hin, dass es sich um eine kleine Studie handelt. Er testete nur eines von zehn Gesprächen und führte jede Kombination nur einmal aus, sodass sich ein Unterschied von wenigen Fragen in einer weiteren Runde möglicherweise nicht wiederholen würde. Das Gespräch passte zudem problemlos in das Kontextfenster jedes Modells, bei längeren Verläufen könnten die Ergebnisse daher anders ausfallen. Die Werkzeuge Mem0 und Zep liefen außerdem mit den Standardeinstellungen und hätten mit einer Optimierung möglicherweise besser abgeschnitten.
Die Antworten wurden vom schwachen Modell GPT-4o-mini nach sehr großzügigen Regeln bewertet, und auch der Test selbst war nicht fehlerfrei. Die einzige Frage, die Pi mit Opus laut Aufgabenstellung falsch beantwortete, bezog sich auf das Bild, das Caroline Melanie am 13. Oktober 2023 zeigte. Dem offiziellen Lösungsschlüssel des Tests zufolge handelte es sich um ein abstraktes Bild mit blauen Streifen. Im Gespräch wurde es jedoch von Melanie geteilt, während Caroline eine Zeichnung schickte. Pi wies korrekt auf diese Unstimmigkeit hin und erhielt dennoch eine negative Bewertung. Ebenso erging es dem gesamten Gespräch, Codex und Claude Code, die mit Opus denselben Fehler erkannten.
Quelle: arxiv.org