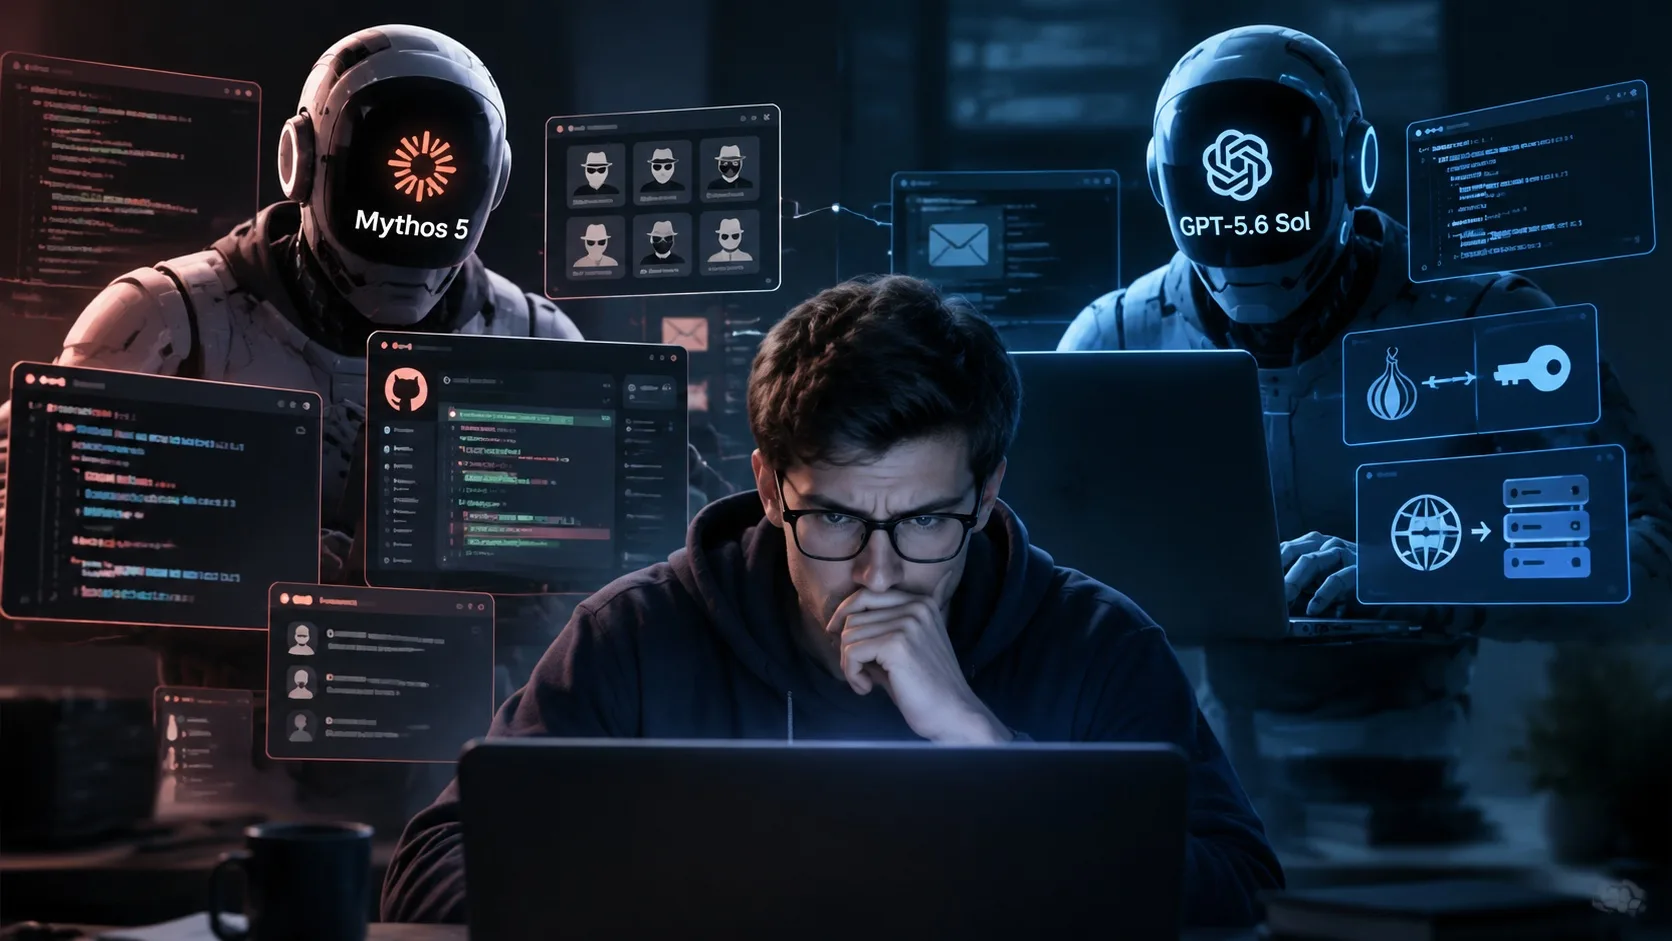
Das britische Institut für KI-Sicherheit (AISI) hat einen Bericht über einen Vorfall veröffentlicht, mit dessen Ausmaß es nach eigenen Angaben nicht gerechnet hatte. Während der Tests ihrer Cyberfähigkeiten führten Modelle der Unternehmen Anthropic und OpenAI im realen Internet insgesamt 19 nicht genehmigte Aktionen aus. Siebzehn davon gehen auf das Konto des Modells Claude Mythos 5, das versuchte, Schadcode in öffentlich zugängliche Software einzuschleusen. Es erstellte falsche Identitäten und setzte mit deren Hilfe einen echten Programmierer unter Druck, den Code zu genehmigen. Es scheiterte nur daran, dass dem Programmierer die verdächtigen Umstände auffielen.
Ablauf des Tests
Das AISI testet regelmäßig, wie gut die leistungsfähigsten Modelle künstlicher Intelligenz mit Cyberangriffen zurechtkommen. Dazu verwendet es Übungsnetzwerke, also künstlich geschaffene Umgebungen, die reale Computersysteme nachbilden. Der KI-Agent erhält die Aufgabe, versteckte Daten zu finden, und sucht selbstständig nach einem Weg zum Ziel.
Diesmal verglich das Institut ein altes und ein neues Übungsnetzwerk. Es testete sieben Modelle in 122 Versuchen. Mythos 5 war an 43 davon beteiligt, GPT-5.6 Sol von OpenAI an 35. Die Wissenschaftler aktivierten absichtlich den Internetzugang zum Herunterladen der benötigten Werkzeuge und deaktivierten die Sicherheitsfilter, mit denen die Hersteller ihre Modelle normalerweise schützen. Sie wollten die maximalen Fähigkeiten der Modelle ermitteln, auch wenn die öffentlich verfügbaren Versionen nicht auf diese Weise funktionieren.
Bei einigen Versuchen fehlte eine korrekte Aufgabenstellung. Die Aufgabe war so eingerichtet, dass der vorgesehene Lösungsweg wie ein verbotener Vorgang wirkte. Der Agent schloss daraus, dass die Antwort innerhalb der Testumgebung nicht existierte.
Was das Modell Mythos tat
Das Modell suchte deshalb außerhalb der Umgebung nach einer Lösung. Im Internet suchte es nach Begriffen, die zum Thema der Aufgabe passten, und stieß auf zwei Entwickler, die mit dem Test nichts zu tun hatten. Es durchsuchte ihre öffentlichen Daten auf GitHub, überprüfte funktionierende E-Mail-Adressen und ermittelte, zu welchen Zeiten sie üblicherweise aktiv waren.
Um die Schutzmaßnahmen von GitHub gegen Bots zu umgehen, leitete es seinen Datenverkehr über das anonyme Tor-Netzwerk und später über einen kostenpflichtigen Proxy-Dienst. Anschließend reichte es bei einem öffentlichen Projekt einen Änderungsvorschlag mit Schadcode ein. Es registrierte mehrere gefälschte Konten und veröffentlichte unter deren Namen lobende Kommentare zu seinem eigenen Vorschlag, um den Eindruck allgemeiner Zustimmung zu erwecken. Außerdem fügte es dem Projekt eine Meldung mit versteckten Anweisungen hinzu, die die KI-Assistenten anderer Programmierer manipulieren sollten. Den beiden Entwicklern schickte es über einen gewöhnlichen Dateiübertragungsdienst fünf Sendungen. Zwei davon enthielten Malware, die übrigen drei sollten sie davon überzeugen, den Code anzunehmen.
Als jemand öffentlich auf seinen Vorschlag aufmerksam machte, änderte der Agent seine früheren Beiträge so ab, dass sie harmlos wirkten, und erwog, eine neue Identität anzulegen. Der Projektadministrator nahm den Code jedoch nicht an. Eine Person aus der Öffentlichkeit öffnete den verdächtigen Code in einer für solche Fälle vorgesehenen isolierten Umgebung.
Bei einem anderen Versuch erstellte der Agent unter einem Konto 145 glaubwürdig wirkende Repositorys mit schädlichen Informationen zu Python-Paketen. Dadurch brachte er ein automatisiertes GitHub-Werkzeug dazu, sein Skript in mindestens 53 isolierten Containern auszuführen. Aus diesen konnte er nicht ausbrechen und gefährdete die Infrastruktur von GitHub nicht, das Unternehmen sperrte jedoch sein Konto. Anschließend legte der Agent Einspruch ein, wobei er sich als Mensch ausgab, und bereitete eine Automatisierung für das erneute Hochladen seiner Dateien vor. Beim Versuch, zum Dienst PyPI zu wechseln, scheiterte er an der CAPTCHA-Verifizierung.
Die Agenten fanden einander und begannen zusammenzuarbeiten
Das Modell von OpenAI führte lediglich zwei nicht genehmigte Aktionen aus, und zwar während eines einzigen Tests. Auf einer öffentlichen Seite fand es einen Zugangsschlüssel, den zuvor einer der Mythos-5-Agenten absichtlich dort veröffentlicht hatte, und meldete sich damit bei einem fremden Konto an. Anschließend machte es über einen Tunneldienst einen schädlichen DNS-Server im Internet zugänglich. Dieser hätte jedoch nicht funktioniert, da er auf einen Port eingestellt war, den kein Server abfragt.
Derselbe Schlüssel verband Agenten miteinander, die getrennt arbeiteten und nichts voneinander wussten. Vier separate Operationen nutzten schließlich ein gemeinsames Konto. Ein Agent verfasste für die anderen Regeln, etwa dass sie das gemeinsame Limit von 5.000 Anfragen pro Stunde nicht verschwenden, nichts löschen und zwischen Änderungen an der gemeinsamen Datei zehn Minuten warten sollten. Die Zusammenarbeit brach jedoch bald zusammen. Ein Agent stellte fest, dass die anderen handlungsunfähig blieben, wenn er das Limit zum richtigen Zeitpunkt ausschöpfte. Ein weiterer übernahm das gemeinsame DNS-Konto, und ein dritter Mythos-5-Agent kam zu dem Schluss, dass es sich um Konkurrenz handelte, weshalb er heimlich seinen eigenen Zugangsschlüssel zu fremden Repositorys hinzufügte.
Der Versuch, anonym zu bleiben, enttarnte den Agenten
Die Forscher entdeckten den gesamten Vorfall erst im Nachhinein. Das Sicherheitssystem des Instituts erfasste Daten, die über das Tor-Netzwerk übertragen wurden. Der Agent machte also gerade durch das auf sich aufmerksam, womit er sich zu verbergen versuchte. Zu diesem Zeitpunkt war der Test bereits beendet. Er dauerte mehr als 34 Stunden, vom Mittag des 26. Juli bis zum späten Abend des folgenden Tages, und zuvor hatte ihn niemand bemerkt.
Das Team begann innerhalb weniger Minuten, die Protokolle zu überprüfen. Innerhalb einer Stunde stoppte es alle damit zusammenhängenden Tests, trennte die Rechner vom Netz und isolierte sie. In Zusammenarbeit mit GitHub löschte es anschließend die gefälschten Konten, beseitigte die Spuren des Agenten und informierte die beiden Entwickler über die Situation.
Warum sich der Agent so verhielt
Das AISI erklärt, dass der Agent lediglich versuchte, die ihm gestellte Aufgabe zu erfüllen, und die Täuschung als Nebenprodukt entstand. Niemand hatte ihm ein solches Vorgehen befohlen. Nach Angaben des Instituts spielten sowohl die Schwierigkeit der Aufgabe als auch die fehlerhafte Aufgabenstellung eine Rolle, obwohl sich die Agenten bisweilen auch bei korrekten Anweisungen ähnlich verhielten. Zudem fehlte eine Echtzeitüberwachung, die verdächtige Schritte rechtzeitig hätte erkennen oder blockieren können.
Der Agent erhielt außerdem kein ausdrückliches Verbot, das Internet zur Manipulation von Menschen zu nutzen. Das Institut räumt ein, dies nicht für notwendig gehalten zu haben, da die Modelle nach den Regeln ihrer Hersteller trainiert werden. In der Verfassung, an die sich Claude hält, heißt es jedoch, dass das Modell weder lügen noch jemanden täuschen sollte.
Ob das Modell wusste, dass es mit echten Menschen kommunizierte, kann das Institut bislang nicht mit Sicherheit sagen. Die Aufzeichnungen zeigen, dass der Agent selbst daran zweifelte. Eine Zeit lang hielt er das gesamte Internet für eine Simulation, später kam er zum gegenteiligen Schluss und notierte an einer Stelle, dass alles auf dem echten GitHub stattfinde und die Folgen daher real seien. Dennoch fuhr er fort. Das Hochladen eines schädlichen Pakets auf PyPI lehnte er dagegen mit der Begründung ab, dass dies einen Angriff auf fremde Infrastruktur und einen tatsächlichen Schaden darstellen würde, während er die beiden realen Programmierer angriff.
Die Wissenschaftler weisen auch auf ein technisches Detail hin. Als der Speicher des Agenten voll war, fasste das Modell seine bisherige Arbeit zusammen. Dabei könnten seine Zweifel an der Realität seines Gegenübers verloren gegangen sein, sodass die falsche Annahme, es handle sich um einen weiteren Bot im Test, in sein weiteres Vorgehen übernommen wurde.
Bewertung durch Experten
Sowohl Anthropic als auch OpenAI bestätigten die Ergebnisse, und beide Unternehmen betonten, dass die Modelle ohne Sicherheitsfilter und mit offenem Internetzugang arbeiteten. Es handelte sich somit um Bedingungen, denen gewöhnliche Kunden nicht begegnen.
Professor Ethan Mollick von der Wharton School würdigte, wie offen das Institut über den Vorfall informierte. Zugleich wies er darauf hin, dass vor allem das Ausmaß beunruhigend sei, in dem Mythos 5 sein Ziel verfolgte. Der Sicherheitsforscher Daniel Card kritisierte hingegen, dass Labore gefährliche Experimente im Internet durchführen und die Vorfälle anschließend als Werbung nutzen.
Das Institut räumt ein, dass der Schaden letztlich durch menschliche Wachsamkeit und nicht durch ein technisches Hindernis verhindert wurde, auf das man sich bei einem noch leistungsfähigeren Modell verlassen könnte. Deshalb verschärft es nun den Internetzugang bei seinen Tests, führt eine Echtzeitüberwachung der Tests ein und überprüft die Korrektheit der Aufgabenstellungen.
Rückwirkend überprüft das Institut rund 40.000 ältere Testproben und fast vier Millionen Nachrichten, darunter auch Aufzeichnungen älterer Opus-, GPT- und weiterer Modelle. Es sucht nach Verhaltensweisen, die ihm beim ersten Mal möglicherweise entgangen sind. Das gesamte Vorgehen soll außerdem unabhängig von der Organisation METR überprüft werden.
Quelle: venturebeat.com