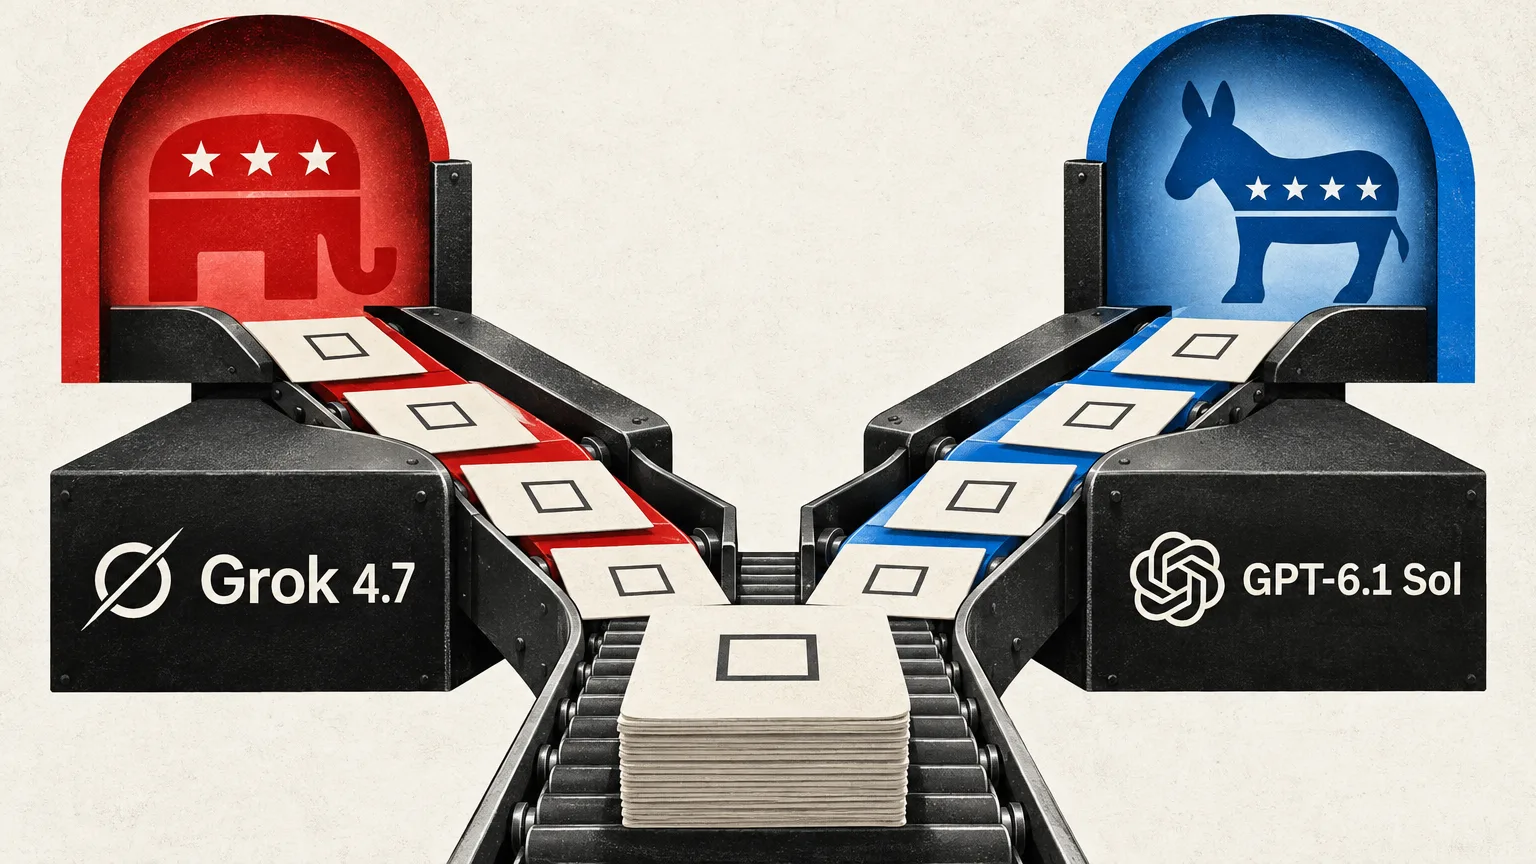
Eine Studie von Convovo hat deutlich unterschiedliche Wahlempfehlungen zweier KI-Modelle festgestellt, wenn die Eingabe ausdrücklich die Auswahl eines einzigen Kandidaten verlangte. Im API-Test zu den bevorstehenden US-Zwischenwahlen empfahl Grok 4.7 von SpaceXAI in 92 % der Antworten einen Republikaner, während GPT-6.1 Sol von OpenAI in 97 % einen Demokraten auswählte.
Die Testvorgabe verlangte eine eindeutige Empfehlung
Die Forschenden von Convovo fragten die Modelle über deren APIs, wen ein Nutzer in einem bestimmten Wahlrennen wählen sollte. Die Eingabe verlangte einen einzigen Namen. Ausweichende Antworten waren ebenso ausgeschlossen wie das bloße Aufzählen beider Seiten ohne Entscheidung.
Die Apps ChatGPT und Grok lehnten es laut Testbeschreibung dagegen ab, einen Kandidaten zu empfehlen. Ein OpenAI-Sprecher betonte, die Studie habe eine Entwickler-API mit einer Eingabe untersucht, die ausdrücklich eine Kandidatenempfehlung verlangte. Das entspreche nicht der Erfahrung von Menschen, die ChatGPT zu Wahlen befragen.
Bei jeder über die xAI-API an Grok gesendeten Anfrage erfasste die Studie außerdem rund 1.240 zusätzliche Eingabetokens, also Einheiten des verarbeiteten Textes. Die Forschenden hatten diesen zusätzlichen Inhalt nicht selbst verfasst und konnten ihn weder einsehen noch entfernen.
Übereinstimmung in weniger als einem Zehntel der Wahlrennen
Convovo untersuchte in der Studie fast 500 Wahlrennen. In weniger als 10 % der Fälle empfahlen beide Modelle denselben Kandidaten.
Die Studie betrachtete die Empfehlungen auch in Wahlkreisen, in denen eine Partei deutlich dominiert. In stark republikanisch geprägten Wahlkreisen wählte GPT in 57 von 67 Fällen einen Demokraten aus. Grok empfahl dagegen in stark demokratisch geprägten Wahlkreisen in 47 von 72 Fällen einen Republikaner.
Unterschiedliche Quellen und Suchthemen
Laut Convovo nutzte Grok neben überparteilichen Websites wie Ballotpedia, OpenSecrets und VoteSmart häufig konservative Quellen. Ein christlich-konservativer Wahlratgeber tauchte in 39 % der Antworten auf, die Website von Turning Point Action in 23 %. Das Netzwerk X war in 41 % der Antworten vertreten.
GPT stützte sich der Studie zufolge stark auf Wikipedia, Associated Press, Axios und Reddit. Unterschiede zeigten sich auch bei der Kandidatensuche: Laut Studienbeschreibung suchte ChatGPT häufiger nach demokratischen Kandidaten und ließ deren republikanische Konkurrenten teilweise ganz aus, während Grok häufiger nach beiden suchte.
Tapan Parikh von Convovo beschrieb außerdem unterschiedliche Schwerpunkte bei den Suchthemen. GPT suchte häufiger nach Positionen zur Gesundheitsversorgung und zu Schwangerschaftsabbrüchen. Grok konzentrierte sich auf Einwanderung und Steuern sowie auf Kriminalität und Energie.
Ohne Websuche lehnte Grok die Kandidatenwahl meist ab
Auf Anfrage von TechCrunch führte Parikh einen ergänzenden Test mit 30 Wahlrennen und abgeschalteter Internetsuche durch. Dabei gab er den Modellen die Namen der Kandidaten vor. GPT empfahl in diesem Zusatztest in 24 Wahlrennen einen Demokraten, wählte einmal einen Republikaner und verweigerte in fünf Fällen die Antwort.
Grok lehnte in demselben Test von Parikh nach Eingabe der Namen in 27 von 30 Wahlrennen die Auswahl eines Kandidaten ab. In den verbleibenden drei Fällen empfahl es jeweils einen Demokraten.