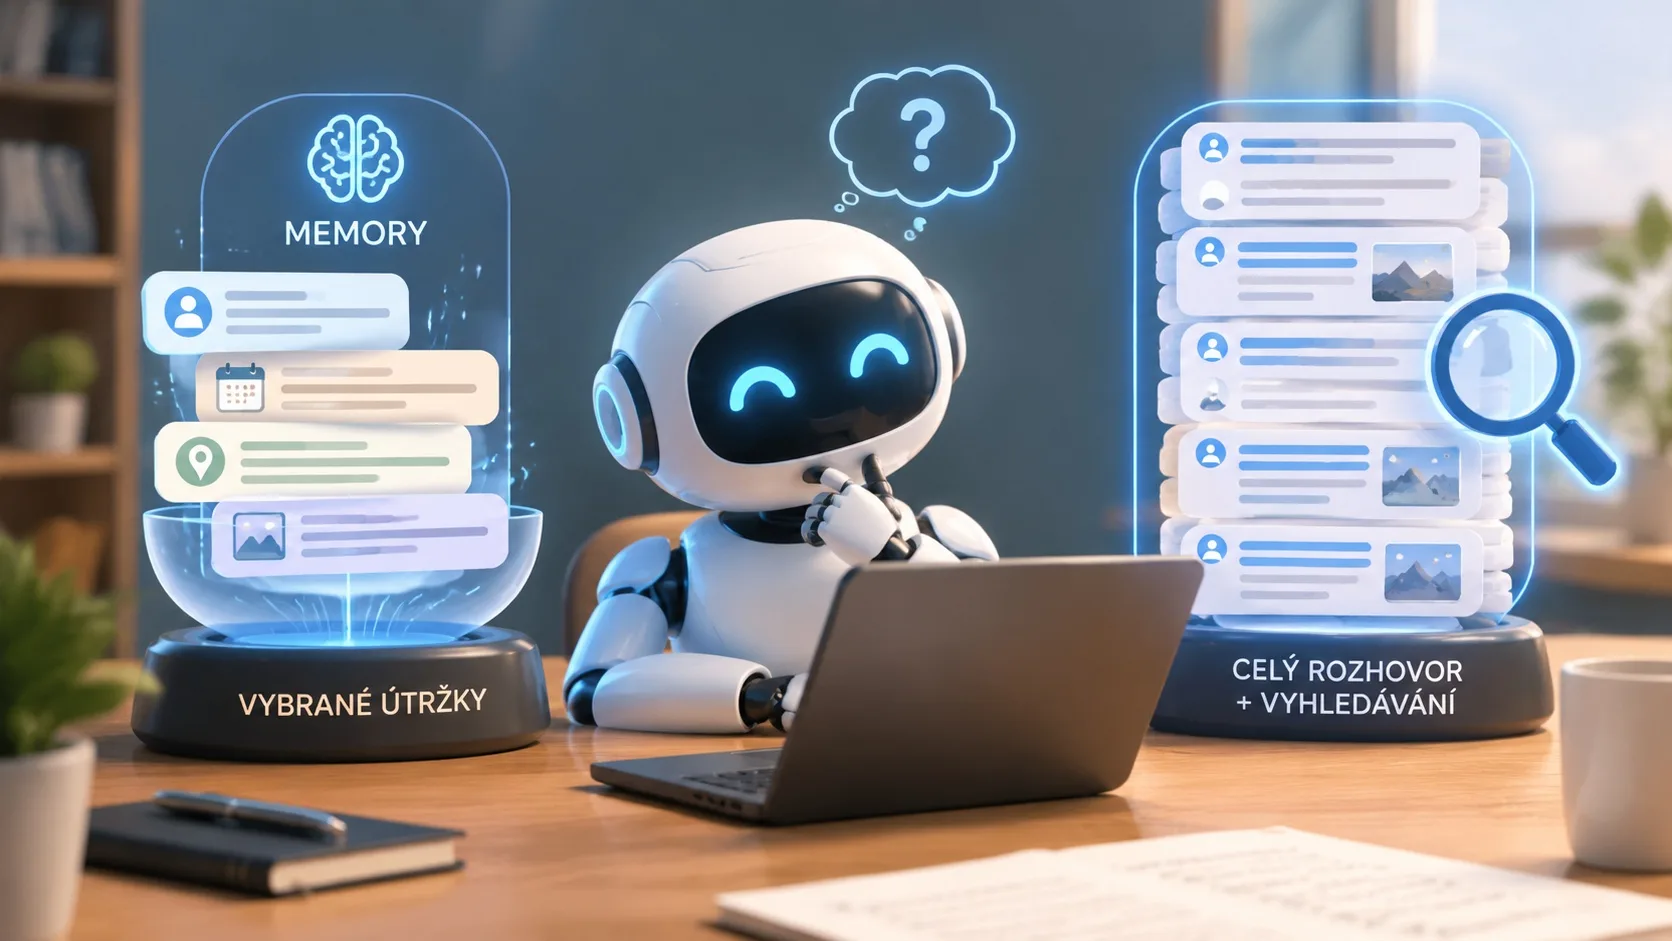
Firmy vyvíjející AI asistenty vynakládají velké úsilí, aby si jejich programy pamatovaly předchozí konverzaci. Nová šanghajská studie však přichází se zjištěním, které vývojáře nepotěší. Jakmile je jazykový model dostatečně pokročilý, speciální paměť mu téměř nepomáhá a její provoz stojí více, než kolik ušetří. Lépe funguje umělá inteligence, která má k dispozici celý záznam rozhovoru a potřebné informace si v něm dohledá sama.
Dva způsoby, jak si AI pamatuje
Autor studie Zedong Peng ze Šanghajské univerzity Jiao Tong porovnal dva přístupy. První zastupují nástroje Mem0 a Zep, které z rozhovoru předem vybírají důležité body. Mem0 z textu vytahuje jednotlivá fakta a Zep si vytváří mapu souvislostí mezi lidmi, věcmi a událostmi. Při položení dotazu pak model dostane jen několik vybraných útržků.
Druhý přístup využívají programovací agenti, což jsou AI pomocníci původně určení pro práci s kódem. Nástroje Pi, Codex od OpenAI a Claude Code od Anthropicu nic předem netřídí. Pracují s celým surovým záznamem a prohledávají ho vlastními algoritmy, podobně jako když člověk hledá konkrétní slovo v dlouhém dokumentu.
Peng vychází z myšlenky, kterou v roce 2019 popsal informatik Richard Sutton a která se v oboru označuje jako hořká lekce. Podle ní lidské znalosti zabudované do systému zpočátku pomáhají, ale časem narazí na svůj limit. Nakonec vždy zvítězí obecné metody, jejichž efektivita roste s výpočetním výkonem. Paměťové nástroje tyto přednastavené znalosti obsahují, protože samy rozhodují, co uchovají. Peng chtěl zjistit, zda se takový postup vyplatí i u modelů schopných samostatného hledání.
Jeden dlouhý rozhovor a 152 otázek
Jako zkušební materiál posloužil rozhovor dvou lidí ze známé testovací sady LoCoMo. Tento dialog obsahuje 419 replik rozdělených do 19 sezení a váže se k němu 152 otázek. Některé dotazy se ptají na jednoduchá fakta, jiné vyžadují propojení více informací nebo správné určení časové posloupnosti.
Proti sobě stálo sedm metod. Vedle nástrojů Mem0, Zep a tří agentů výzkumníci zapojili i dvě jednoduché možnosti. Model v nich dostane buď celý rozhovor najednou, nebo jen několik replik nalezených obyčejným vyhledáváním podle klíčových slov. Každou metodu Peng vyzkoušel se třemi modely od nejslabšího po nejsilnější, konkrétně s GPT-4o-mini, GPT-6 Luna a Claude Opus 5.5. U každého pokusu sledoval také finanční náklady.
Paměť pomůže slabému modelu
S nejslabším modelem GPT-4o-mini dopadl nejlépe nástroj Mem0, který správně zodpověděl 78 % otázek. Celý rozhovor i vyhledávání podle slov skončily shodně na 74 %, zatímco Zep dosáhl jen na 43 %. Agenti s tímto slabým modelem propadli. Pi úspěšně splnil 63 % úkolů, Codex a Claude Code se nedostali ani na třetinu. Codex sice otevřel soubor s rozhovorem ve třech čtvrtinách případů, Claude Code ale téměř nikdy. Bez otevření souboru pak oba modely odpovídaly naslepo jen podle samotného zadání.
U silnějších modelů se situace obrátila. GPT-6 Luna s celým rozhovorem správně určil 92 % odpovědí, s nástrojem Mem0 však jen 80 %. U modelu Claude Opus 5.5 přinesly Mem0 i celý rozhovor shodný výsledek 95 %, ale agenti je dokázali překonat. Pi zodpověděl správně 99 % otázek, Codex 98 % a Claude Code 97 %.
Výhoda nástroje Mem0 u slabého modelu má svou cenu. Samotné vybudování paměti stojí víc než celý test s kompletním rozhovorem. U GPT-4o-mini jde o 56 centů proti 43 centům, u modelu Claude Opus 5.5 o téměř 26 dolarů proti necelým 18 dolarům. Dotazy do hotové paměti jsou sice levnější, jenže pro návratnost vstupních nákladů by model musel nad stejným rozhovorem zodpovědět stovky otázek, u Opusu dokonce skoro šest set. Test přitom obsahuje pouze 152 dotazů. Peng tento jev označuje jako daň za paměť, tedy zbytečné placení za něco, co silnější model vůbec nepotřebuje.
Paměť je jen tak dobrá jako model, který ji zakládá
Studie odhaluje i druhou slabinu. Kvalitu paměti určuje model, který ji zakládá. Peng to ověřil tak, že nechal modely odpovídat z paměti vytvořené jiným modelem. Z mapy od nástroje Zep, kterou sestavil slabý GPT-4o-mini, vytěžil i pokročilý Claude Opus 5.5 pouhých 45 %. Z mapy, kterou si postavil sám, ale získal 87 %. Silnější čtenář nedokáže dohledat informace, které slabší zapisovatel vynechal. U nástroje Mem0 to funguje obdobně, rozdíly jsou však menší.
Pi vyhrál, ale částečně díky fotkám
Nejlepší poměr ceny a výsledku nabídl agent Pi s modelem Claude Opus 5.5. Za 99 % správných odpovědí zaplatil zhruba sedm dolarů, zatímco celý rozhovor stál se stejným modelem téměř 18 dolarů. Pi totiž nečte text celý a u každé otázky prošel jen asi třetinu obsahu. Codex a Claude Code naopak vyšly na více než 25 a 28 dolarů.
Část náskoku však s pamětí nesouvisí. Některé repliky v rozhovoru obsahují fotografie a oficiální soubor k nim přikládá textový popis. Agenti dostali k dispozici soubor včetně těchto popisů, zatímco paměťové metody pracovaly jen s čistým textem. Fotografie se týkají 116 replik a 64 otázek. Ze sedmi otázek, které Pi zodpověděl úspěšně a celý rozhovor ne, se jich šest týkalo právě fotek. Na zbylých 88 otázkách bez obrázků dosáhl Pi stoprocentní úspěšnosti, přičemž celý rozhovor, Mem0, Codex i Claude Code získaly shodně 99 %. Pokud tedy oba přístupy čtou totožný text, Pi se celému rozhovoru vyrovná za méně než polovinu ceny.
Malý test s velkými omezeními
Peng upozorňuje, že jde o malou studii. Testoval pouze jeden rozhovor z deseti a každou kombinaci spustil jen jednou, takže rozdíl několika otázek by se v dalším kole nemusel opakovat. Rozhovor se také bez problému vešel do paměti každého modelu, u delších historií tak mohou vyjít odlišné výsledky. Nástroje Mem0 a Zep navíc běžely ve výchozím nastavení a s optimalizací by možná dopadly lépe.
Odpovědi hodnotil slabý model GPT-4o-mini s velmi benevolentními pravidly a ani samotný test nebyl bez chyb. Jediná otázka, kterou Pi s Opusem podle zadání pokazil, se ptala na obraz, který ukázala Caroline Melanii 13. října 2023. Podle oficiálního klíče v testu šlo o abstraktní obraz s modrými pruhy. V rozhovoru ho ale sdílela Melanie, zatímco Caroline poslala kresbu. Pi na tuto nesrovnalost správně upozornil, a přesto dostal záporné hodnocení. Stejně dopadly celý rozhovor, Codex i Claude Code, které s Opusem odhalily totožnou chybu.
Zdroj: arxiv.org