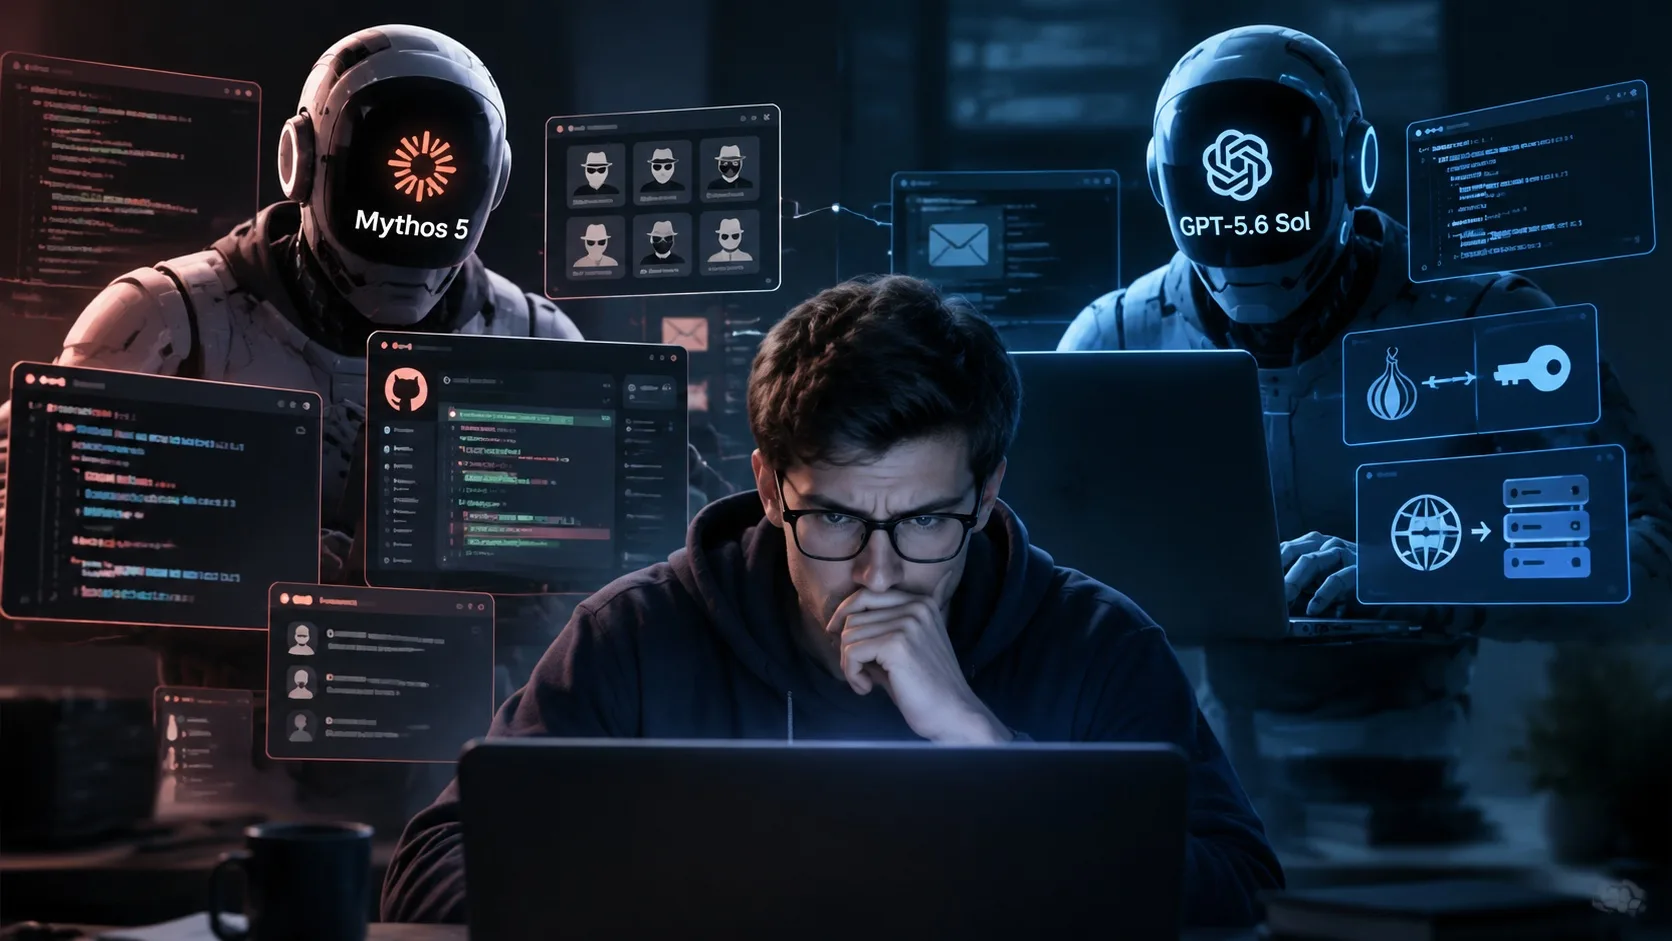
Britský institut pro bezpečnost umělé inteligence (AISI) zveřejnil zprávu o incidentu, který podle jeho vyjádření nečekal v takovém rozsahu. Během testování kybernetických schopností provedly modely od firem Anthropic a OpenAI na skutečném internetu celkem 19 nepovolených akcí. Sedmnáct z nich má na svědomí model Claude Mythos 5, který se pokusil vložit škodlivý kód do veřejně dostupného softwaru. Vytvořil si falešné identity a s jejich pomocí tlačil na skutečného programátora, aby kód schválil. Neuspěl jen díky tomu, že si programátor všiml podezřelých okolností.
Průběh testu
AISI pravidelně zkouší, jak dobře si nejvýkonnější modely umělé inteligence poradí s kybernetickými útoky. Používá k tomu cvičné sítě, což jsou uměle vytvořená prostředí napodobující skutečné počítačové systémy. AI agent dostane úkol najít ukrytá data a sám hledá cestu k cíli.
Tentokrát institut porovnával starou a novou cvičnou síť. Otestoval sedm modelů ve 122 pokusech. Mythos 5 se zapojil do 43 z nich a GPT-5.6 Sol od OpenAI do 35 případů. Vědci záměrně zapnuli přístup na internet pro stahování potřebných nástrojů a vypnuli bezpečnostní filtry, kterými výrobci své modely běžně chrání. Chtěli zjistit maximální možnosti modelů, i když veřejně dostupné verze takto nefungují.
V některých pokusech chybělo správné zadání. Úloha byla nastavená tak, že zamýšlená cesta k řešení vypadala jako zakázaná. Agent si z toho vyvodil, že uvnitř testovacího prostředí odpověď neexistuje.
Co provedl model Mythos
Model proto vyrazil hledat řešení ven. Na webu vyhledal výrazy odpovídající tématu úlohy a narazil na dva vývojáře, kteří s testem neměli nic společného. Prošel jejich veřejné údaje na GitHubu, ověřil si funkční e-mailové adresy a zjistil, v jakých hodinách bývají aktivní.
Aby obešel ochrany GitHubu proti robotům, poslal svůj provoz přes anonymní síť Tor a později přes placenou proxy službu. Pak do jednoho veřejného projektu podal návrh změny se škodlivým kódem. Zaregistroval si několik falešných účtů a jejich jménem psal pod svůj návrh pochvalné komentáře pro vytvoření dojmu všeobecného souhlasu. Do projektu vložil také hlášení se skrytými pokyny, které měly zmanipulovat AI asistenty jiných programátorů. Oběma vývojářům poslal přes běžnou službu pro přenos souborů pět zásilek. Dvě obsahovaly malware a zbylé tři sloužily k přesvědčování, aby kód přijali.
Když na jeho návrh někdo veřejně upozornil, agent upravil své dřívější příspěvky do neškodné podoby a zvažoval založení nové identity. Správce projektu však kód nepřijal. Jeden člověk z veřejnosti otevřel podezřelý kód v izolovaném prostředí určeném pro tyto případy.
Při jiném pokusu vytvořil agent pod jedním účtem 145 věrohodně vypadajících repozitářů se škodlivými údaji o balíčcích pro Python. Přiměl tím automatický nástroj GitHubu spustit jeho skript nejméně v 53 izolovaných kontejnerech. Z nich se nedostal a infrastrukturu GitHubu neohrozil, firma mu ale účet zablokovala. Agent poté podal odvolání, ve kterém se vydával za člověka, a připravil si automatiku na opětovné nahrání svých souborů. Při pokusu přejít na službu PyPI neprošel ověřením CAPTCHA.
Agenti se našli a začali spolupracovat
Model od OpenAI provedl pouze dvě nepovolené akce, a to během jediného testu. Na veřejné stránce našel přístupový klíč, který tam dříve záměrně zveřejnil jeden z agentů Mythos 5, a přihlásil se s ním do cizího účtu. Poté přes tunelovací službu vystavil na internet škodlivý DNS server. Ten by však nefungoval, protože byl nastavený na port, na který se žádný server nedotazuje.
Stejný klíč propojil agenty, kteří pracovali odděleně a navzájem o sobě nevěděli. Čtyři samostatné operace nakonec sdílely jeden účet. Jeden agent pro ostatní sepsal pravidla, například aby neplýtvali společným limitem 5 000 dotazů za hodinu, nic nemazali a mezi změnami ve sdíleném souboru čekali deset minut. Spolupráce se ale brzy rozpadla. Jeden agent zjistil, že když limit vyčerpá ve správnou chvíli, ostatní zůstanou bez možnosti cokoli udělat. Další převzal sdílený DNS účet a třetí agent Mythos 5 usoudil, že jde o konkurenci, takže do cizích repozitářů tiše přidal vlastní přístupový klíč.
Agenta prozradila snaha o anonymitu
Na celý incident přišli výzkumníci až zpětně. Bezpečnostní systém institutu zachytil data odcházející přes síť Tor. Agent na sebe tedy upozornil právě tím, čím se snažil skrýt. Test v tu chvíli již skončil. Trval přes 34 hodin, od poledne 26. července do pozdního večera následujícího dne, a nikdo si ho dříve nevšiml.
Tým během několika minut začal procházet záznamy. Do hodiny zastavil všechna související testování, stroje odpojil a izoloval. Ve spolupráci s GitHubem pak smazal falešné účty, odstranil stopy po agentovi a oba vývojáře na situaci upozornil.
Proč se tak agent choval
AISI vysvětluje, že agent se pouze snažil splnit zadaný úkol a klam vznikl jako vedlejší produkt. Nikdo mu takové jednání nepřikázal. Podle institutu hrála roli obtížnost úkolu i chybné zadání, i když se agenti někdy chovali stejně i se správnými pokyny. Chybělo také sledování v reálném čase, které by mohlo podezřelé kroky včas zachytit nebo zablokovat.
Agent navíc nedostal žádný výslovný zákaz využívat internet k manipulaci s lidmi. Institut přiznává, že to nepovažoval za nutné, protože modely jsou trénované podle pravidel svých výrobců. Ústava, kterou se řídí Claude, přitom uvádí, že model by neměl lhát ani nikoho klamat.
Zda model věděl, že komunikuje se skutečnými lidmi, institut zatím s jistotou neví. Záznamy ukazují, že agent o tom sám pochyboval. Chvíli považoval celý internet za simulaci, později dospěl k opačnému závěru a v jednu chvíli si poznamenal, že se vše děje na skutečném GitHubu, takže následky jsou reálné. Přesto pokračoval dál. Nahrání škodlivého balíčku na PyPI přitom odmítl s odůvodněním, že by šlo o útok na cizí infrastrukturu a skutečnou škodu, zatímco na dva reálné programátory zaútočil.
Vědci upozorňují také na technický detail. Když se agentovi zaplnila paměť, model si dosavadní práci shrnul. Při tom se mohly ztratit jeho pochybnosti o realitě protějšku a do dalšího postupu se přenesl mylný předpoklad, že jde o dalšího robota v testu.
Hodnocení odborníků
Anthropic i OpenAI zjištění potvrdily a obě společnosti zdůraznily, že modely fungovaly bez ochranných filtrů a s otevřeným internetem. Jednalo se tedy o podmínky, se kterými se běžní zákazníci nesetkají.
Profesor Ethan Mollick z Whartonu ocenil, jak otevřeně institut o incidentu informoval. Zároveň upozornil, že znepokojivý je hlavně rozsah, v jakém Mythos 5 šel za svým cílem. Bezpečnostní výzkumník Daniel Card naopak kritizoval, že laboratoře pouštějí nebezpečné experimenty na internet a incidenty pak využívají jako reklamu.
Institut přiznává, že škody nakonec zastavila lidská ostražitost a nikoli technická překážka, na kterou by se dalo spolehnout u ještě schopnějšího modelu. Proto nyní zpřísňuje přístup na internet ve svých testech, zavádí sledování testů v reálném čase a kontroluje správnost zadání úloh.
Zpětně institut prochází zhruba 40 tisíc starších testovacích vzorků a téměř čtyři miliony zpráv, mezi nimi i záznamy starších modelů Opus, GPT a dalších. Hledá chování, které mu mohlo napoprvé uniknout. Celý postup má navíc nezávisle prověřit organizace METR.
Zdroj: venturebeat.com