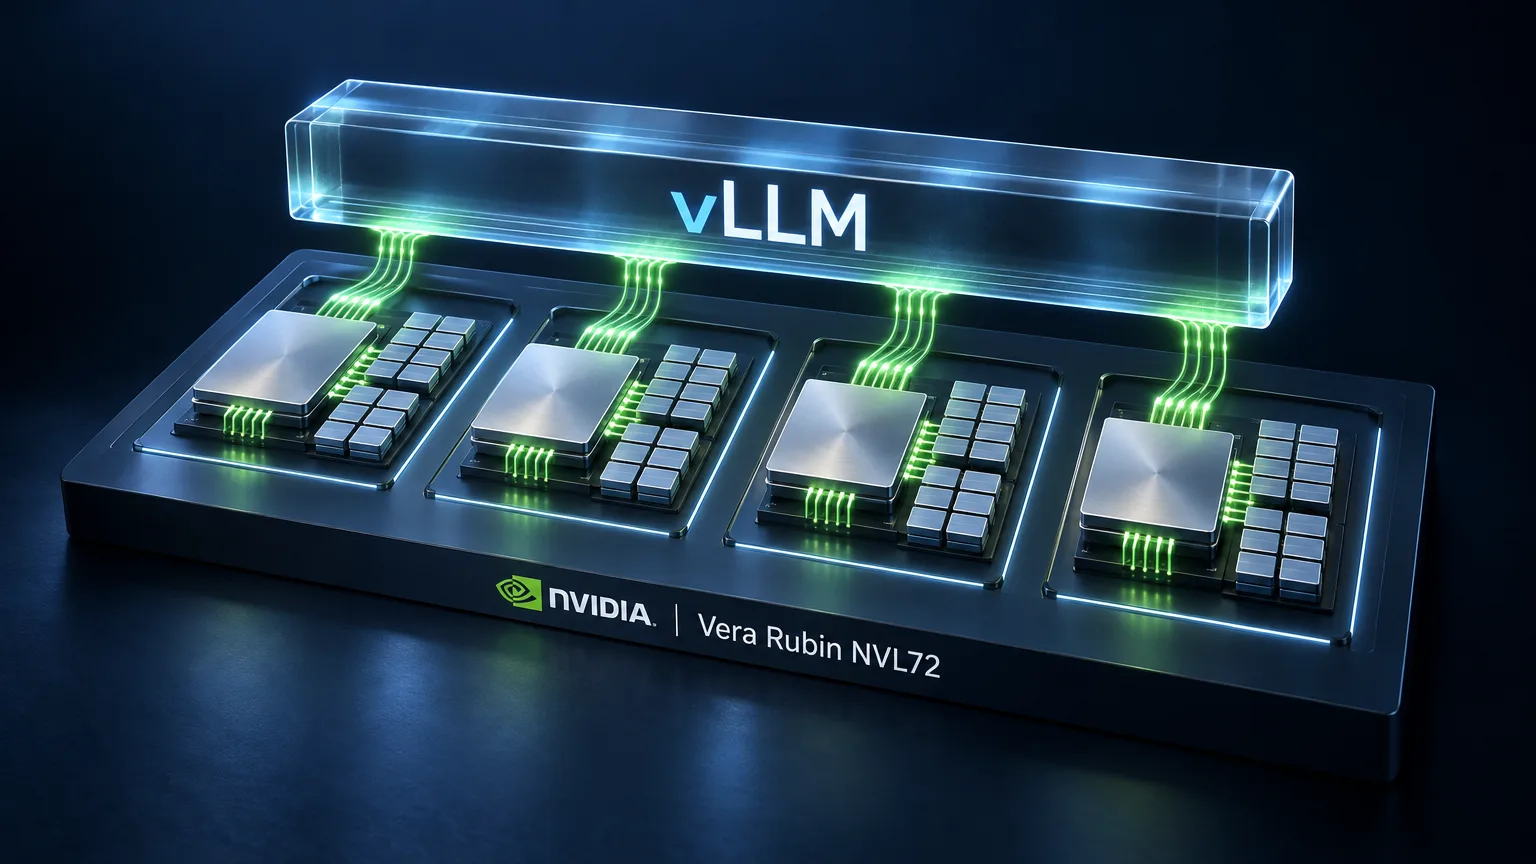
vLLM hat vorläufige Unterstützung für die Plattform NVIDIA Vera Rubin NVL72 bereitgestellt. Entwickler mit Zugang zu Rubin-Hardware können sie in Nightly-Containern mit CUDA 13.4 und PyTorch 2.15 nutzen. Dazu gehören FlashInfer-Kernels, die für Attention, Matrixmultiplikation und die Berechnungen von Mixture-of-Experts-Modellen optimiert sind.
DeepSeek, Kimi, GLM und MiniMax laufen bereits auf Rubin
Das Container-Image vllm/vllm-openai:cu134-nightly steht Entwicklern mit Zugang zu Rubin zur Verfügung. In Zusammenarbeit mit Inferact, NVIDIA und Red Hat hat das Projekt auf dieser Hardware Modelle von DeepSeek, Kimi, GLM und MiniMax ausgeführt.
Für die anfängliche Modellabdeckung kommen auf Rubin auch bestehende Blackwell-Kernels zum Einsatz. Ausführen lassen sich diejenigen, die für das vorwärtskompatible Ziel sm100f kompiliert wurden. Spezialisierte Kernels für sm107 kommen schrittweise hinzu.
Rubin gegen GB200 und GB300: Tests mit MiniMax M3 und multimodalem Qwen
Für agentische Inferenz hat vLLM vorläufige Ergebnisse des AgentX-Tests mit MiniMax M3 veröffentlicht. Diese Arbeitslast umfasst lange Kontexte und wiederholte Modellaufrufe, die Speicherbandbreite und MoE-Ausführung beanspruchen. Bei gleicher angestrebter Reaktionszeit meldet das Projekt auf Vera Rubin einen bis zu 7,84-mal so hohen Durchsatz pro GPU wie auf NVIDIA GB200. Bei einer Vorgabe von 150 Tokens pro Sekunde beträgt der gemeldete Durchsatz das 5,18-Fache.
Der zweite Vergleich betrifft das multimodale Modell Qwen3-VL-235B-A22B im Test MLPerf Inference v6.1 VLM. Laut den vorläufigen Ergebnissen von vLLM erreichte die Konfiguration mit NVIDIA Dynamo in Offline-, Server- und interaktiven Szenarien einen bis zu 3,7-mal so hohen Durchsatz wie GB300 NVL72. Dynamo leitet in dieser getesteten Konfiguration die Anfragen an vLLM-Worker weiter.
Die Messungen erfolgten auf Hardware in einem frühen Entwicklungsstadium und mit einer begrenzten Anzahl von Knoten. Die mit „bis zu“ angegebenen Werte beziehen sich auf die besten gemessenen Konfigurationen, nicht auf eine garantierte Beschleunigung für alle Modelle und Arbeitslasten.
Expertengewichte rücken näher an die Recheneinheiten
Die optimierten Kernels liefert FlashInfer 0.7.0. Sie decken Attention, GEMM-Matrixmultiplikation und MoE-Berechnungen ab. Beim MoE-Decoding nutzt vLLM die Lokalitätsdomänen von CUDA 13.4, um Teile der Gewichte und die zugehörigen Berechnungen den entsprechenden Bereichen innerhalb der GPU zuzuordnen.
Dazu teilt vLLM die Gewichtsmatrizen FC1 und FC2 der Experten spaltenweise auf und ordnet die einzelnen Teile Lokalitätsdomänen zu. Über CUDA Green Contexts startet es anschließend einen eigenen Kernel für jede Domäne. Die Recheneinheiten greifen dadurch auf näher gelegene Gewichte zu, statt sie wiederholt über das interne Speichernetz der GPU abzurufen.
Für die MoE-Schichten von MiniMax M3 meldet vLLM eine durchschnittliche Beschleunigung um den Faktor 1,2 bei Vorwärtsdurchläufen mit wenigen Tokens. Das Ergebnis galt für die Konfigurationen TP2, TP4, EP2 und EP4. TP steht für Tensorparallelismus, EP für Expertenparallelismus; die Zahl bezeichnet die Größe der Parallelgruppe.
Optionen für NVFP4, FP8-Attention und Expertenkommunikation
Das CuTe-DSL-Backend für dichte Matrixmultiplikation in NVFP4 lässt sich mit --linear-backend flashinfer_cutedsl auswählen. Bei NVFP4-Checkpoints ist es standardmäßig aktiviert. Den entsprechenden Kernel für MoE-Berechnungen in NVFP4 schaltet die separate Option --moe-backend flashinfer_cutedsl ein.
Den FP8-Attention-Pfad der TensorRT-LLM-Generation aktiviert die Einstellung --kv-cache-dtype fp8 in Kombination mit dem Backend FLASHINFER oder FLASHINFER_MLA. Das Attention-Backend wird über den Parameter --attention-backend ausgewählt.
Expertenparallelismus lässt sich mit --enable-expert-parallel zusammen mit --data-parallel-size N und --all2all-backend deepep_low_latency aktivieren. Diese Kombination schaltet auch die latenzarme DeepEP-Kommunikation und maskierte gruppierte GEMM für gebatchte Expertenformate ein.
Weitere Kernels für Rubin sind geplant
vLLM plant, die Unterstützung von Lokalitätsdomänen für MoE-Schichten auszubauen und einen FlashInfer-MegaMoE-Pfad für sm107 hinzuzufügen. Ebenfalls vorgesehen sind fusionierte Megakernels, die den Aufwand für Kernelstarts und den Speicher-Overhead verringern sollen.
Darüber hinaus plant das Projekt die an Rubin angepassten Attention-Kernels KDA, MLA, CSA und HCA. Sie sollen für die Modelle Kimi K3 und DeepSeek-V4.1-Flash ausgelegt sein.