Versuchen Sie sich daran zu erinnern, wann Sie zuletzt darüber nachgedacht haben, wie viel Speicherplatz moderne KI-Modelle benötigen. Wahrscheinlich nie, oder? Für Unternehmen, die diese Systeme betreiben, ist das jedoch ein alltägliches Kopfzerbrechen. Und Google hat nun eine Lösung vorgestellt, die den Speicherbedarf deutlich senken könnte.
Worin besteht eigentlich das Problem?
KI-Modelle arbeiten mit riesigen Mengen von Zahlen, die wir Vektoren nennen. Einen solchen Vektor kann man sich als detaillierte Beschreibung vorstellen, etwa davon, wie ein Foto aussieht, was ein bestimmtes Wort bedeutet oder welche Eigenschaften ein Datensatz hat. Je detaillierter die Beschreibung, desto mehr Zahlen und desto mehr Speicher werden benötigt. Und Speicher, insbesondere schneller Speicher, kostet Geld und hat seine Grenzen.
Eine der größten Bremsen heutiger KI-Modelle ist der sogenannte KV-Cache. Einfach ausgedrückt: ein schneller Notizspeicher, in dem das Modell fortlaufend Informationen ablegt, damit es nicht ständig langsame Speicher durchsuchen muss. Doch dieser Speicher verstopft. Vektoren sind schlichtweg groß und füllen ihn schnell.
Vektorquantisierung ist eine traditionelle Technik, die dieses Problem löst, indem sie Zahlen rundet und verkleinert. Herkömmliche Methoden haben jedoch einen Haken: Für jeden Datenblock müssen zusätzlich sogenannte Quantisierungskonstanten in voller Präzision gespeichert werden. Dadurch kommen pro Zahl noch 1 bis 2 Bits hinzu, und aus der ursprünglichen Einsparung wird plötzlich nur noch eine halb so große. Das ist, als wollten Sie Platz im Koffer sparen, doch die Liste der eingepackten Dinge würde selbst die Hälfte des Koffers einnehmen.
Drei Algorithmen und ein Ziel
Die Google-Forscher Amir Zandieh und Vahab Mirrokni haben eine Arbeit veröffentlicht, die dieses Problem gleich mit drei Algorithmen löst. Sie werden auf den renommierten Konferenzen ICLR 2026 und AISTATS 2026 vorgestellt.
TurboQuant ist der zentrale Algorithmus, der das gesamte Verfahren zusammenführt. Er arbeitet in zwei Schritten.
Zunächst kommt PolarQuant zum Einsatz. Dieser Algorithmus nimmt einen Datenvektor und wandelt ihn von klassischen Koordinaten (X, Y, Z) in sogenannte Polarkoordinaten um. Statt „Gehe 3 Blöcke nach Osten und 4 nach Norden“ heißt es dann „Gehe 5 Blöcke in einem Winkel von 37 Grad“. Das Ergebnis besteht aus zwei Größen: dem Radius (wie stark das jeweilige Signal ist) und dem Winkel (was das jeweilige Signal bedeutet). Und weil die Verteilung der Winkel vorhersehbar ist, muss das Modell keinerlei zusätzliche Konstanten speichern. Der Speicher-Overhead entfällt.
Danach kommt QJL (Quantized Johnson-Lindenstrauss) zum Einsatz. Es reduziert jede Zahl auf ein einziges Bit, konkret nur auf das Vorzeichen (+1 oder -1). Das klingt verrückt, doch die dahinterstehende Mathematik, die sogenannte Johnson-Lindenstrauss-Transformation, garantiert, dass wichtige Beziehungen zwischen den Daten erhalten bleiben. QJL wird dabei nur auf den kleinen Restfehler angewendet, den PolarQuant hinterlässt. Es dient als mathematisches Pflaster, das Verzerrungen beseitigt und das Ergebnis präzisiert.
Was leistet das in der Praxis?
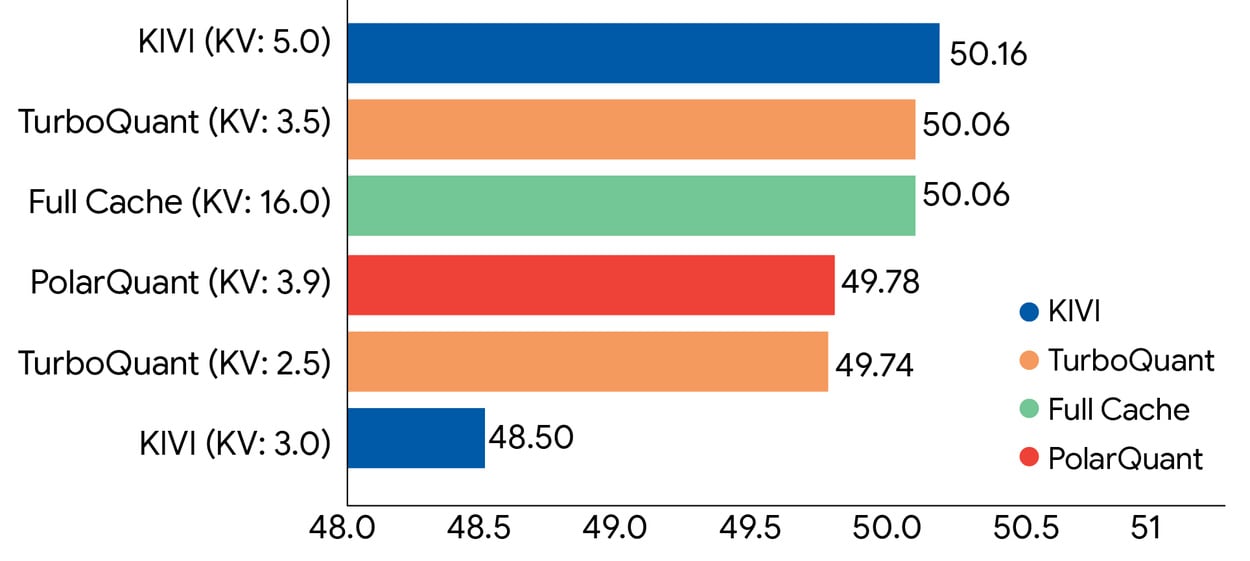
Die Testergebnisse sind ziemlich überzeugend. Die Forscher testeten alle drei Algorithmen auf den offenen Sprachmodellen Gemma und Mistral, und zwar anhand einer ganzen Reihe anspruchsvoller Tests zur Verarbeitung langer Texte. TurboQuant kann den KV-Cache auf lediglich 3 Bits komprimieren, ohne dass das Modell nachtrainiert werden muss und ohne merklichen Genauigkeitsverlust. Das ist entscheidend, denn bei anderen Kompressionsmethoden muss man üblicherweise eine geringere Qualität der Antworten in Kauf nehmen.
Die Geschwindigkeit? Die 4-Bit-Version von TurboQuant ist bis zu 8-mal schneller als die ursprüngliche unkomprimierte Version auf NVIDIA-H100-Grafikkarten. Achtmal. Auf derselben Hardware.
Und wie sieht es bei der gleichzeitigen Suche in Millionen von Vektoren aus, der sogenannten Vektorsuche, die große Suchmaschinen antreibt? TurboQuant schneidet besser ab als die konkurrierenden Methoden PQ und RabbiQ, obwohl diese Konkurrenzverfahren große Hilfstabellen verwenden und speziell auf konkrete Daten abgestimmt sind. TurboQuant benötigt das nicht und funktioniert universell.
Mehr als nur eine technische Spielerei
Google geht es offenbar um mehr als nur akademische Ergebnisse. TurboQuant zielt direkt auf die praktische Anwendung ab, konkret auf den Betrieb des eigenen Modells Gemini. Weniger Speicher bedeutet geringere Betriebskosten und die Möglichkeit, mehr Nutzer gleichzeitig zu bedienen.
Der gesamte Ansatz basiert auf soliden mathematischen Grundlagen und nicht nur auf einem empirischen „Wir haben es ausprobiert und es hat funktioniert“. Die Autoren weisen nach, dass die Algorithmen nahe am theoretischen Optimum arbeiten. Das ist wichtig für die Zuverlässigkeit in Produktionsumgebungen, in denen Ausfälle echtes Geld kosten.
Die Forschung entstand in Zusammenarbeit mit Experten von Google DeepMind, der New York University NYU und der südkoreanischen technischen Universität KAIST. Sie ist somit nicht das Werk eines einzelnen Teams, sondern das Ergebnis einer breiteren Zusammenarbeit innerhalb der Forschungswelt. In diesem Jahr werden wir auf den Konferenzen ICLR und AISTATS sehen, wie der Rest der Community auf diese Ergebnisse reagiert. Ich wette, dass es nicht still bleiben wird.