Probieren Sie Folgendes aus. Sie stellen einem Sprachmodell eine Frage, und die Antwort kommt, bevor Sie blinzeln können. Kein Warten, kein sich drehender Ladekreis. Genau das verspricht das Startup Taalas mit seinem ersten Produkt, und ehrlich gesagt, nach dem Lesen der Zahlen blieb mir kurz die Kinnlade offen.
Im Februar dieses Jahres trat Taalas aus der Geheimhaltung hervor und zeigte der Welt, woran es zweieinhalb Jahre lang im Stillen gearbeitet hatte. Ein Team von gerade einmal 24 Mitarbeitern, Gesamtausgaben von nur 30 Millionen Dollar aus den mehr als 200 Millionen, die bei Investoren eingesammelt wurden. Und das Ergebnis? Ein Chip, der nach unternehmenseigenen Messungen zehnmal schneller läuft als die derzeitige Marktspitze und in der Herstellung 20-mal günstiger ist.
Warum ist die heutige KI so langsam und teuer?
Um zu verstehen, was Taalas eigentlich getan hat, müssen wir uns ansehen, warum KI-Inferenz so problematisch ist. Moderne Sprachmodelle laufen auf riesigen GPU-Servern, die Hunderte Kilowatt Energie verbrauchen, Flüssigkeitskühlung benötigen und ganze Räume voller Kabel beanspruchen. Rechenzentren wachsen auf die Größe kleiner Städte an. Die Kosten schießen raketenartig in die Höhe. Und die Geschwindigkeit? Coding-Assistenten denken manchmal minutenlang nach. Der Entwickler verliert die Konzentration, der Flow ist dahin. Agentische KI-Anwendungen benötigen jedoch Reaktionszeiten im Millisekundenbereich, nicht im menschlichen Tempo.
Taalas sagt: Dieses System ist falsch konzipiert. Und das stimmt.
Revolutionäre Idee: das Modell direkt ins Silizium einbacken
Gründer und CEO Ljubisa Bajic vergleicht die Situation mit dem ENIAC-Computer aus dem Jahr 1945. Dieser mit Elektronenröhren vollgestopfte Koloss nahm einen ganzen Raum ein, war langsam und unerschwinglich teuer. Dann kam der Transistor, dann der PC, dann das Smartphone. Die Computertechnik wurde so klein und günstig, dass wir sie heute in der Tasche tragen.
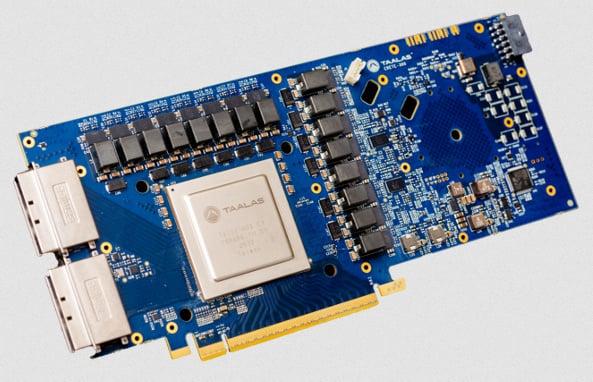
Taalas will dasselbe mit KI erreichen. Der Ansatz des Unternehmens unterscheidet sich radikal von allem, was auf dem Markt existiert. Statt das Modell per Software auf einem universellen Chip auszuführen, backt Taalas das gesamte Modell einschließlich seiner Gewichte physisch direkt ins Silizium ein. So entsteht ein Chip, der ausschließlich für ein einziges konkretes Modell entwickelt wurde. Das Unternehmen nennt ihn Hardcore Model.
Drei Prinzipien bilden die Grundlage: vollständige Spezialisierung, die Zusammenführung von Speicher und Rechenlogik auf einem einzigen Chip sowie eine radikale Vereinfachung des gesamten Hardware-Stacks. Kein HBM-Speicher, kein 3D-Stacking, keine Flüssigkeitskühlung. Nur eine klare, elegante Architektur.
Zahlen, die für sich sprechen
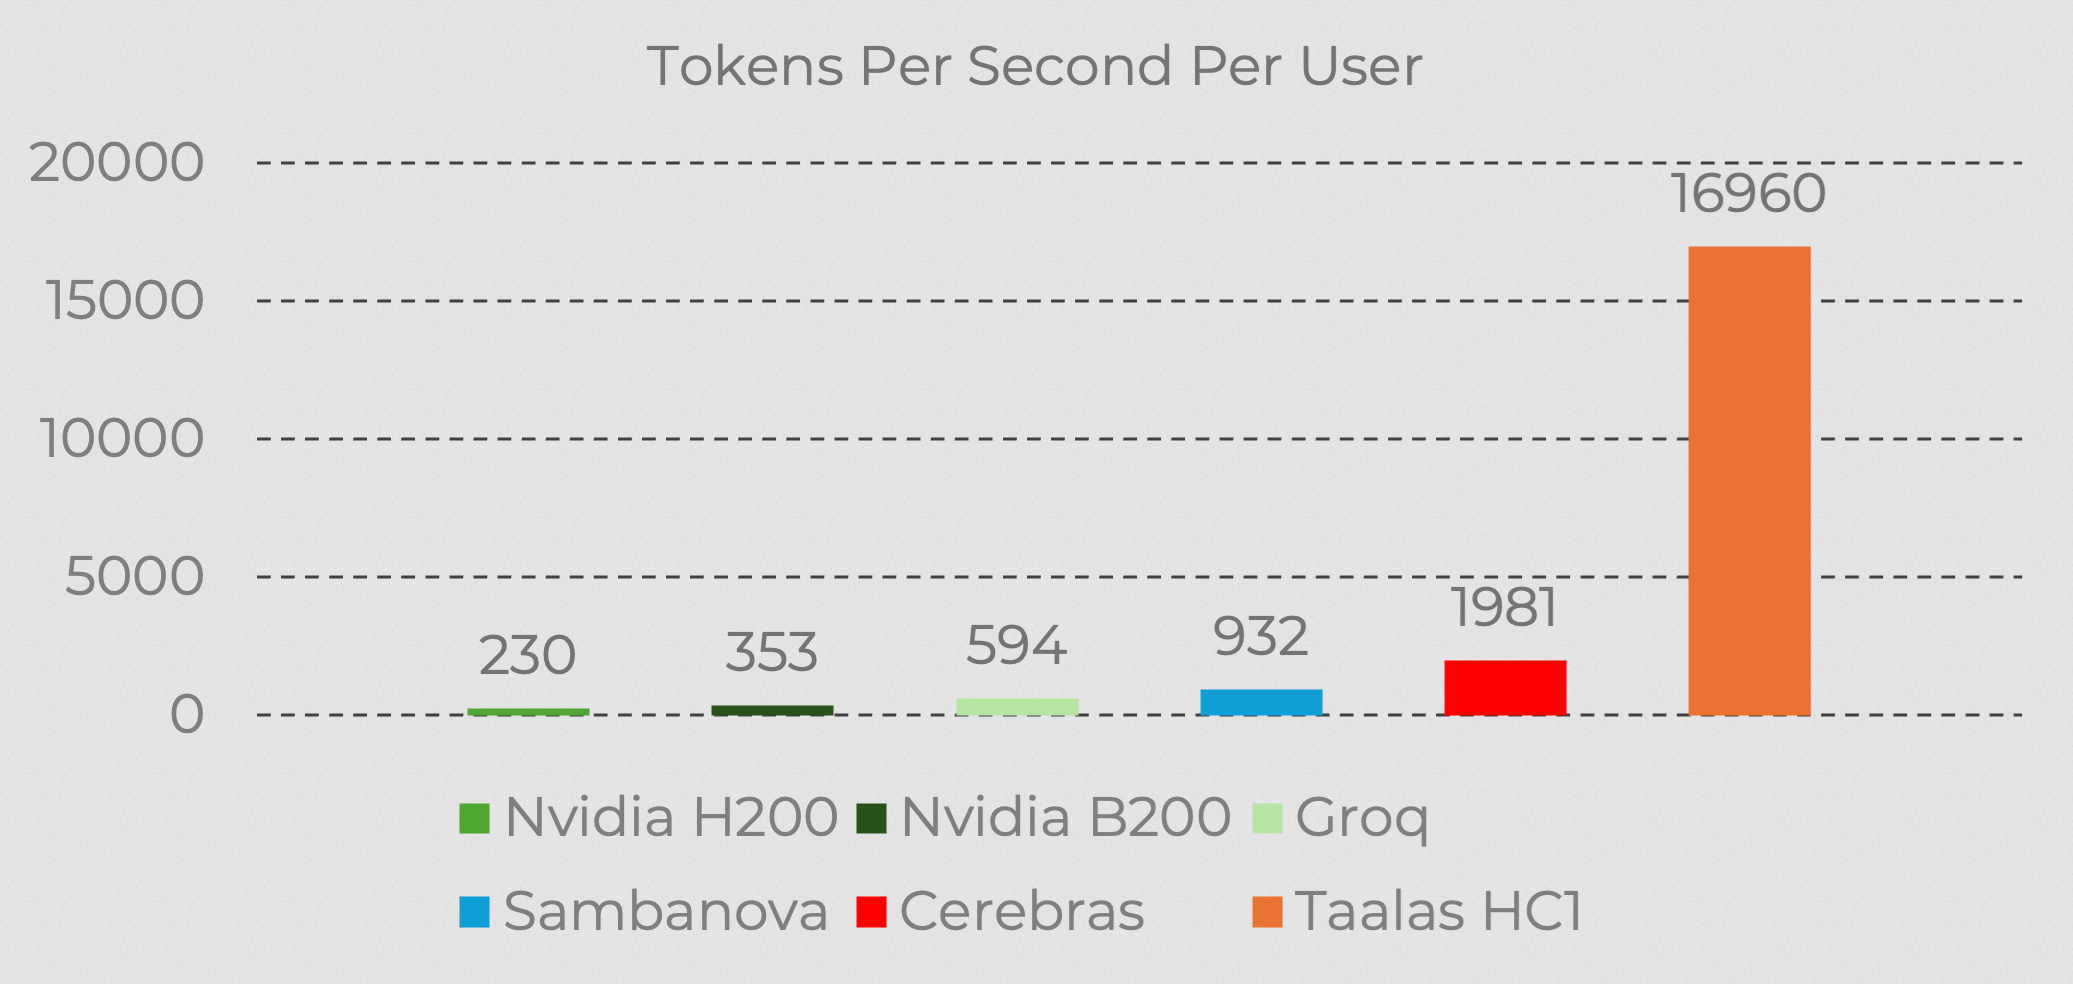
Das erste Produkt von Taalas ist eine Hardware-Implementierung des Modells Llama 3.1 8B von Meta. Die Ergebnisse sind, gelinde gesagt, verblüffend. 17.000 Token pro Sekunde und Nutzer. Zum Vergleich: Cerebras, die bislang schnellste Inferenzplattform der Welt, erreicht ungefähr ein Zehntel dieser Leistung. Nvidias H200-GPU? Zwei Größenordnungen darunter. Einer der ersten Tester beschrieb es mit einem Wort: „Wahnsinn.“
Der Energieverbrauch? 12 bis 15 kW pro Rack, während ein GPU-Rack 120 bis 600 kW benötigt. Zudem lässt sich ein Taalas-Rack mit Luft kühlen. Keine kostspieligen Umbauten von Rechenzentren. Der Preis pro Inferenz? 0,75 Cent pro Million Token für Llama 3.1 8B. GPUs kosten für dasselbe 20 bis 49 Cent. Das ist ein Sprung um eine ganze Größenordnung nach vorn!
Wie entsteht ein solcher Chip?
Taalas arbeitet mit TSMC zusammen, dem weltweit größten Chiphersteller. Der Basischip besteht aus etwa 100 Schichten und wird vorgefertigt. Wenn ein neues Modell erscheint, müssen lediglich zwei Metallschichten angepasst werden. Der gesamte Prozess dauert zwei Monate, während die Herstellung von Nvidia Blackwell etwa sechs Monate in Anspruch nimmt.
Dieser Ansatz löst eines der größten potenziellen Probleme: Was passiert, wenn sich das Modell ändert? Taalas behauptet, eine Aktualisierung innerhalb von zwei Monaten umsetzen zu können, nicht erst nach zwei Jahren. Im Kundenpreis sind drei Upgrades während der vierjährigen Lebensdauer des Chips enthalten.
Am 19. Februar gab das Unternehmen außerdem den Abschluss einer Finanzierungsrunde über 169 Millionen Dollar bekannt. Insgesamt hat es damit mehr als 219 Millionen Dollar von Investoren eingesammelt.
Kann Taalas Nvidia wirklich gefährlich werden?
Die Milliarden-Dollar-Frage. Oder vielmehr die Billionen-Dollar-Frage. Die Vorteile liegen auf der Hand: Geschwindigkeit, Preis und Energieverbrauch. Allerdings verwalten Rechenzentren nur ungern Dutzende verschiedener SKUs für unterschiedliche Modelle. Und Meta, dessen Llama-Modell Taalas als erstes ins Silizium einbackt, hat gerade eine „generationenübergreifende“ Partnerschaft mit Nvidia unterzeichnet. Offensichtlich konnte Taalas das Unternehmen nicht davon überzeugen, zu einem anderen Anbieter zu wechseln.
Taalas gibt jedoch nicht auf. Der Plan sieht für das Frühjahr 2026 ein mittelgroßes Reasoning-LLM und bis zum Jahresende ein Frontier-Modell auf der zweiten Chipgeneration HC2 vor. HC2 soll eine höhere Dichte, standardisierte 4-Bit-Formate und eine noch höhere Leistung bieten. Wenn es dem Unternehmen gelingt, große Rechenzentren zu überzeugen, könnte der Markt für KI-Hardware in seinen Grundfesten erschüttert werden.