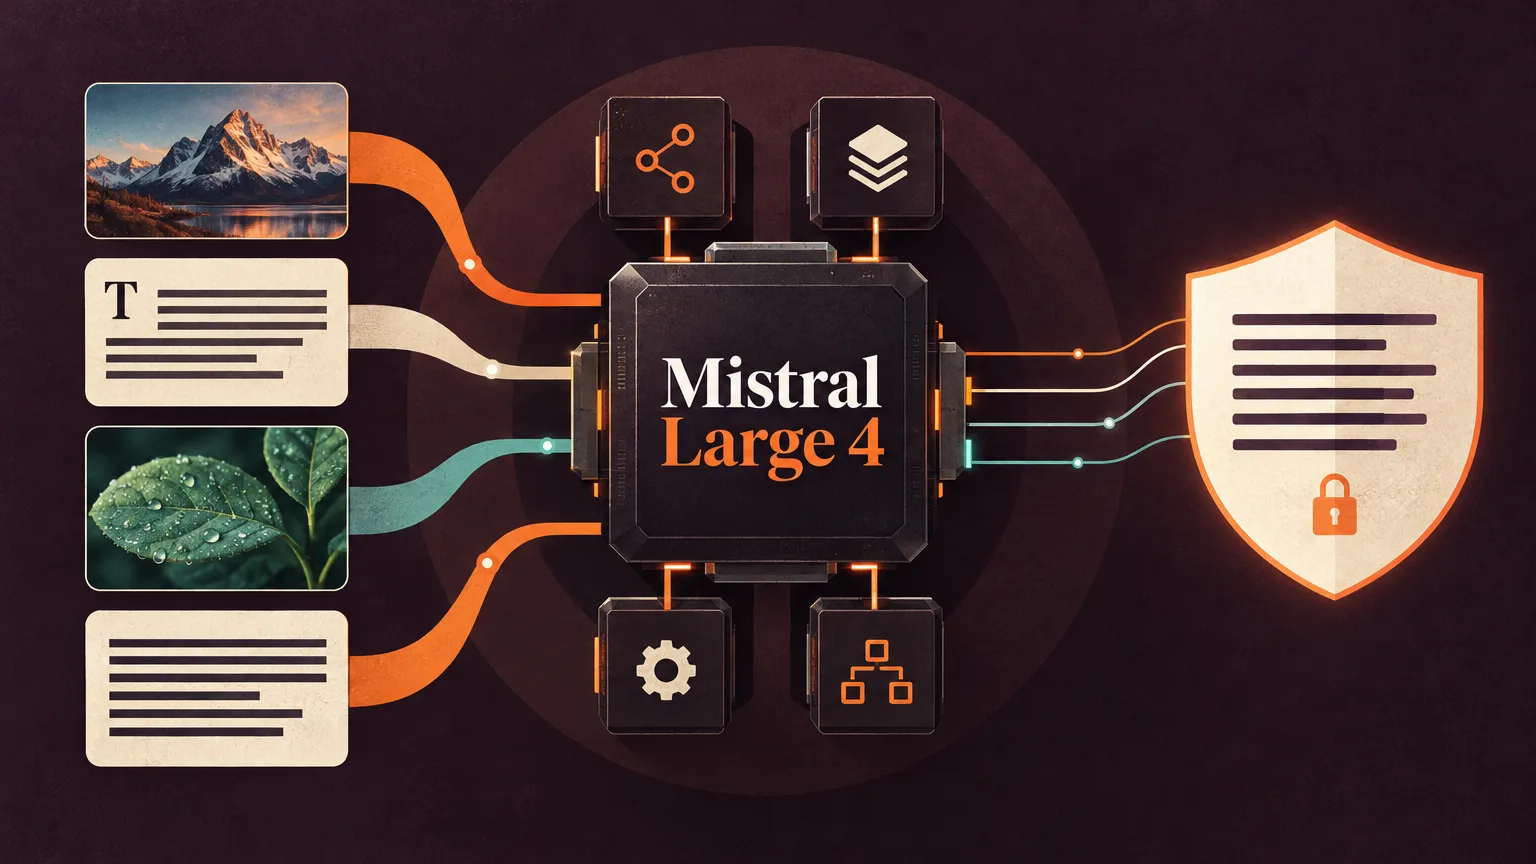
Mistral hat Large 4 veröffentlicht, ein mehrsprachiges Modell mit offenen Gewichten, das Text und Bilder verarbeitet und Text erzeugt. Das Modell mit dem Spitznamen Le Chonk besitzt ein Kontextfenster von einer Million Token und richtet sich vor allem an die defensive Cybersicherheit. Entwickler können es selbst oder über einen entfernten Dienst betreiben.
Bildeingabe und Expertenarchitektur
Large 4 hat rund eine Billion Parameter, von denen 49 Milliarden aktiv sind. Für die Verarbeitung von Bildern nutzt es den Pixtral-Bildencoder; daneben kombiniert es Expertennetzwerke mit Sparse Attention.
Laut Hugging Face wählt das Modell für jedes Token vier von 128 Experten aus und verwendet zusätzlich einen gemeinsam genutzten Experten.
Ergebnisse bei Sicherheit und Programmierung
In einem Teil des Artificial Analysis Cyber Index, bei dem eine echte Schwachstelle in Open-Source-Software reproduziert und anschließend behoben werden muss, erreichte das Modell laut Hugging Face 82 Prozent. Nach Angaben von Mistral war Large 4 in internen Tests auch bei der Malware-Analyse, der Priorisierung von Schwachstellen und dem Schreiben von Erkennungsregeln nützlich. Für diese Aufgaben war es nicht ausdrücklich trainiert worden.
Hugging Face nennt zudem eine Erfolgsquote von 93 Prozent bei 40 Aufgaben aus Sicherheitswettbewerben im Benchmark Cybench und eine Angriffsresistenz von 93,3 Prozent im Test Lakera B3. Bei Cyber-Anfragen aus JailbreakBench, StrongREJECT und AgentHarm lag die durchschnittliche Ablehnungsrate des Modells laut Hugging Face höher als bei den anderen getesteten Modellen mit offenen Gewichten.
In Programmierbenchmarks erreichte Large 4 laut Hugging Face 61,7 Prozent in DeepSWE v1.1, 59,4 Prozent in SWE-Atlas-QnA und 28,3 Prozent in Terminal-Bench 4. Sein Gesamtergebnis von 49,8 Prozent im Coding Agent Index liegt vor DeepSeek V4 Pro 0813 und Qwen3.8 Max.
Für Tests von Unternehmensabläufen und längerfristigen beruflichen Aufgaben nennt Hugging Face 59,9 Prozent in AutomationBench und 1.393 Elo in AA-Briefcase.
Varianten und Einsatzmöglichkeiten
Die offiziellen Gewichte sind in den Varianten FP8 und NVFP4 verfügbar. Für die Verbreitung gilt die Mistral Ecosystem Open-Weight License, die Angebote des Modells als Dienst einschränkt. Unsloth und das llama.cpp-Team haben außerdem Versionen im GGUF-Format erstellt.
Seit der Veröffentlichung unterstützen die Bibliotheken Transformers, vLLM und llama.cpp das Modell. Die Variante NVFP4 benötigt weniger Speicher und setzt bei der Nutzung mit vLLM NVIDIA-Blackwell-GPUs voraus. Die Zwei-Bit-Quantisierungen des llama.cpp-Teams lassen sich laut Hugging Face auf einem einzelnen Apple-Silicon-Ultra-Computer mit 512 GB gemeinsamem Speicher ausführen; die übrigen genannten Quantisierungen erfordern verteilte Inferenz.
Für den entfernten Betrieb bietet Hugging Face Inference Endpoints an; serverlose Inferenz ist über Inference Providers verfügbar. Eine vorbereitete Konfiguration für Inference Endpoints nutzt FP8-Gewichte auf acht NVIDIA-H200-GPUs, unterstützt einen Kontext von bis zu 131.000 Token und verarbeitet bis zu 16 Anfragen gleichzeitig. Ihre API akzeptiert Bilder und unterstützt Werkzeugaufrufe, strukturierte Ausgaben und Streaming.
Reasoning einstellen und Modell nachtrainieren
Der Reasoning-Aufwand lässt sich auf low, medium oder high einstellen; standardmäßig gilt high. Abschalten lässt sich das Reasoning nicht: Auch bei der Einstellung none wird high verwendet.
Seit der Veröffentlichung wird auch das Nachtrainieren mit TRL unterstützt. Ein Beispiel von Hugging Face verwendet die FP8-Variante auf einem Knoten mit acht B300-GPUs und trainiert das Modell darauf, in der durch den System-Prompt vorgegebenen Sprache zu schlussfolgern.