Das chinesische Unternehmen Moonshot AI hat das neue KI-Modell Kimi K3.1 Pro veröffentlicht. Eigenen Tests zufolge liegt es beim Programmieren knapp hinter dem Modell Claude Opus 5.5 von Anthropic und übertrifft bei einigen Aufgaben GPT-6 Astra von OpenAI. Das Unternehmen bietet es deutlich günstiger als die vorherige Version an und verspricht, bis zum 4. November die sogenannten offenen Gewichte zu veröffentlichen. Das bedeutet, dass jeder das Modell herunterladen und auf eigenen Servern betreiben kann, ohne von den Diensten von Moonshot abhängig zu sein.
Deutlich mehr Training
Es handelt sich um eine verbesserte Version des letztjährigen Modells Kimi K3, die das Unternehmen einem wesentlich längeren und anspruchsvolleren Nachtraining unterzogen hat. Das Modell lernte durch Versuch und Irrtum in Hunderten verschiedener Bereiche, vom Programmieren über Finanzen bis hin zur Arbeit mit 3D-Grafiken. Damit ein solches Training zuverlässig funktioniert, mussten die Ingenieure bei Moonshot praktisch die gesamte Infrastruktur überarbeiten – von der Recheninfrastruktur bis zu sicheren Testumgebungen, in denen das Modell seine Lösungen erprobt.
Es gehört zur Kategorie der riesigen Modelle mit rund drei Billionen Parametern. Es kann mit einem Kontext von einer Million Token arbeiten, was vereinfacht gesagt bedeutet, dass es sich ganze umfangreiche Dokumente oder große Softwareprojekte auf einmal merken kann. Neben der Standardversion hat das Unternehmen auch die Variante Highspeed veröffentlicht, die zwei- bis dreimal schneller antwortet.
Ausdauer nicht nur beim Programmieren
Moonshot richtet das Modell vor allem auf das Programmieren und auf langwierige Aufgaben aus, bei denen die KI selbstständig Schritt für Schritt vorgehen muss. Kimi K3.1 Pro behebt Fehler in echtem Code, erstellt komplette Projekte und kann mit den Spiele-Engines Unity, Unreal Engine und Godot arbeiten. Die von ihm erstellten Websites und interaktiven 3D-Szenen weisen dem Unternehmen zufolge eine bessere Komposition, Typografie und Animationen auf.
Wie weit seine Ausdauer reicht, zeigt ein Versuch des Unternehmens. Das Modell erhielt die Aufgabe, einem simulierten Menschen das Gehen beizubringen. Es arbeitete mit einem offenen anatomischen Modell des menschlichen Körpers, das 296 Skelettelemente und 402 Muskeln umfasst. Im Verlauf von 167 Aufgaben und 420 Kontrollen wertete es selbstständig die Ergebnisse aus, suchte nach Fehlern und passte die Bewegungssteuerung an. Die Figur, die anfangs nach wenigen Sekunden zusammenbrach, ging schließlich mehr als 11 Sekunden lang flüssig mit abwechselnden Schritten. Als sich die Armbewegung nicht verbessern ließ, versuchte das Modell nicht endlos dasselbe. Es überprüfte die Simulation selbst, entdeckte 36 Fehler in den Berechnungen der Schultermuskulatur, behob sie und startete erst dann das Training erneut.
3D-Modelle auf Abruf
Eine Stärke des neuen Modells ist die räumliche Verarbeitung. Aus einer Textvorgabe, einer Skizze oder einem Foto kann es die Form und die Proportionen eines Gegenstands ableiten und ein brauchbares 3D-Modell erstellen. Besonders gut gelingt ihm das bei Maschinenbauteilen, Architekturmodellen oder maßgefertigten Möbeln. Es kann selbstständig Skripte für Programme wie Blender oder CAD-Software schreiben und ausführen und das Modell darin weiterbearbeiten.
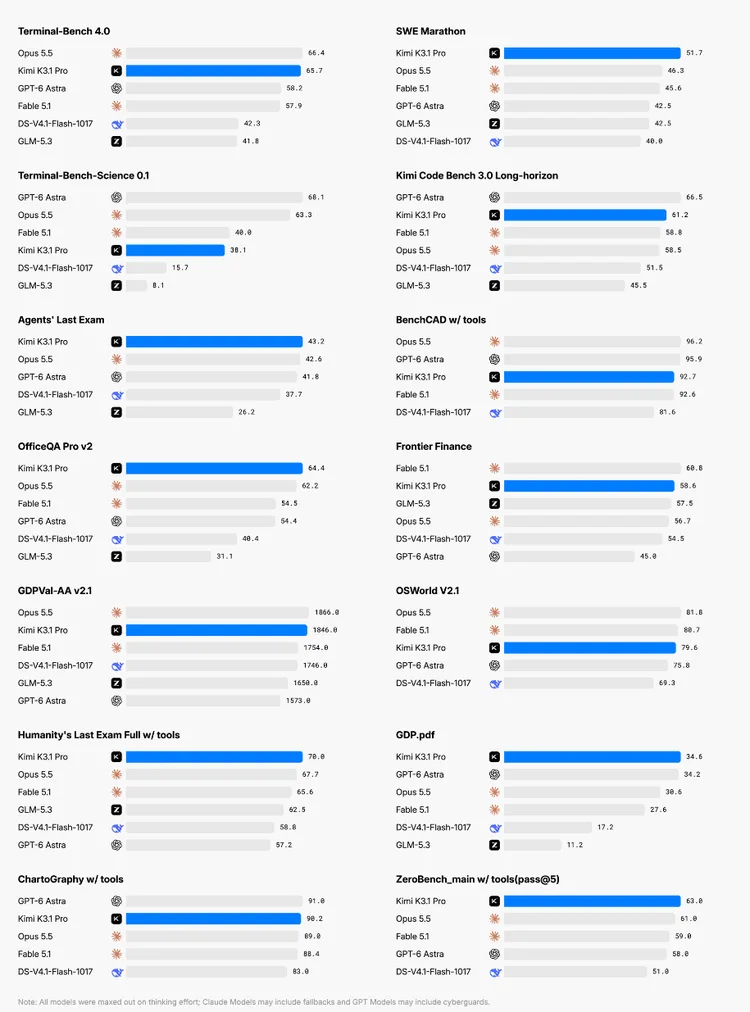
Im Test BenchCAD, der die Genauigkeit der Rekonstruktion von 3D-Objekten anhand von Bildern aus mehreren Blickwinkeln untersucht, erreichte es fast 93 Prozent. Claude Opus 5.5 und GPT-6 Astra schneiden etwas besser ab; beide liegen bei rund 96 Prozent. Gleichzeitig hat das Unternehmen auf der Website und in der App die Funktion 3D Make eingeführt, mit der Nutzer 3D-Modelle ansehen, bearbeiten, für den 3D-Druck herunterladen oder als Video exportieren können.
Finanzen und weniger Halluzinationen
Moonshot hat das Modell auch intensiv auf Finanzanalysen trainiert. Im Test OfficeQA Pro v2, bei dem die KI Zahlen in echten Finanzdokumenten sucht und überprüft, erzielte es das beste Ergebnis aller verglichenen Modelle. In internen Tests verbesserte es sich gegenüber der Version K3 um rund 7 Punkte bei der Finanzmodellierung und um knapp 12 Punkte bei der Finanzrecherche. Bei der simulierten Führung eines Unternehmens schnitt es ungefähr viermal besser ab als sein Vorgänger.
Im Finanzwesen ist Genauigkeit entscheidend, weshalb sich die Entwickler auch darauf konzentrierten, Halluzinationen zu reduzieren. In einem internen Stresstest voller Fangfragen sank der Anteil erfundener Aussagen von mehr als 23 Prozent bei K3 auf rund 8 Prozent. Das Unternehmen weist allerdings darauf hin, dass der Test absichtlich besonders anspruchsvoll angelegt ist und diese Zahlen nicht der gewöhnlichen Nutzung entsprechen. GPT-6 Astra machte dabei die wenigsten Fehler.
Hacking-Fähigkeiten wurden vom Unternehmen absichtlich eingeschränkt
Mit den wachsenden Fähigkeiten des Modells nahm auch die Sorge zu, dass es für Angriffe auf Software missbraucht werden könnte. Die Entwickler stellten fest, dass Fähigkeiten zum Auffinden und Ausnutzen von Sicherheitslücken unbemerkt aus gewöhnlichen Trainingsdaten in das Modell gelangten. Für die zum Herunterladen bestimmte Version entfernten sie diese Daten daher gezielt.
Der Unterschied ist deutlich. Die unveränderte Version löste in einem internen Test zu Softwareangriffen mehr als 90 Prozent der Aufgaben, der fertige K3.1 Pro dagegen 81 Prozent. Moonshot erklärt, dass das Modell in diesem Bereich absichtlich hinter den besten geschlossenen Modellen der Konkurrenz zurückbleibt. Zugleich ist das Unternehmen überzeugt, dass das frei verfügbare Modell vor allem denjenigen helfen wird, die ihre eigene Software absichern möchten, einschließlich älterer Systeme.
Vergleich mit der Konkurrenz
Im Test Terminal-Bench 4.0, der die Ausführung realer Aufgaben in der Befehlszeile untersucht, erzielte K3.1 Pro knapp 66 Prozent. Damit übertraf es GPT-6 Astra mit 58 Prozent und blieb nur knapp hinter Claude Opus 5.5 zurück, das 66,4 Prozent erreicht. In einem internen Test langwieriger Programmieraufgaben verbesserte es sich gegenüber K3 von 56 auf 61 Prozent.
Die meisten Messungen führte allerdings Moonshot selbst durch, und die verglichenen Modelle arbeiteten nicht immer mit denselben Werkzeugen. Einen unabhängigeren Blick bietet das Unternehmen Artificial Analysis, das dem Modell in seinem Intelligenzindex 55 Punkte verlieh. Damit gehörte es zum Zeitpunkt der Veröffentlichung zur absoluten Spitze.
Der Preis ist das wichtigste Verkaufsargument
Das stärkste Argument für das neue Modell ist der Preis. Die Standardversion kostet über die API 2 Dollar pro Million Eingabe-Token und 10 Dollar pro Million Ausgabe-Token. Wenn sich Textteile wiederholen und das Modell sie im Cache gespeichert hat, sinkt der Eingabepreis auf 20 Cent. Das vorherige K3 kostete 3 beziehungsweise 15 Dollar, das neue Modell ist also um ein Drittel günstiger. Dem Entwickler und Blogger Simon Willison zufolge kostet es damit genauso viel wie GPT-6.1 Sol und halb so viel wie Claude Opus 5.5.
Die schnellere Variante Highspeed kostet doppelt so viel, also 4 Dollar für die Eingabe und 20 Dollar für die Ausgabe. Der Preis für Text aus dem Cache bleibt gleich. Hinsichtlich Intelligenz und Kontextgröße unterscheiden sich die beiden Versionen nicht. Highspeed ist daher dort sinnvoll, wo ein Mensch auf die Antwort wartet, beispielsweise bei Programmierassistenten oder im Kundensupport.
Verfügbarkeit
Kimi K3.1 Pro ist auf der Website Kimi.ai sowie in mobilen Apps für iOS, Android und HarmonyOS verfügbar. Es kann außerdem in der Desktop-Anwendung Kimi Work ab Version 3.1.0 für Windows und Macs mit Apple-Chips, im Programmierwerkzeug Kimi Code über den Befehl /model sowie über die API unter den Bezeichnungen kimi-k3.1-pro und kimi-k3.1-pro-highspeed verwendet werden. API-Kunden können einen Modus aktivieren, in dem das Unternehmen ihre Daten nicht speichert, und das Modell wird auch vom Dienst OpenRouter angeboten. In der Unternehmensversion von Kimi ist das neue Modell standardmäßig deaktiviert und muss vom Administrator der Organisation freigeschaltet werden.