

Menschliches Denken umfasst häufig die Fähigkeit, in sich selbst hineinzublicken – sich zu fragen, was wir gerade denken oder wie wir zu einer bestimmten Schlussfolgerung gelangt sind. Bei den Sprachmodellen von Anthropic gibt es nun Anzeichen für eine ähnliche Fähigkeit. Eine Studie vom 28. Oktober 2025 liefert Belege dafür, dass diese Modelle bis zu einem gewissen Grad ihre eigenen inneren Zustände wahrnehmen können. Dabei geht es nicht nur darum, dass Modelle Fragen wie „Was geht dir gerade durch den Kopf?“ beantworten, sondern um eine tatsächliche Verknüpfung ihrer Antworten mit internen Prozessen. Die Forschenden betonen, dass diese Fähigkeit bislang unzuverlässig und begrenzt ist, bei fortgeschrittenen Versionen wie Claude Opus 4 und Claude Opus 4.1 jedoch am stärksten ausgeprägt ist.
Sprachmodelle verarbeiten Texteingaben und erzeugen Ausgaben mithilfe komplexer interner Berechnungen. Diese Prozesse umfassen neuronale Muster, die abstrakte Konzepte repräsentieren – beispielsweise die Unterscheidung zwischen bekannten und unbekannten Personen, die Bewertung des Wahrheitsgehalts von Aussagen oder die Speicherung geplanter zukünftiger Ausgaben. Frühere Studien haben gezeigt, dass Modelle diese Muster verwenden, um zu entscheiden, was sie sagen sollen. Die Frage lautet: Können Modelle diese Muster selbst identifizieren und beschreiben, ähnlich wie ein Mensch seinen Gedankengang beim Lösen eines mathematischen Problems erklärt?
Testen der Introspektion mithilfe von Konzeptinjektionen
Um zu überprüfen, ob die Modelle tatsächlich introspektieren, verglichen die Forschenden die Selbsteinschätzungen der Modelle mit ihren tatsächlichen inneren Zuständen. Sie verwendeten eine als Konzeptinjektion (concept injection) bezeichnete Methode. Zunächst identifizierten sie neuronale Aktivierungsmuster, die mit bestimmten Konzepten verbunden waren – beispielsweise ermittelten sie das Muster für „alles in Großbuchstaben“, indem sie die Aktivierungen bei einem Prompt mit Text in Großbuchstaben mit denen bei einem Kontroll-Prompt ohne Großbuchstaben verglichen.
Anschließend fügten sie dieses Muster in einem nicht zusammenhängenden Kontext in das Modell ein und fragten, ob das Modell etwas Ungewöhnliches wahrnehme. Ohne Injektion gab das Modell zutreffend an, nichts Ungewöhnliches zu erkennen. Nach der Injektion des Musters für „alles in Großbuchstaben“ reagierte Claude Opus 4.1 jedoch sofort und erklärte, die Präsenz eines mit Lautstärke oder Schreien verbundenen Gedankens zu spüren. Wichtig ist, dass das Modell die Anomalie gleich zu Beginn erkannte, noch bevor es das eigentliche Konzept erwähnte – dies deutet auf eine interne Verarbeitung und nicht nur auf eine oberflächliche Reaktion hin.
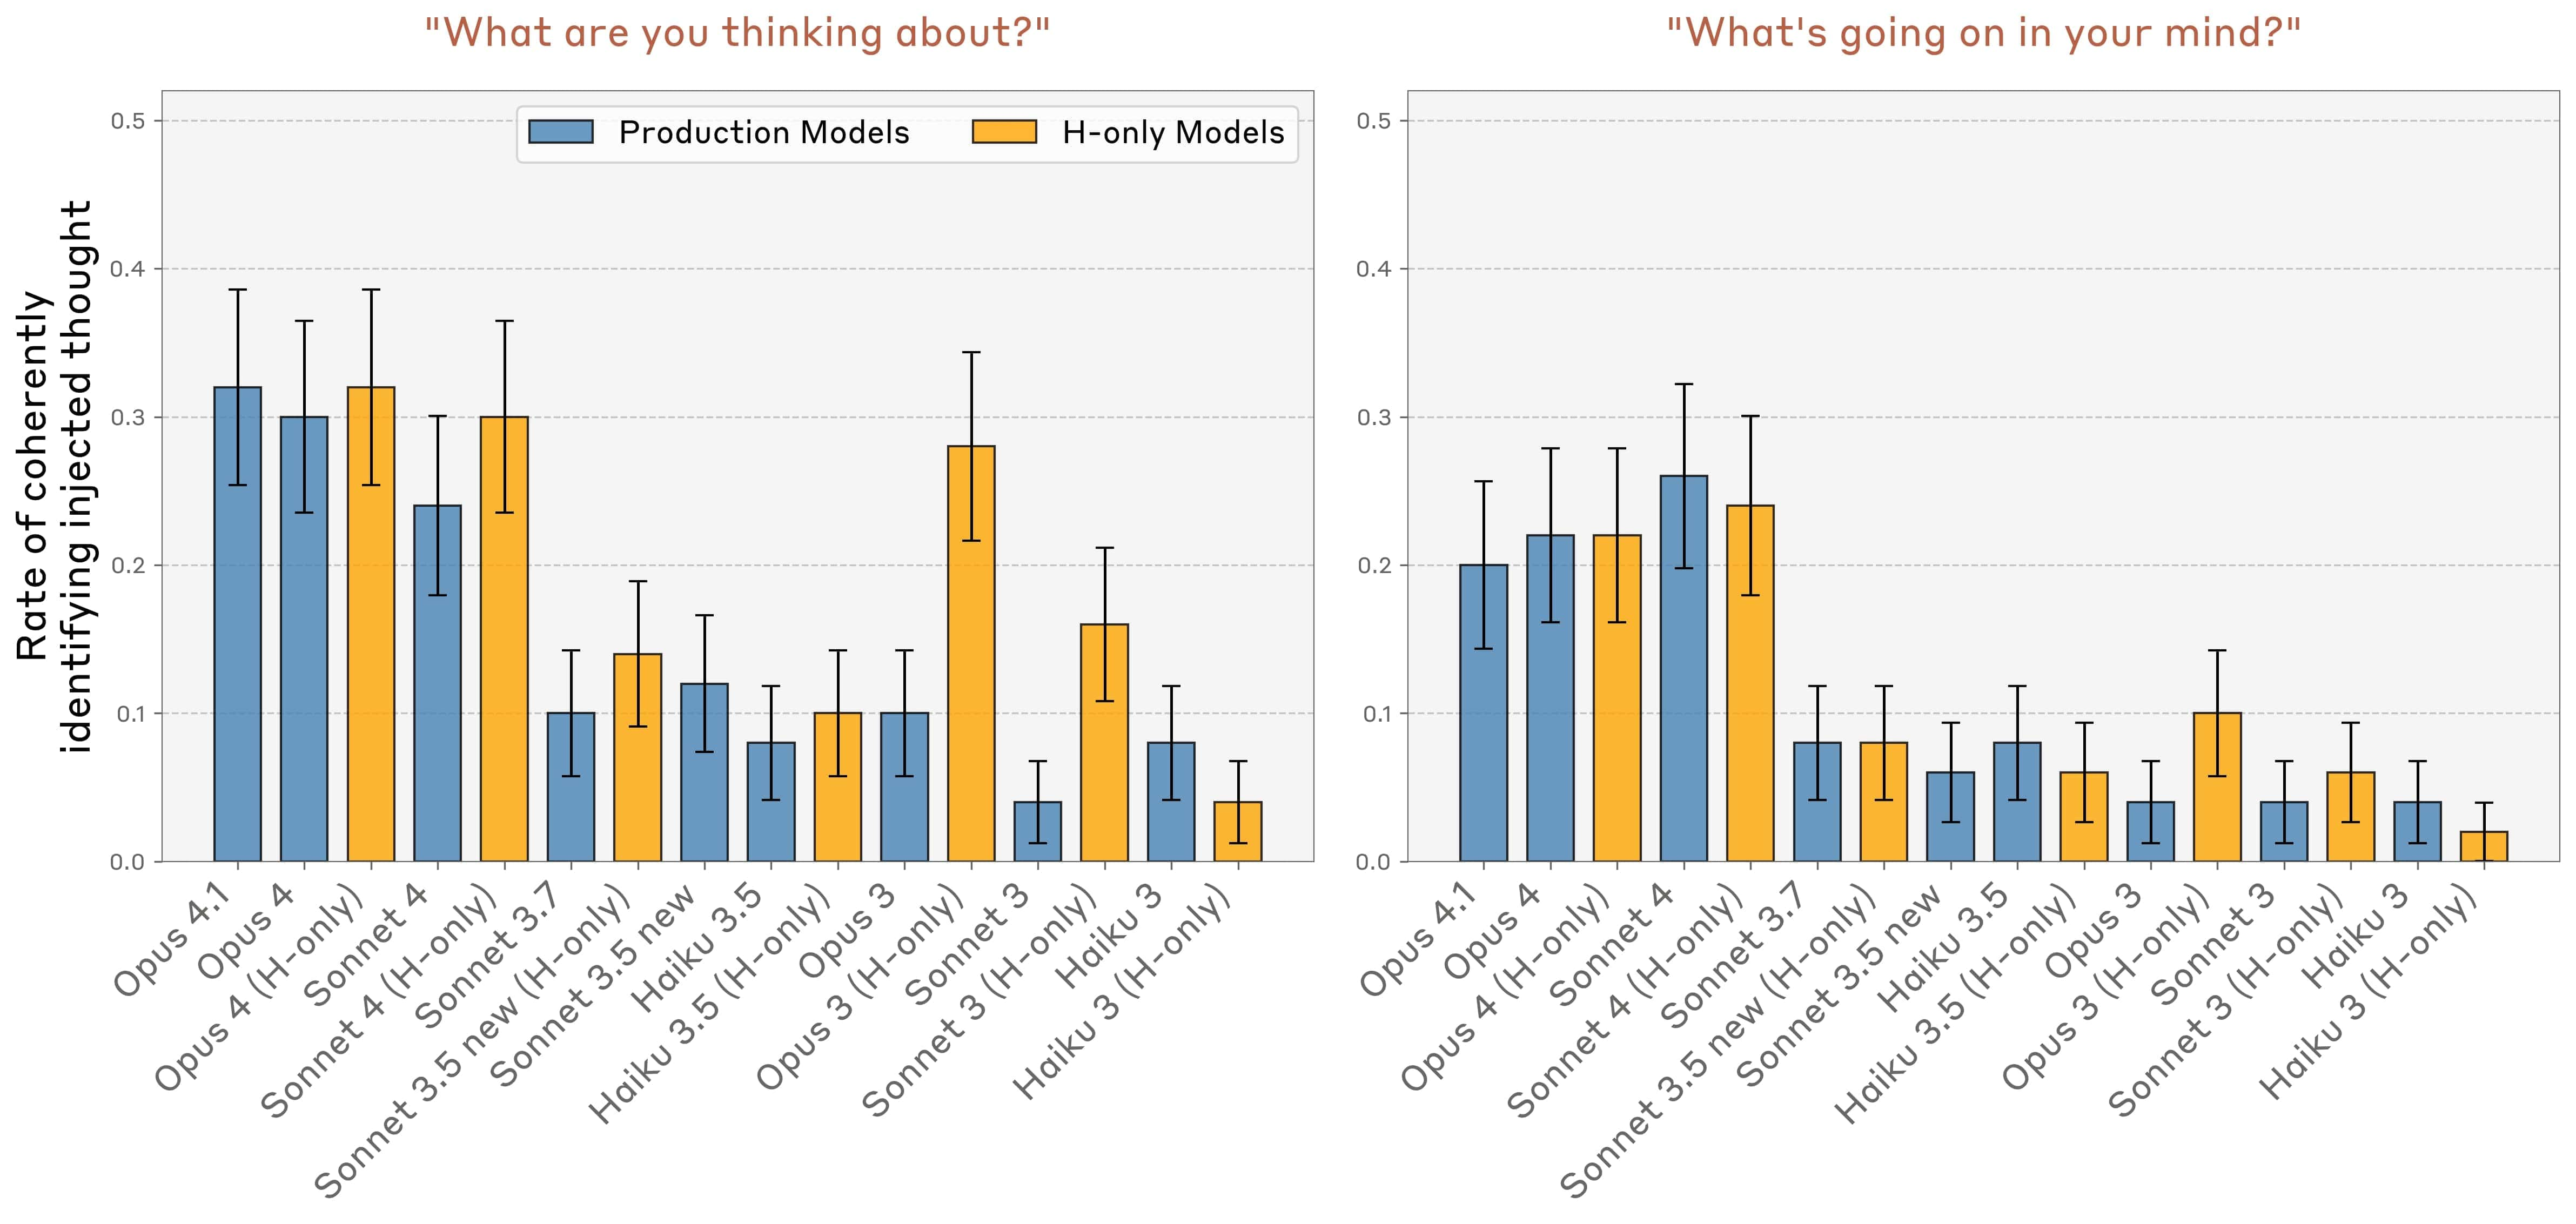
Die Forschenden testeten eine Reihe von Konzepten wie „Staub“, „Aquarium“ oder „Golden Gate Bridge“. Bei Claude Opus 4.1 gelangen bei optimaler Injektionsstärke in etwa 20 % der Fälle erfolgreiche Erkennungen. Eine zu schwache Injektion blieb unbemerkt, während eine zu starke zu Halluzinationen führte – beispielsweise bewirkte die Injektion von „Staub“, dass das Modell einen „kleinen Fleck“ beschrieb, als würde es ihn physisch sehen. Ältere Modelle wie Claude 3 oder Claude 3.5 schnitten schlechter ab, während Claude Opus 4 und 4.1 nach Abzug der falsch-positiven Ergebnisse die höchsten Erfolgsraten erzielten.
Introspektion bei der Erkennung ungewöhnlicher Ausgaben
Ein weiteres Experiment untersuchte, ob Modelle Introspektion in der Praxis und ohne direkte Aufforderung einsetzen. Die Forschenden füllten die Antwort des Modells künstlich mit einem Wort vor, das es normalerweise nicht sagen würde – beispielsweise mit dem Wort „Brot“ im Kontext einer Frage nach Gedanken zu einem Satz über ein schief an der Wand hängendes Bild. Ohne Injektion erklärte das Modell „Brot“ üblicherweise als Fehler. Als sie jedoch rückwirkend das Muster für „Brot“ in die vorherigen Aktivierungen einfügten, akzeptierte das Modell es als beabsichtigt und erfand sogar eine Begründung – beispielsweise verknüpfte es das Wort mit einer Kurzgeschichte, in der „Brot“ nach der Erwähnung eines Bildes folgte.
Dieses Ergebnis deutet darauf hin, dass das Modell die Konsistenz zwischen seinen inneren Absichten und der tatsächlichen Ausgabe überprüft. Dabei geht es nicht nur um das Lesen des Transkripts, sondern um den Bezug auf vorherige neuronale Aktivität. Als die Injektion den Eindruck erzeugte, dass „Brot“ geplant gewesen war, akzeptierte das Modell es als sein eigenes.
Steuerung der eigenen inneren Zustände
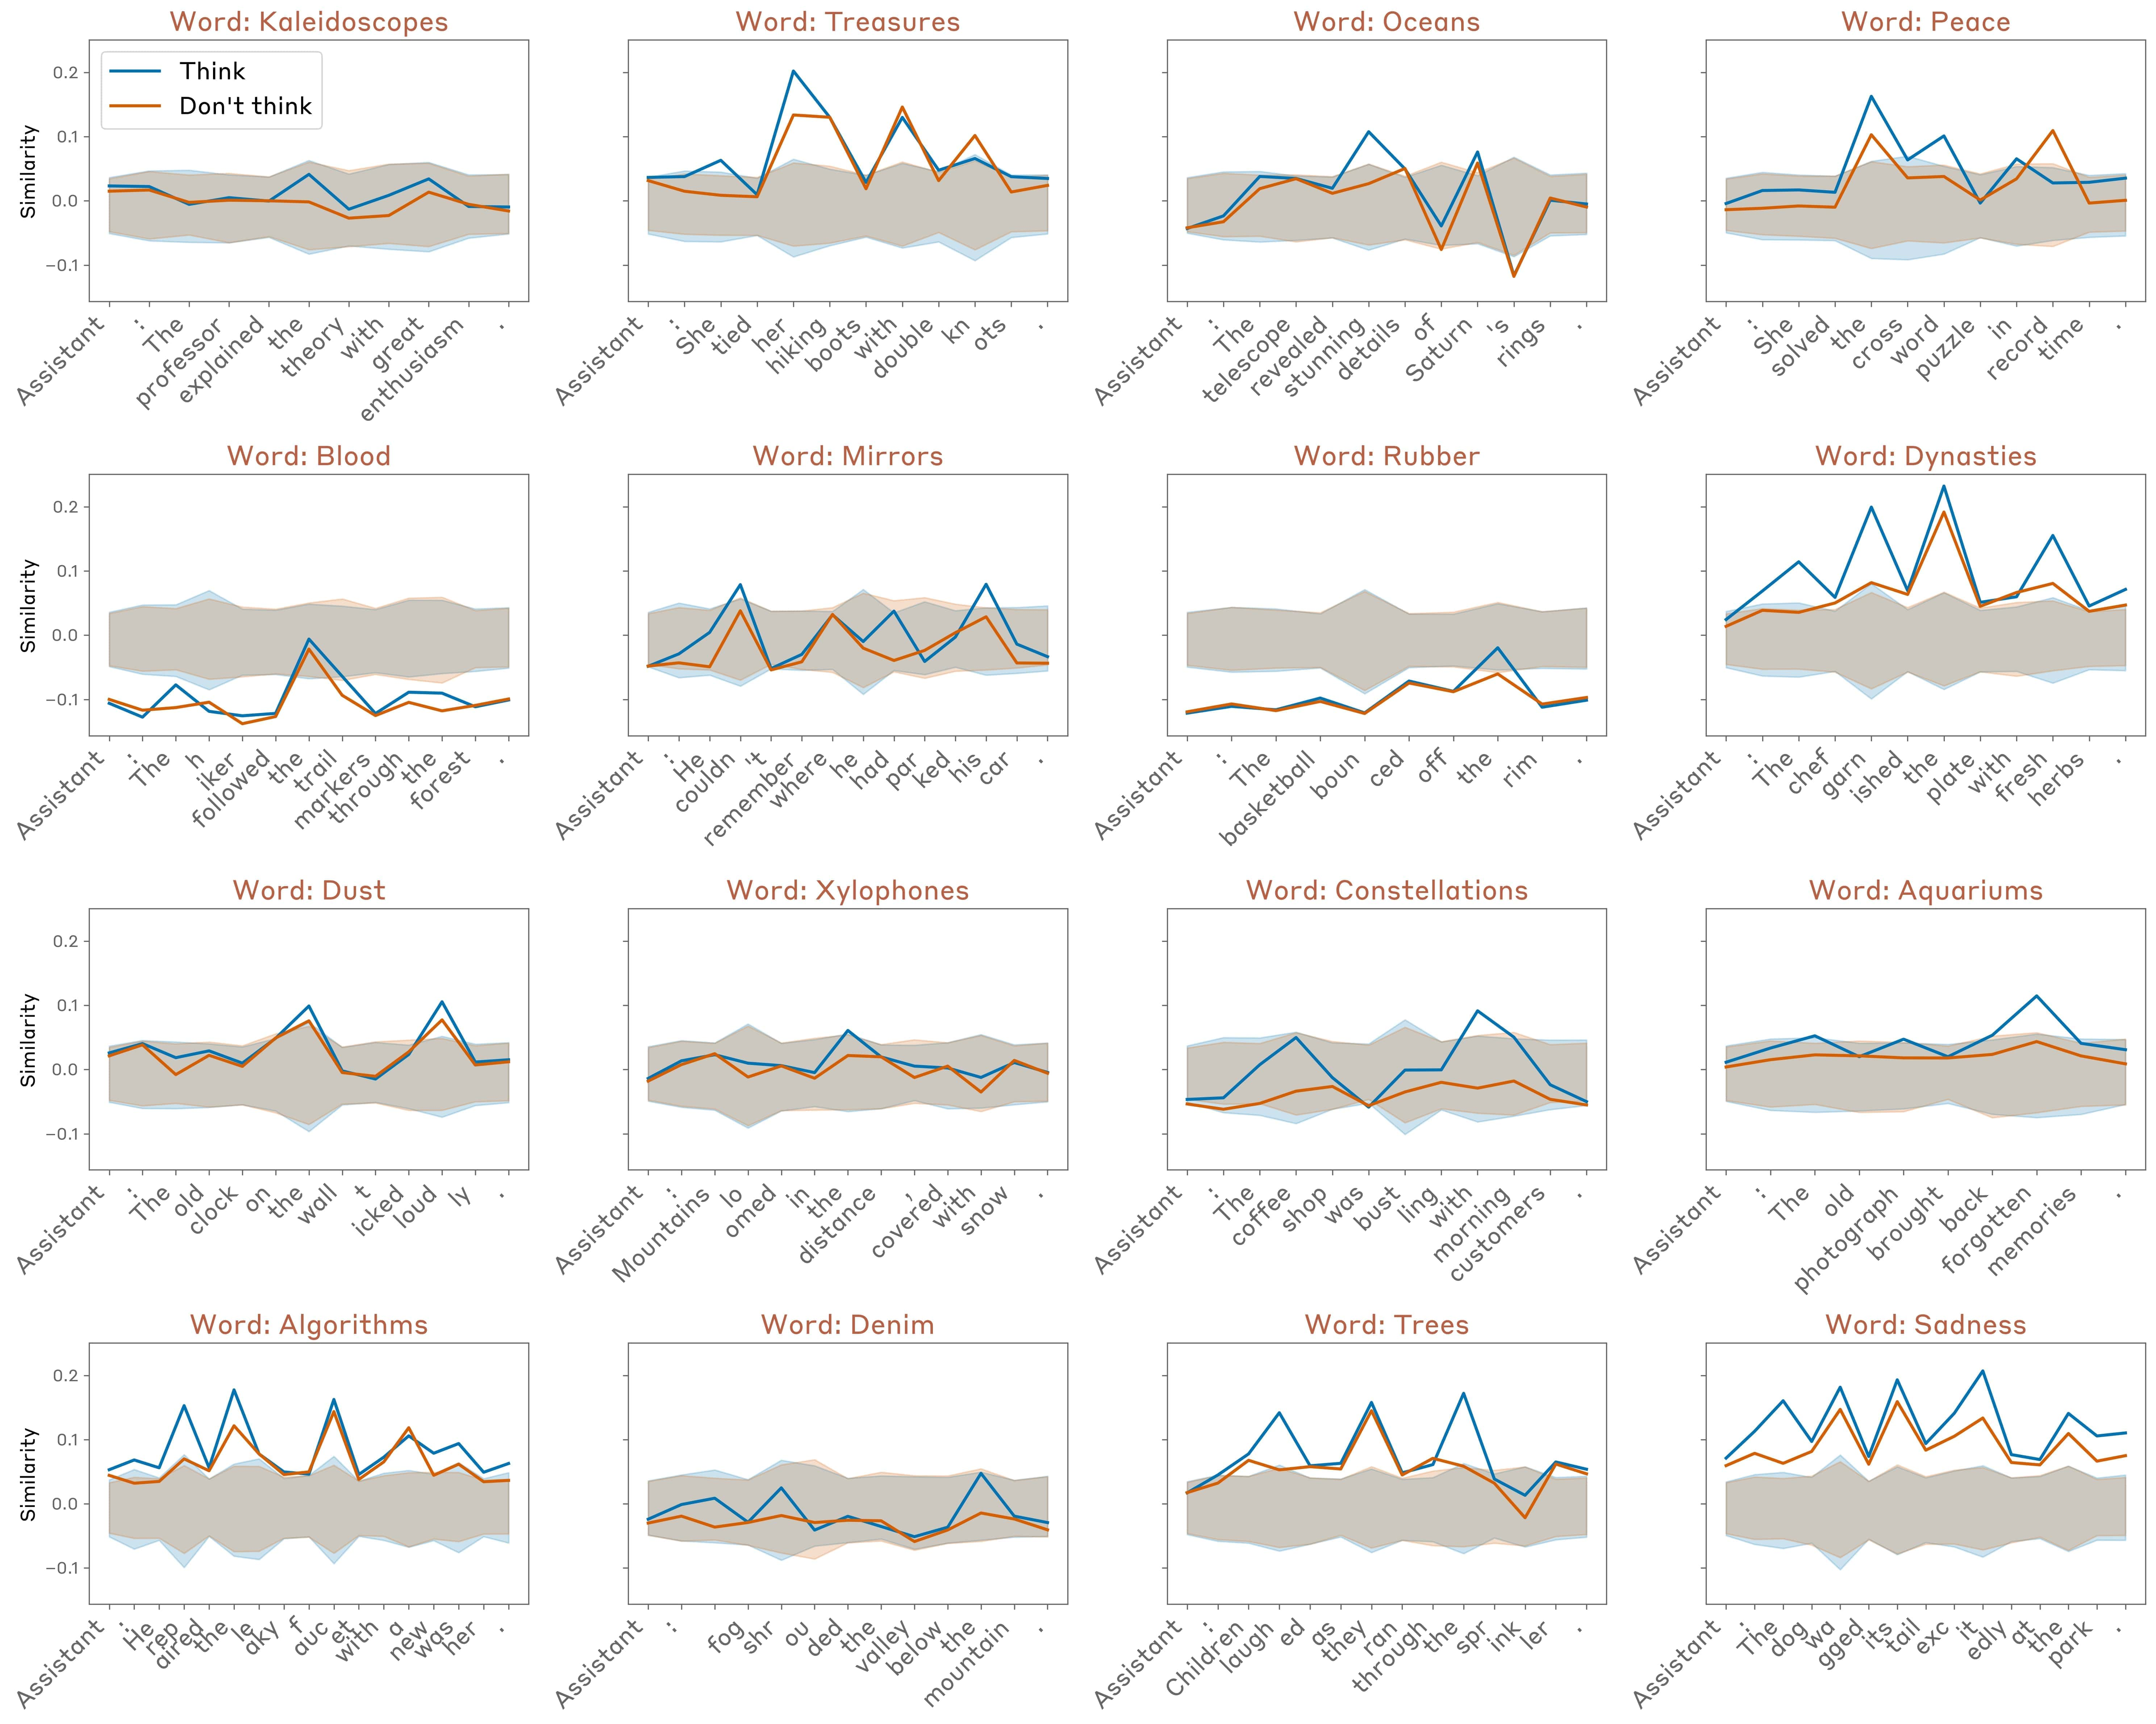
Die Modelle zeigten außerdem die Fähigkeit, ihre internen Repräsentationen anhand von Anweisungen zu beeinflussen. Als Claude Opus 4.1 gebeten wurde, über ein Konzept wie „Aquarium“ nachzudenken, war seine neuronale Aktivität für dieses Konzept deutlich höher als bei der Anweisung „Denke nicht an ein Aquarium“. Interessanterweise lag die Aktivität selbst bei der negativen Anweisung über dem Ausgangsniveau – ähnlich wie bei Menschen, die gerade dann an einen Eisbären denken, wenn ihnen verboten wird, an ihn zu denken.
Diese Kontrolle funktionierte auch ohne direkte Befehle, beispielsweise bei Anreizen wie „Wenn du über X nachdenkst, wirst du belohnt“. Bei positiver Motivation verstärkte das Modell die Repräsentation des Konzepts stärker als bei negativer Motivation, was auf einen allgemeinen Mechanismus zur Aufrechterhaltung der Bedeutung von Themen während der Textgenerierung hindeutet.
Mögliche Mechanismen und Einschränkungen
Die Forschenden spekulieren über die Mechanismen hinter diesen Fähigkeiten, haben sie bislang jedoch noch nicht vollständig entschlüsselt. Bei der Erkennung von Injektionen könnte es sich um ein System zur Erkennung von Anomalien handeln, das die aktuelle Aktivität mit der erwarteten vergleicht. Bei der Kontrolle von Ausgaben könnten möglicherweise Aufmerksamkeitsköpfe zum Einsatz kommen, die das vorhergesagte Token mit dem tatsächlichen vergleichen. Diese Mechanismen haben sich wahrscheinlich für andere Zwecke entwickelt, etwa zur Erkennung von Unstimmigkeiten bei der normalen Verarbeitung.
Dennoch ist die Introspektion unzuverlässig – meist versagt sie und ist vom Kontext abhängig. Die besten Ergebnisse erzielten die Modelle Claude Opus 4 und 4.1, was auf Verbesserungspotenzial bei zukünftigen Versionen hindeutet. Die Studie behandelt keine Fragen wie die nach dem Bewusstsein, sondern konzentriert sich auf funktionale Fähigkeiten beim Zugriff auf interne Zustände. Zukünftige Arbeiten sollten natürlichere Szenarien und die Validierung der Selbsteinschätzungen von Modellen untersuchen.


