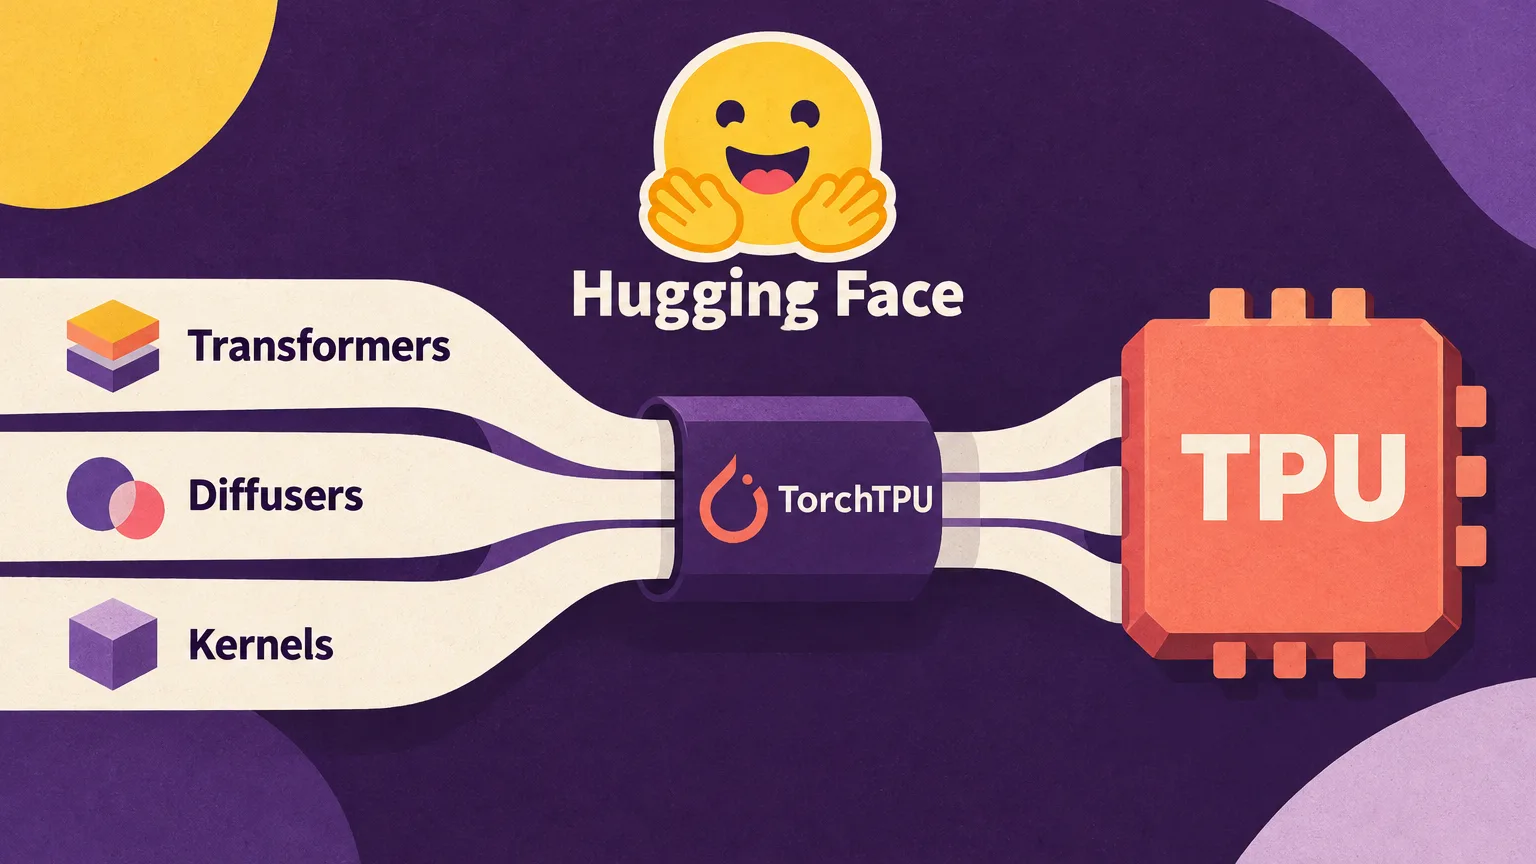
Hugging Face hat mit dem Backend TorchTPU native TPU-Unterstützung für die Bibliotheken Transformers, Diffusers und Kernels eingeführt. Entwickler können Modelle aus dem Hub damit direkt aus PyTorch auf TPUs ausführen. Für Transformers und Diffusers benötigen sie Optimum TPU nicht mehr, das bislang die TPU-Unterstützung dieser Modelle bereitstellte.
Gewohnter PyTorch-Code statt des bisherigen Wegs über XLA
Bisher lief PyTorch auf TPUs über PyTorch/XLA. Dabei wurden Operationen verzögert ausgeführt, also nicht unbedingt zu dem Zeitpunkt, an dem der Code sie aufrief. Laut Hugging Face konnten bereits kleine Änderungen eine erneute Kompilierung des Berechnungsgraphen auslösen; zudem erschwerte diese Arbeitsweise die Fehlersuche.
TorchTPU ergänzt PyTorch um ein weiteres Backend und erlaubt die Nutzung von gewöhnlichem PyTorch-Code. Enthalten sind für TPUs optimierte Pallas-Kernels, Unterstützung für verteiltes Training und eine Integration von torch.compile.
Transformers v5 lädt Modelle direkt auf die TPU
In Transformers v5 wird das Zielgerät beim Laden des Modells mit dem Parameter device_map="tpu" festgelegt. Standardmäßig läuft das Modell im Eager-Modus. Alternativ lassen sich torch.compile oder eine verteilte Ausführung nutzen; eine Kompilierung ist somit keine Voraussetzung, um das Modell auf einer TPU zu laden und auszuführen.
Diffusers unterstützt Kompilierung und die Verteilung auf mehrere Chips
Für Prototypen oder die Fehlersuche im Eager-Modus wird eine Diffusers-Pipeline mit pipe.to("tpu") auf die TPU verschoben. Für den kompilierten Betrieb kommt ein einzelner Kompilierungsaufruf hinzu, während der Pipeline-Code gleich bleibt. Ein separater Entwicklungszweig nur für TPUs ist nicht nötig.
Die kompilierte Pipeline erstellt den Berechnungsgraphen beim ersten Aufruf. Weitere Aufrufe verwenden ihn erneut, sofern die Bildgröße unverändert bleibt.
Übersteigt ein Modell die Kapazität eines einzelnen Chips, lässt sich der Methode from_pretrained eine TensorParallelConfig übergeben. Der Transformer wird dann bereits beim Laden auf mehrere Chips verteilt, sodass das vollständige Modell nicht an einer einzigen Stelle Platz finden muss. Allerdings unterstützen nicht alle Pipelines dies ohne Anpassungen: Bei einigen muss ein tp_plan ergänzt werden.
Demos vergleichen kompilierten Betrieb mit dem Eager-Modus
Hugging Face demonstrierte den Unterschied zwischen beiden Modi auf einer Cloud TPU v6e-4. Die Modelle waren dabei auf vier Chips verteilt und liefen mit bf16-Präzision sowie einer Batchgröße von 1. MiniMax-H3 erzeugte in der Demo ein 5,2 Sekunden langes Video mit Ton und einer Auflösung von 1344 × 768 bei 49 Schritten in 188 Sekunden im kompilierten Modus. Im Eager-Modus benötigte dieselbe Demonstration 262 Sekunden.
Mit Qwen-Image-2.1 zeigte Hugging Face unter denselben Hardwarebedingungen die Erzeugung eines Bildes mit 1024 × 1024 Pixeln bei 40 Schritten. Der kompilierte Modus benötigte in dieser Demo 3,5 Sekunden, der Eager-Modus 8,0 Sekunden.
Kernels Hub bietet fertige TPU-Kernels
Zur Unterstützung gehören außerdem fertige TPU-Kernels im Kernels Hub, die sich über die Bibliothek Kernels laden lassen. Sie sind in Pallas geschrieben; auch Kernels aus der Tokamax-Bibliothek können eingebunden werden. Ein genanntes Beispiel ist ragged-dot für Mixture-of-Experts-Modelle.
Hugging Face nennt zudem Ergebnisse eines Vergleichs zwischen einem Kernel aus dem Hub und der Standardimplementierung auf einer TPU v6e-8. Bei einer Batchgröße von 64 war die Dekodierung dem Unternehmen zufolge mit Qwen3-30B-A3B um den Faktor 21,5 und mit Gemma 4 26B-A4B um den Faktor 12,8 schneller.
Zugang über Google Cloud und Stand der Unterstützung
TPUs sind über Google Cloud verfügbar, von einem einzelnen Chip bis zu Pods mit Tausenden Chips. Auf einer virtuellen Maschine mit TPU lässt sich das Backend TorchTPU mit einem einzigen Befehl installieren.
Noch bestehen nicht alle Tests. Laut Hugging Face sind 96,5 % der Tests aus der Transformers-Bibliothek erfolgreich, die auf TPUs ausgeführt werden. Das Team hat im TorchTPU-Repository 34 Probleme gemeldet, von denen 19 bereits behoben wurden.
Hugging Face bereitet außerdem regelmäßige nächtliche Tests von Transformers auf TPUs vor. Die Ergebnisse sollen im Transformers-Dashboard veröffentlicht werden.