Dieselbe Frage, dasselbe Modell und derselbe Computer. Dennoch unterscheidet sich der Energieverbrauch je nach Sprache, in der der Nutzer fragt, um bis zum Hundertfachen. Zu diesem Ergebnis kamen Forscher der University of Michigan, die gemeinsam mit Kollegen aus Aberdeen und Cambridge erstmals gründlich gemessen haben, wie viel Strom Sprachmodelle beim Antworten in 122 Sprachen verbrauchen. Das Ergebnis ist unerfreulich, denn Englisch schneidet am günstigsten ab, während Sprachen wie Paschtu oder Tibetisch um Größenordnungen mehr Energie kosten und das Modell darin zugleich deutlich schlechter antwortet.
Warum sie mit den Messungen begannen
Sprachmodelle, also Programme wie ChatGPT, werden heute von Menschen auf der ganzen Welt in Dutzenden Sprachen genutzt. Wenn Entwickler untersuchen, wie gut ein Modell verschiedene Sprachen beherrscht, betrachten sie fast ausschließlich die Genauigkeit der Antworten. Wie viel Energie das Modell dabei verbraucht, hat bislang kaum jemanden interessiert.
Frühere Arbeiten haben bereits gezeigt, dass weniger verbreitete Sprachen mehr sogenannte Tokens benötigen, um denselben Gedanken auszudrücken. Ein Token ist ein kleiner Textbaustein, mit dem das Modell arbeitet, beispielsweise ein ganzes Wort, eine Silbe oder nur ein einzelnes Zeichen. Je mehr Tokens das System verarbeitet, desto mehr Berechnungen muss es ausführen. Bislang hatte jedoch niemand den tatsächlichen Verbrauch direkt an der Hardware gemessen. Die Autoren wollten daher herausfinden, ob die Sprache der Anfrage den Energieaufwand der Antwort systematisch beeinflusst und in welchem Ausmaß. Falls ja, besteht die Gefahr, dass Unternehmen, die künstliche Intelligenz betreiben, weniger verbreitete Sprachen aus rein wirtschaftlichen Gründen zunehmend vernachlässigen.
Die Forscher verwendeten den Leseverständnistest Belebele, der dieselben Texte und Fragen in Übersetzungen in 122 Sprachen enthält. In jeder Sprache stellten sie dem Modell Qwen3 mit acht Milliarden Parametern 900 Fragen und maßen präzise den Energieverbrauch der Grafikkarte. Dabei liefen alle Sprachen unter exakt denselben Bedingungen. Zur Kontrolle wiederholten sie die Messungen anschließend mit weiteren Modellen der Unternehmen Google und Meta, auf zwei Arten von Grafikkarten, mit unterschiedlich vielen gleichzeitig verarbeiteten Anfragen und bei drei verschiedenen Aufgaben, die vom Textverständnis über mathematische Textaufgaben bis hin zu gewöhnlichen Chats reichten.
Englisch für einen Heller, Paschtu für eine Krone
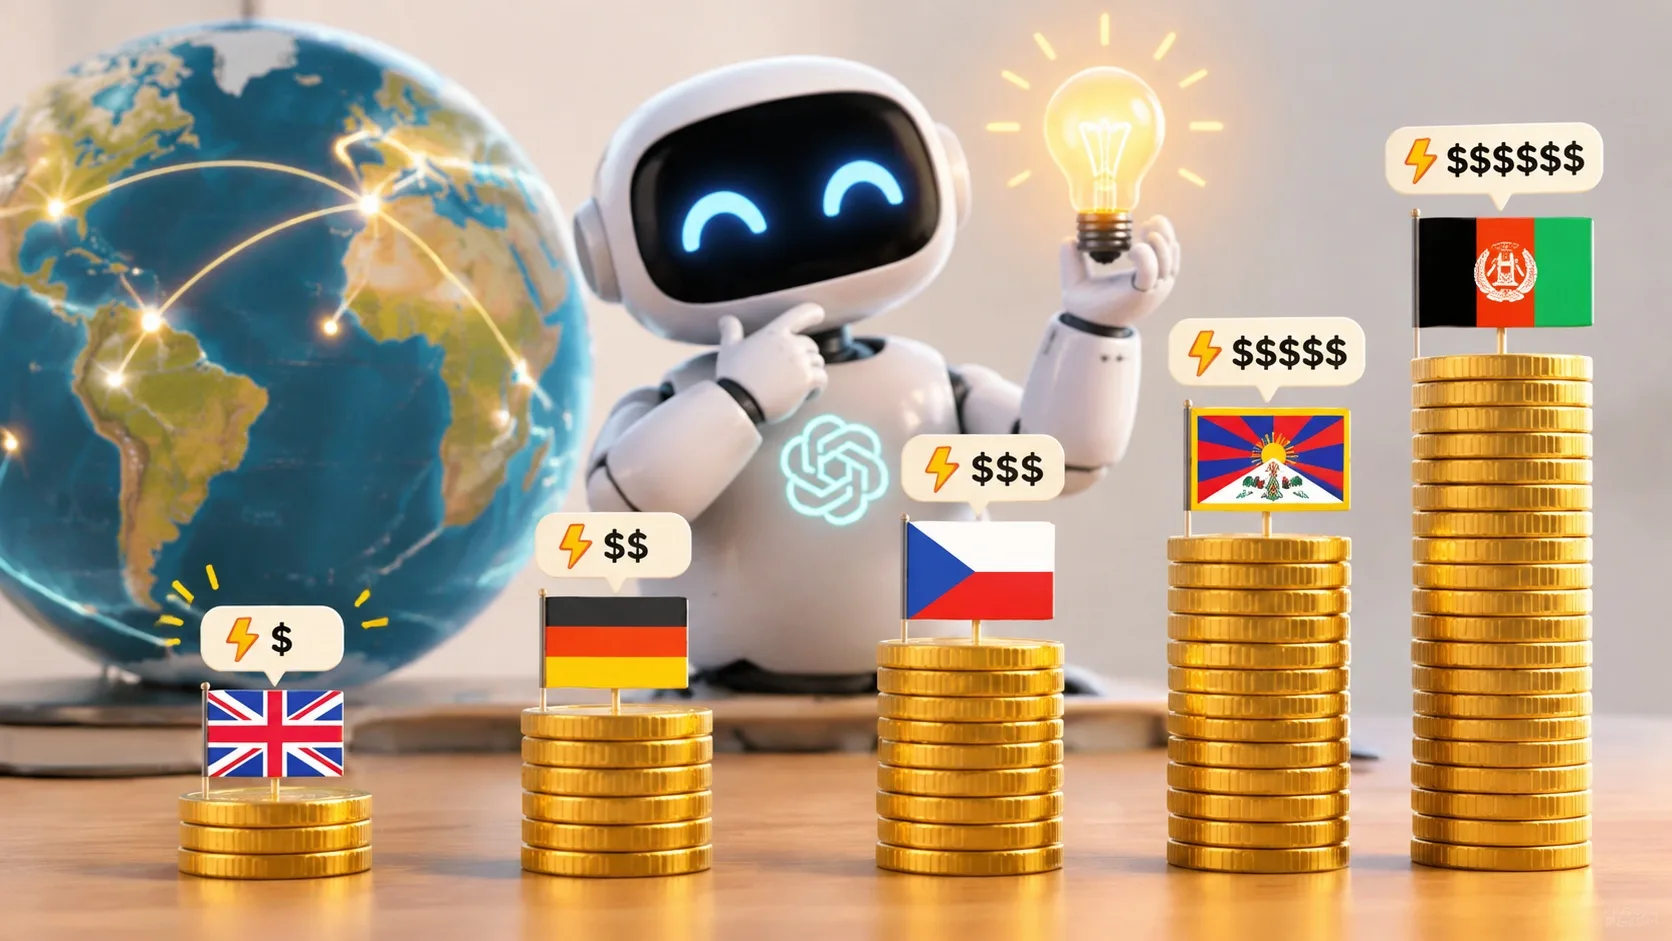
Die Unterschiede überraschten selbst die Autoren. Eine Antwort auf Englisch verbrauchte im Durchschnitt etwa 20 Joule. Joule ist die Grundeinheit der Energie, und zur Einordnung genügt es zu wissen, dass tausend Joule ein Kilojoule ergeben. Dieselbe Antwort auf Paschtu, das vor allem von Menschen in Afghanistan und Pakistan gesprochen wird, kam auf rund 3.500 Joule. Für den gesamten Satz von 900 Fragen verbrauchte Englisch knapp 18 Kilojoule, Paschtu hingegen mehr als 3.100 Kilojoule, was einem 179-fachen Unterschied entspricht.
Knapp hinter Paschtu folgten Tibetisch, Shan aus Myanmar und Tigrinya, das in Eritrea und Äthiopien gesprochen wird. Das Problem betrifft jedoch nicht nur weniger verbreitete Sprachen. Hindi benötigt etwa achtmal und Bengalisch rund fünfzehnmal mehr Energie als dieselbe Anfrage auf Englisch, obwohl jede dieser Sprachen von Hunderten Millionen Menschen gesprochen wird. Die Forscher berechneten, dass etwa 5,2 Milliarden Menschen für Texte in ihrer Muttersprache mehr als doppelt so viel Energie aufwenden müssen wie Englischsprachige. Die meisten westeuropäischen Sprachen lagen beim Doppelten des englischen Verbrauchs oder darunter.
Tschechisch schnitt vergleichsweise ordentlich ab. Das Modell verbrauchte dabei etwa viermal mehr Energie als auf Englisch und beantwortete 89 Prozent der Fragen richtig. Deutsch schnitt noch etwas besser ab: Es verbrauchte etwa doppelt so viel Energie wie Englisch und erreichte eine Erfolgsquote von 92 Prozent. Englisch kam auf eine Erfolgsquote von fast 95 Prozent.
Die Messungen brachten noch eine weitere unangenehme Tatsache ans Licht. Die Sprachen, die am meisten Energie kosten, beherrscht das Modell zugleich am schlechtesten. Auf Tibetisch, Paschtu, Tigrinya, Shan und Amharisch beantwortete es höchstens 43 Prozent der Fragen richtig, auf Shan sogar nur knapp 11 Prozent. Die Sprecher dieser Sprachen zahlen somit doppelt drauf, denn die Antwort ist teurer und häufig falsch.
Wo die Energie verloren geht
Der Unterschied hat den Autoren zufolge zwei Ursachen, die sich gegenseitig verstärken. Die erste ist die Anzahl der Tokens. Ein Modell, das hauptsächlich mit englischen Texten trainiert wurde, kann englische Wörter effizient zerlegen, sodass ein Wort häufig einem Token entspricht. Bei Schriften wie der tibetischen, äthiopischen oder birmanischen wird ein Wort dagegen in viele kleine Teile zerlegt. Im Tibetischen entfiel auf ein Token im Durchschnitt weniger als ein Buchstabe, im Englischen waren es fast fünf. Bei den vier energieintensivsten Sprachen erzeugte das Modell zwanzig- bis fünfundzwanzigmal mehr Tokens als im Englischen.
Die zweite Ursache ist der Energieverbrauch pro Token, der sich zwischen den Sprachen um bis zum Achtfachen unterschied. Lange Antworten belegen nämlich mehr Speicher auf der Grafikkarte. Der Server kann dann nicht so viele Anfragen gleichzeitig verarbeiten, die Leistung der Karte bleibt ungenutzt und jeder Token wird teurer.
Die Forscher untersuchten auch, was das Modell in den problematischen Sprachen tatsächlich schrieb. Auf Tigrinya wiederholte es denselben Satz fünfundvierzigmal hintereinander, als wäre es in einer Schleife stecken geblieben. Auf Lettisch antwortete es korrekt, aber weitschweifig, und erzeugte mehr als dreimal so viele Tokens wie auf Englisch. Auf Khmer wechselte es dagegen ins Englische und antwortete in einer völlig anderen Sprache als derjenigen, in der die Frage gestellt worden war.
Die Ausnahmen zeigen, dass es nicht nur um die Komplexität der Schrift geht. Vereinfachtes Chinesisch verwendet völlig andere Zeichen als das lateinische Alphabet und war energetisch dennoch mit Englisch gleichauf, weil das Modell beim Training enorme Mengen chinesischer Texte gesehen hatte. Ähnlich schnitt Ägyptisch-Arabisch ab. Es gehört zwar zu den weniger stark vertretenen Sprachen, verwendet jedoch dieselbe Schrift wie das Hocharabische, das dem Modell gut bekannt ist, und landete daher unter den fünf günstigsten Sprachen.
Auch bei größeren Modellen verschwand die Kluft nicht. Bei Qwen3 mit 14 Milliarden Parametern vergrößerte sich das Verhältnis zwischen der günstigsten und der teuersten Sprache sogar auf das Zwölffache. Am günstigsten waren stets Englisch oder Chinesisch, am teuersten Tibetisch oder Shan, und die beiden Sprachgruppen überschnitten sich nie. Das galt für beide Grafikkarten und alle drei Aufgaben.
Was die Forscher vorschlagen
Die Forscher wollen, dass der Energieverbrauch ebenso wie die Genauigkeit der Antworten zu einem festen Bestandteil der Modellbewertung wird. Ihrer Ansicht nach sollten Entwickler für jedes Modell angeben, wie viel Energie es in den einzelnen Sprachen verbraucht. Ein Modell, das auf Englisch 95 Prozent der Antworten für ein paar Heller richtig beantwortet und auf Tibetisch 22 Prozent für ein Vielfaches dieses Preises, stellt den Autoren zufolge in Wirklichkeit zwei völlig unterschiedliche Produkte für zwei Gruppen von Menschen dar.
Sie schlagen auch praktische Lösungen vor. Das System könnte die Sprache der Anfrage erkennen und dementsprechend die maximale Länge der Antwort begrenzen, damit das Modell nicht in eine Schleife gerät. Anfragen in weniger verbreiteten Sprachen könnten an kleinere, speziell auf diese Sprachen ausgerichtete Modelle weitergeleitet werden. Eine weitere Möglichkeit besteht darin, die Frage ins Englische zu übersetzen, das Modell antworten zu lassen und das Ergebnis zurückzuübersetzen. Frühere Untersuchungen zufolge kann dies bei weniger verbreiteten Sprachen auch die Genauigkeit verbessern. Die Autoren weisen jedoch darauf hin, dass Übersetzungen bei Texten voller kultureller Anspielungen, Redewendungen oder lokaler Gepflogenheiten flüssig klingen und dennoch den Sinn verfehlen können.
Den Autoren ist bewusst, dass ihre Erkenntnisse auch eine Kehrseite haben könnten. Unternehmen könnten sie als Vorwand nutzen, um weniger verbreitete Sprachen einzuschränken oder vollständig aus ihrem Angebot zu entfernen. Über das Problem zu schweigen, ist ihrer Ansicht nach jedoch schlimmer, weil dies dann still und ohne Kontrolle geschehen würde. Die Rechnung für Strom, Wasser und Emissionen zahlen letztlich nämlich alle, während die Sprecher vernachlässigter Sprachen die schlechtesten Leistungen erhalten.
Die Studie hat auch ihre Grenzen. Die Tests wurden nur auf zwei Arten von Nvidia-Grafikkarten durchgeführt, und die Forscher hatten keinen Zugang zu kommerziellen Modellen wie GPT, Gemini oder Claude, die einen großen Teil der mehrsprachigen Anfragen weltweit bearbeiten. Die Fragen waren maschinell übersetzt und nicht von Muttersprachlern verfasst. Tatsächliche Anfragen von Menschen sind meist chaotischer, weshalb die Autoren die gemessenen Unterschiede eher als Untergrenze dessen ansehen, was in Wirklichkeit geschieht.
Quelle: aclanthology.org