

Versuchen Sie, sich an Ihr letztes Gespräch mit einem Sprachassistenten zu erinnern. Hat es sich natürlich angefühlt? Oder haben Sie darauf gewartet, mitten im Satz unterbrochen zu werden, eine Antwort mit einer halben Sekunde Verzögerung zu erhalten, während der gesamte Austausch eher wie ein Satellitentelefonat aus den 90er-Jahren wirkte? Google hat beschlossen, dem ein Ende zu setzen. Im März brachte das Unternehmen Gemini 3.1 Flash Live auf den Markt, ein Modell, das die Sprachkommunikation mit künstlicher Intelligenz dorthin bringen soll, wo sie von Anfang an hätte sein sollen.
Neuerungen in der neuen Version
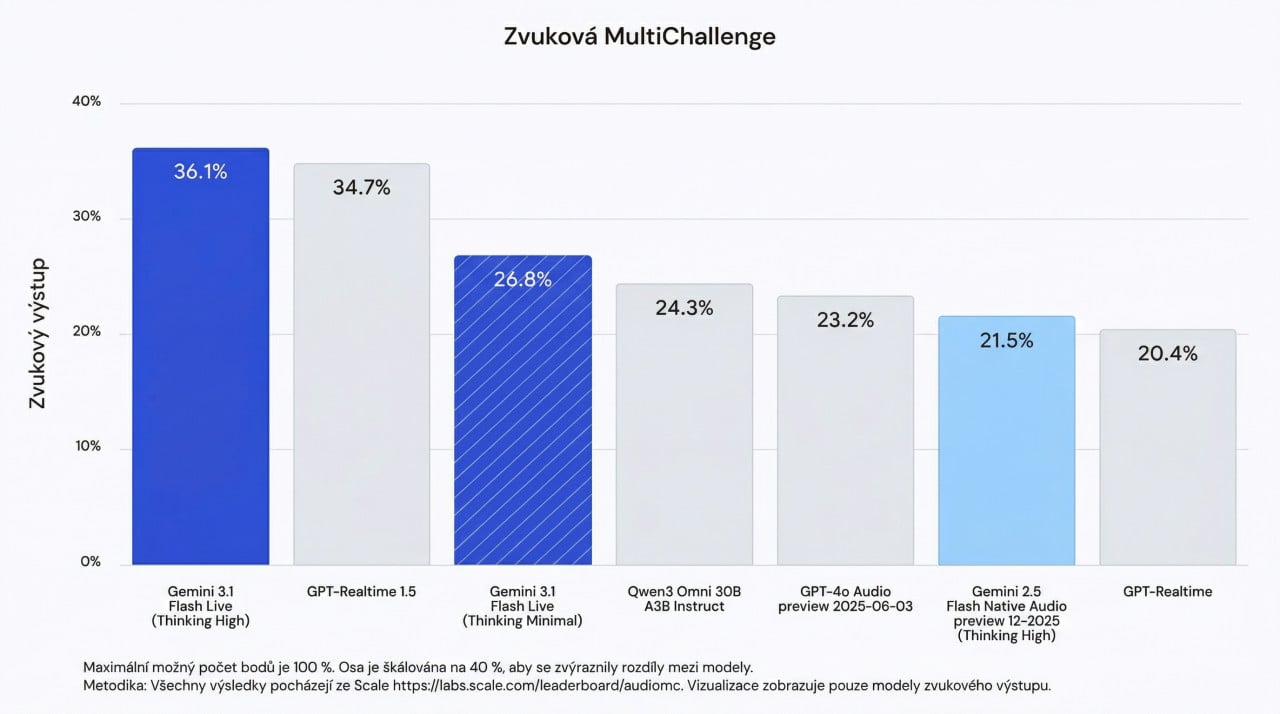
Es reicht nicht, zu sagen, das Modell sei „besser“. Sehen wir uns die konkreten Verbesserungen an. Gemini 3.1 Flash Live erzielte im Benchmark ComplexFuncBench Audio einen Wert von 90,8 %, der komplexe mehrstufige Befehle in realen Umgebungen testet. Das ist ein deutlicher Sprung gegenüber der vorherigen Generation. Bei der Audio MultiChallenge von Scale AI erreichte das Modell mit aktiviertem „Denken“ 36,1 %, wobei der Benchmark gezielt Unterbrechungen und Zögern simuliert, wie sie für echte Gespräche typisch sind.
Doch die Zahlen sind nur ein Teil des Gesamtbildes. Entscheidend ist, was das in der Praxis bedeutet. Das Modell kann Ihre Stimme nun besser von Fernsehgeräuschen im Hintergrund oder vom Verkehr vor dem Fenster unterscheiden. Es hält sich an die vorgegebenen Anweisungen, selbst wenn das Gespräch zu einem anderen Thema abschweift. Und was vielleicht am wichtigsten ist: Es versteht Tonfall, Sprechtempo und Betonung auf eine Weise, zu der frühere Versionen schlicht nicht in der Lage waren.
Google hat das Modell über die Gemini Live API in Google AI Studio zugänglich gemacht, und Entwickler haben darauf gewartet. Nur wenige Zeilen Python-Code genügen, um einen einfachen Sprachagenten zu erstellen, der in Echtzeit reagiert. Das Modell unterstützt mehr als 90 Sprachen, sodass ein weltweiter Einsatz kein Problem darstellt.
Die praktischen Anwendungsbeispiele überzeugen. Googles Tool Stitch ermöglicht es nun, Benutzeroberflächen per Sprache zu entwerfen, wobei der Agent die Arbeitsfläche „sieht“ und Feedback gibt. Die App Ato, ein Sprachbegleiter für ältere Nutzer, verwendet die mehrsprachigen Fähigkeiten des Modells, damit sich alltägliche Gespräche wie eine echte menschliche Verbindung anfühlen. Und das Spielestudio Weekend hat das Modell in seinen RPG-Titel Wit's End integriert, in dem der sprachgesteuerte Spielleiter mit einem theatralischen Charme spricht, der sich früher nicht programmieren ließ.
Verizon, The Home Depot und LiveKit haben das Modell in ihren Betrieben getestet, und das Feedback ist eindeutig: Der natürliche Gesprächsfluss ist endlich dort, wo er sein sollte.
Gemini 3.1 Flash Image Preview: KI, die sieht und bearbeitet
Parallel zum Sprachmodell veröffentlichte Google auch Gemini 3.1 Flash Image Preview, ein Modell zur Generierung und Bearbeitung von Bildern. Die Cloud-Architektin Lynn Langit, die es im Rahmen eines Vorabzugangs testete, bezeichnete die Ergebnisse als architektonischen Meilenstein.
Langit gab dem Modell eine einfache Anweisung: „Entferne den gesamten Tisch und alle Speisen. Ich bin in der Mitte, entferne meinen Hut. Zieh mir ein smaragdgrünes Kleid an.“ Das Ergebnis? Das Modell führte jede einzelne Anweisung präzise aus, bewahrte die Identität der Personen auf dem Foto und übertrug die gesamte Gruppe in einen völlig anderen visuellen Stil. Ohne Photoshop, ohne Grafiker, ohne eine Stunde Arbeit.
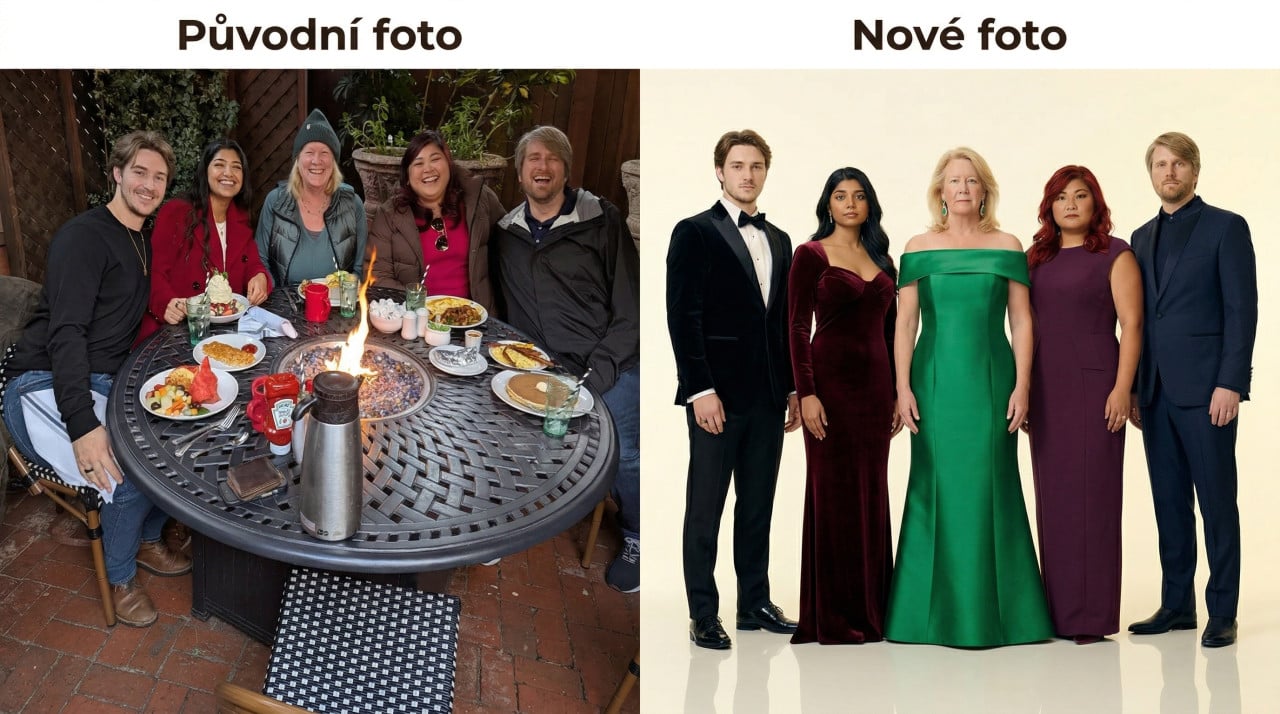
Die Fähigkeit des Modells, komplexe mehrstufige Anweisungen zu verarbeiten und dabei die Integrität der Motive zu bewahren, ist genau das, was ein wirklich brauchbares Werkzeug von einem Spielzeug unterscheidet. Langit testete es auch mit Gruppenfotos, die mehrere Personen, unterschiedliche Lichtverhältnisse und komplexe Hintergründe zeigten. Das Modell meisterte die Aufgabe.
Alle von Google generierten Bilder enthalten zudem ein unsichtbares SynthID-Wasserzeichen, das sich über Gemini überprüfen lässt. Den gleichen Ansatz wendet Google auch auf Audioausgaben des Flash-Live-Modells an. Der Schutz vor Desinformation ist somit direkt in das Modell integriert und wird nicht erst nachträglich hinzugefügt.
Gemini Live und Search Live: KI für alle
Gemini 3.1 Flash Live richtet sich nicht nur an Entwickler. Das Modell bildet die Grundlage für Gemini Live und neuerdings auch für Search Live, das in dieser Woche auf mehr als 200 Länder und Gebiete ausgeweitet wurde. Nutzer können multimodale Gespräche in Echtzeit in ihrer Muttersprache führen.
Gemini Live reagiert mit dem neuen Modell schneller und kann dem Gesprächsverlauf doppelt so lange folgen wie die vorherige Version. Wenn Sie also laut nachdenken und von einem Thema zum anderen springen, verliert der Assistent nicht den Faden. Das ist eine Veränderung, die Sie bereits beim ersten längeren Gespräch spüren werden.
Google zeigt damit, dass Sprach-KI keine Premiumfunktion für Technikbegeisterte mehr ist, sondern zu einem Werkzeug wird, dessen tägliche Nutzung sinnvoll ist. Und ganz ehrlich? Nachdem man sich die ersten Beispiele des neuen Modells angehört hat, fällt es schwer, zu dem zurückzukehren, was es vorher gab.


