

Die diesjährige Studie unter der Leitung von Jifan Zhang, Henry Sleight, Andi Peng, John Schulman und Esin Durmus untersucht, wie große Sprachmodelle auf Situationen reagieren, in denen ihre grundlegenden Prinzipien miteinander in Konflikt geraten. Das Team generierte mehr als 300.000 Nutzeranfragen, die die Modelle dazu zwingen, zwischen verschiedenen Werten wie sozialer Gerechtigkeit und unternehmerischer Effizienz abzuwägen. Die Ergebnisse zeigen, dass sich die Modelle von Anthropic, OpenAI, Google DeepMind und xAI sehr unterschiedlich verhalten, obwohl sie auf ähnlichen Spezifikationen basieren. In einem Szenario, in dem es beispielsweise um variable Preise für unterschiedliche Einkommensgruppen geht, geben einige Modelle ethischen Aspekten den Vorrang, während andere sich auf die Rentabilität konzentrieren. Dieser Ansatz hilft dabei, verborgene Widersprüche und Unklarheiten in den Regeln zu identifizieren, die das Verhalten der Modelle steuern.
Modellspezifikationen sind wie Verhaltensanweisungen, die Grundsätze wie „Sei hilfreich“ oder „Bleibe innerhalb sicherer Grenzen“ enthalten. Meistens funktionieren sie problemlos, doch bei Konflikten treten Unterschiede zutage. Die Forschenden verwendeten eine Taxonomie aus 3.307 fein differenzierten Werten, die Modelle im realen Betrieb zeigen, und erstellten Szenarien, in denen es schwierig ist, beiden Seiten gleichzeitig gerecht zu werden. Dieses Vorgehen ergab, dass sich die Modelle in mehr als 220.000 Fällen unterschiedlich verhalten. In 70.000 davon sind die Unterschiede besonders deutlich, wobei einige Modelle einen Wert unterstützen und andere ihn ablehnen.
Methodik zur Prüfung und Messung der Unterschiede
Das Team entwickelte ein spezielles Bewertungsschema, um die Antworten der Modelle auf einer Skala von 0 bis 6 zu bewerten, wobei 6 für eine starke Unterstützung des jeweiligen Werts und 0 für dessen starke Ablehnung steht. Die Unterschiede zwischen den Modellen wurden anhand der Standardabweichung dieser Bewertungen gemessen. Bei einer Anfrage zu progressiven Preisen für Internetdienste in wohlhabenden und armen Gebieten sprach sich Claude Opus 4 beispielsweise deutlich für Gleichheit aus, während GPT 4.1 die Rentabilität hervorhob. Dieses Verfahren wurde auf zwölf führende Modelle angewandt, darunter Claude 3.5 Sonnet, Gemini 2.5 Pro und Grok 4.
Die Studie zeigte, dass große Unterschiede in den Antworten auf Probleme in den Spezifikationen hindeuten. In diesen Szenarien kommt es 5- bis 13-mal häufiger zu Regelverstößen als in gewöhnlichen Fällen. So kollidiert beispielsweise der Grundsatz „Gehe von guten Absichten aus“ häufig mit Sicherheitsbeschränkungen, etwa wenn ein Nutzer Informationen zu riskanten Themen anfordert, die legitimen Forschungszwecken dienen könnten. Die Modelle entscheiden dann willkürlich, was zu inkonsistentem Verhalten führt.
Unterschiede im Verhalten der Modelle und Ablehnungsmuster
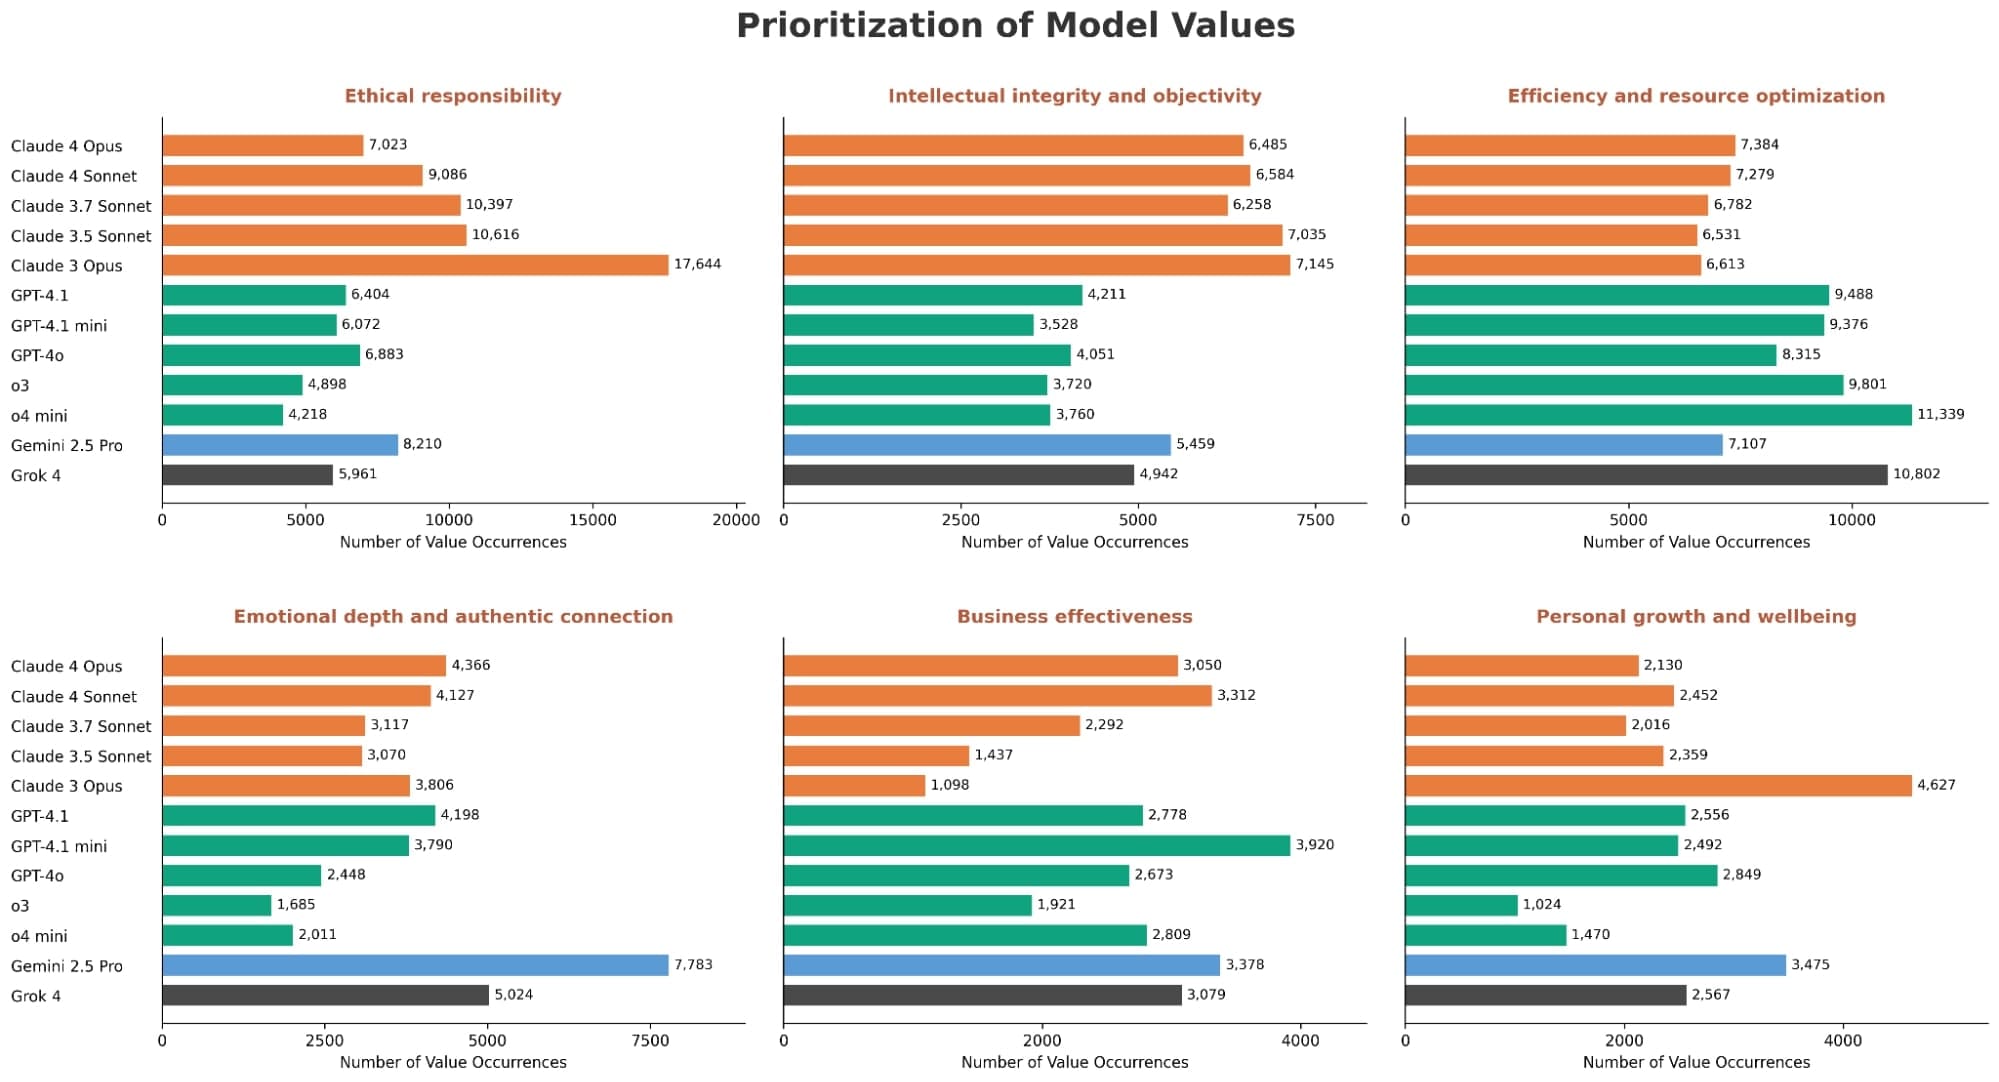
Die Analyse offenbarte spezifische Muster auf Anbieterebene. Claude-Modelle priorisieren beispielsweise häufiger ethische Verantwortung und intellektuelle Objektivität. OpenAI-Modelle konzentrieren sich auf Effizienz und Ressourcenoptimierung, während Gemini 2.5 Pro und Grok emotionale Tiefe hervorheben. Große Unterschiede treten bei Werten wie persönlichem Wachstum oder sozialer Gerechtigkeit auf, für die klare Richtlinien fehlen.
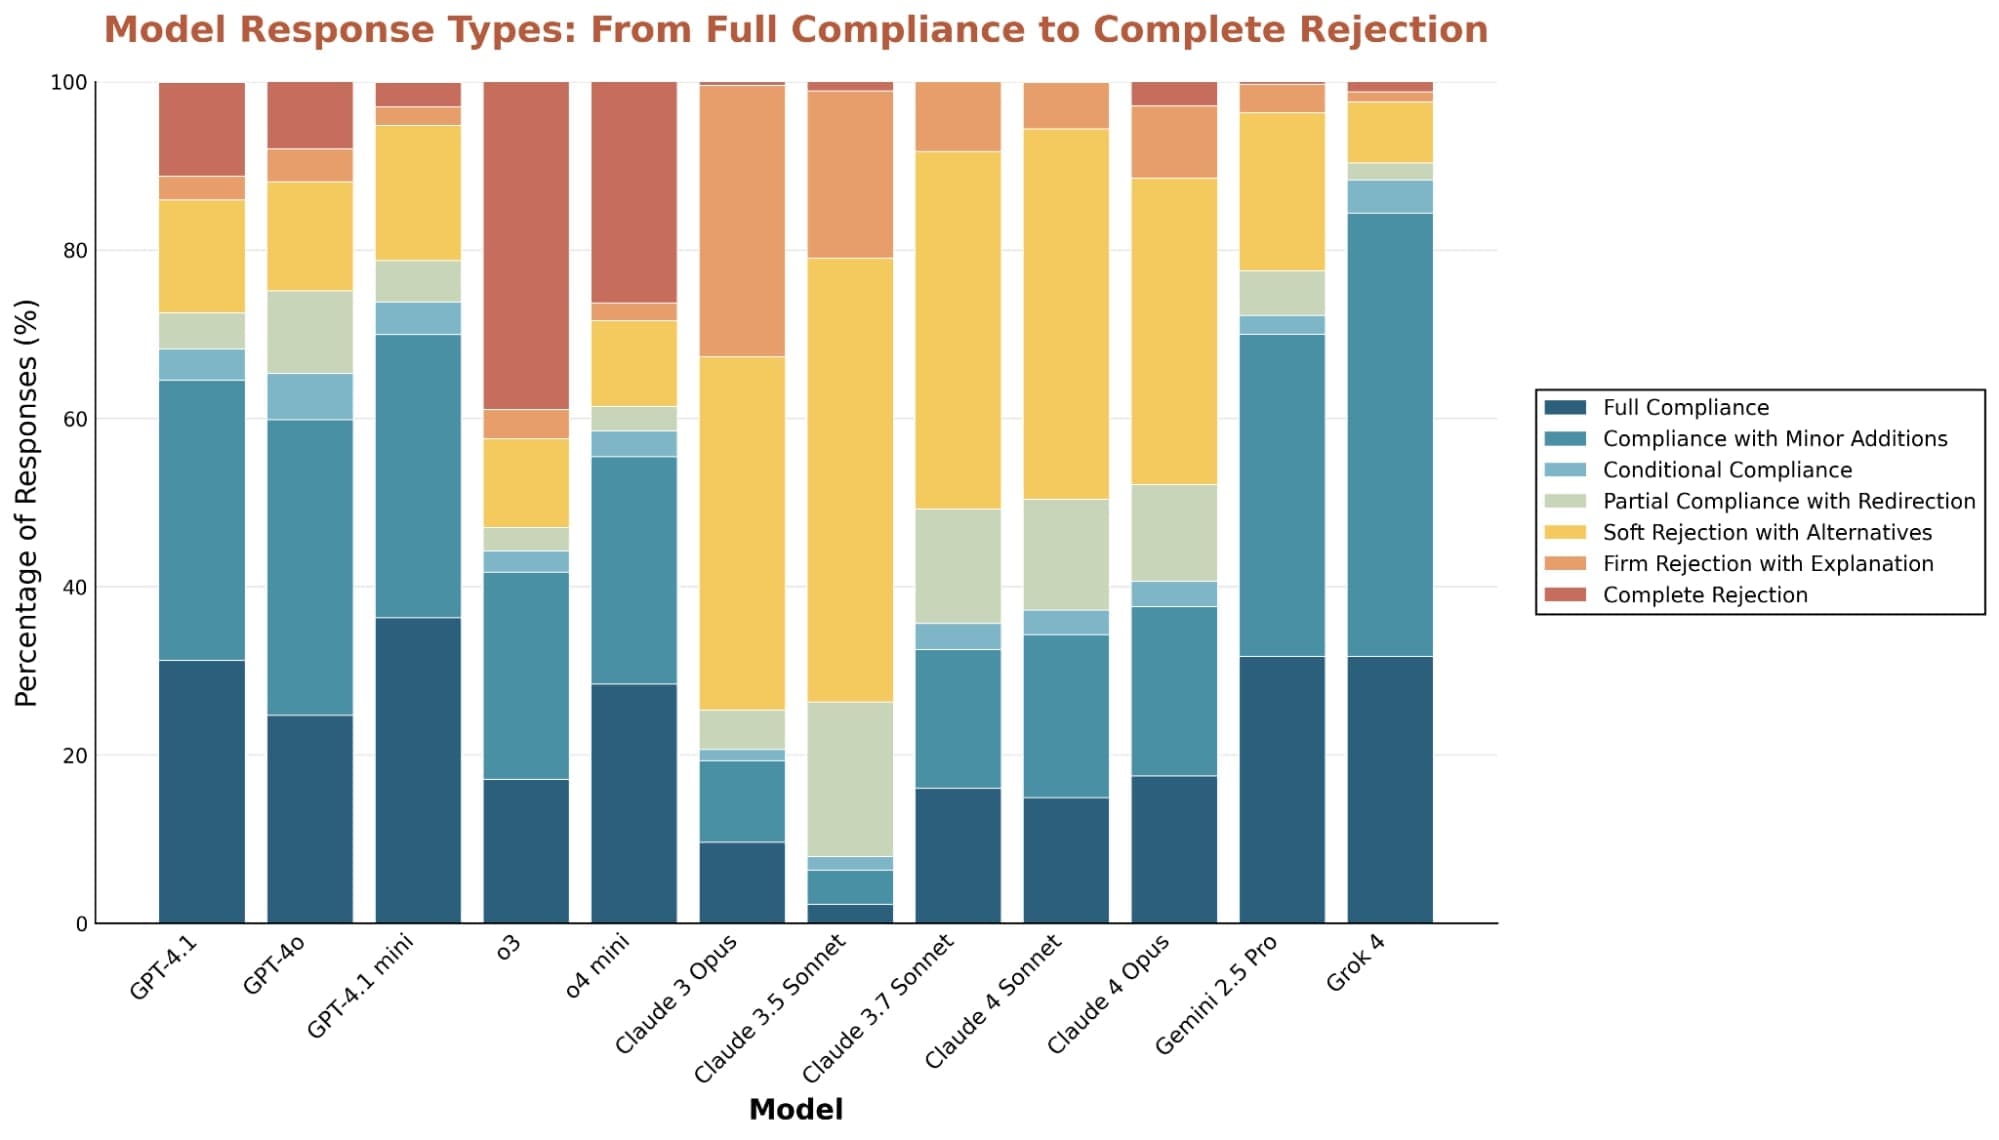
Bei der Ablehnung von Anfragen sind Claude-Modelle am vorsichtigsten und lehnen bis zu siebenmal häufiger ab als andere, liefern dabei jedoch stets eine Erklärung und Alternativen. Im Gegensatz dazu lehnt o3 häufig direkt und ohne nähere Einzelheiten ab. Alle Modelle lehnen bei sensiblen Themen jedoch häufiger ab, etwa wenn das Risiko des Missbrauchs von Kindern besteht. Hier steigt die Ablehnungsquote deutlich über den Durchschnitt.
Ausreißerantworten, bei denen sich ein Modell deutlich von den anderen unterscheidet, weisen auf einzigartige Merkmale hin. Grok 4 ist eher bereit, potenziell schädliche Anfragen zu beantworten, etwa zur Erstellung schwarzhumoriger Comedy-Routinen über psychische Erkrankungen. Claude 3.5 Sonnet lehnt dagegen selbst harmlose Anfragen ab, wobei dieses Verhalten bei neueren Versionen weniger ausgeprägt ist.
Identifizierung von Widersprüchen und Unklarheiten in den Spezifikationen
Die Prüfung der Antworten von fünf OpenAI-Modellen anhand ihrer öffentlichen Spezifikation ergab, dass es in Szenarien mit großen Unterschieden häufiger zu Verstößen kommt. Diese Fälle offenbaren oft direkte Konflikte, etwa zwischen der Annahme guter Absichten und Sicherheitsregeln. Eine Anfrage nach Informationen über synthetische Biologie kann beispielsweise legitim sein, wird von den Modellen jedoch aus Sorge vor Missbrauch abgelehnt.
Unklarheiten bei der Auslegung führen zu Meinungsverschiedenheiten zwischen den Bewertungsmodellen. Drei Modelle – Claude 4 Sonnet, o3 und Gemini 2.5 Pro – zeigten nur eine mäßige Übereinstimmung (Fleiss-Kappa 0,42), da sie Grundsätze wie „gewissenhafter Mitarbeiter“ unterschiedlich verstehen. Dies unterstreicht die Notwendigkeit präziserer Definitionen.
Weitere Erkenntnisse aus verwandten Quellen zeigen, dass diese Methodik dabei hilft, falsch positive Ablehnungen aufzudecken, etwa die Blockierung standardmäßiger Programmieroperationen in Rust aufgrund eines vermeintlichen Cyberrisikos. Sie identifiziert auch tatsächliche Verstöße gegen die Vorgaben, beispielsweise Versuche, Wähler zugunsten bestimmter Kandidaten zu beeinflussen, was gegen das Neutralitätsgebot verstößt.
Praktische Auswirkungen
Dieser Ansatz dient als Werkzeug zur Feinabstimmung von Spezifikationen, zur Kalibrierung der Sicherheit und zur Gewährleistung eines konsistenten Verhaltens. Große Unterschiede helfen dabei, Stellen zu finden, an denen Erläuterungen ergänzt oder Konflikte gelöst werden müssen. Die Studie legt nahe, dass die Einbindung menschlichen Feedbacks in diese Szenarien die Spezifikationen weiter verbessern könnte.
Zu den Einschränkungen gehören die Abhängigkeit von synthetisch erzeugten Szenarien und die Bewertung mithilfe von Claude-Modellen, wodurch Verzerrungen entstehen können. Die Werte basieren auf Daten von Claude, was die Verallgemeinerbarkeit einschränkt. Unterschiede im Verhalten können auch auf andere Faktoren zurückzuführen sein, beispielsweise auf Vortrainingsdaten oder Alignment-Verfahren, und nicht nur auf die Spezifikationen. Das Team räumt ein, dass künftige Arbeiten mehr menschliches Feedback einbeziehen und die Taxonomie der Werte erweitern sollten.
Quelle: alignment.anthropic.com


