

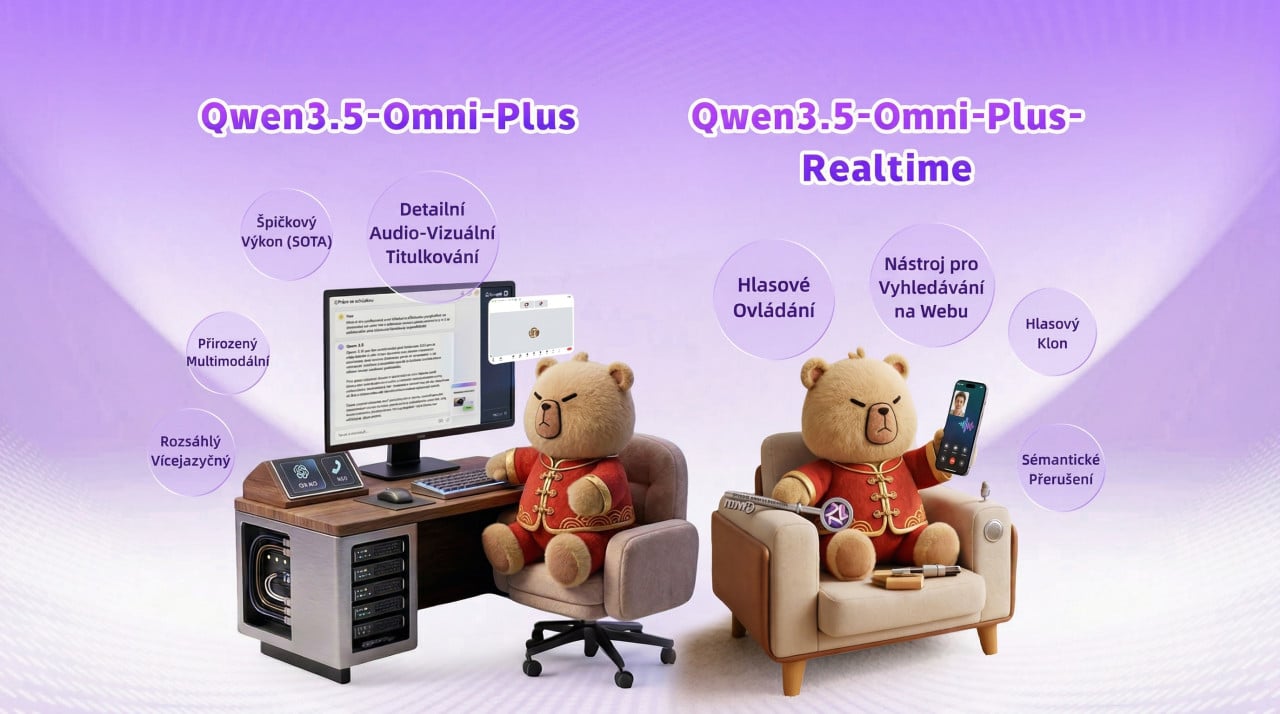
Alibaba Cloud hat etwas vorgestellt, das Aufmerksamkeit verdient. Qwen3.5-Omni ist sein neuestes Sprachmodell, und diesmal geht es nicht nur um Text. Dieses System verarbeitet Bilder, Audio, Video und Text gleichzeitig in einem einzigen Rechenstrom. Kein Zusammenfügen externer Module, keine separate Transkription von Audio. Alles läuft unter einem Dach.
Und als wäre das nicht genug, hat Alibaba das gesamte Modell unter der offenen Apache-2.0-Lizenz veröffentlicht. Das bedeutet, dass jeder es herunterladen, anpassen und auf eigener Hardware betreiben kann. Genau das macht Qwen3.5-Omni so interessant.
Thinker-Talker-Architektur
Das Herzstück des Modells ist eine zweiteilige Architektur, die das Team Thinker-Talker nennt. Das Thinker-Modul nimmt die Umgebung wahr. Es empfängt Bilder über einen visuellen Encoder, tokenisiert Audio mit einem speziellen Audio-Transformer und hält alles mithilfe einer zeitorientierten Positionskodierung (TMRoPE) zusammen, die verschiedene Eingabetypen synchronisiert.
Das Talker-Modul generiert anschließend aus diesen Repräsentationen Antworten, und zwar auch per Sprache in Echtzeit. Das Ganze läuft als Stream, sodass das Modell nicht warten muss, bis es die vollständige Eingabe verarbeitet hat. Es reagiert fortlaufend.
Unter der Haube arbeitet ein hybrider Mixture-of-Experts-Mechanismus (MoE). Von insgesamt 397 Milliarden Parametern werden bei einer einzelnen Anfrage nur etwa 17 Milliarden aktiviert. Stellen Sie sich das wie ein riesiges Team von Spezialisten vor, von denen immer nur diejenigen arbeiten, die für die jeweilige Aufgabe benötigt werden. Das Ergebnis? Eine mit monolithischen Giganten vergleichbare Leistung, aber zu einem Bruchteil der Rechenkosten.
Bessere Ergebnisse als die Konkurrenz
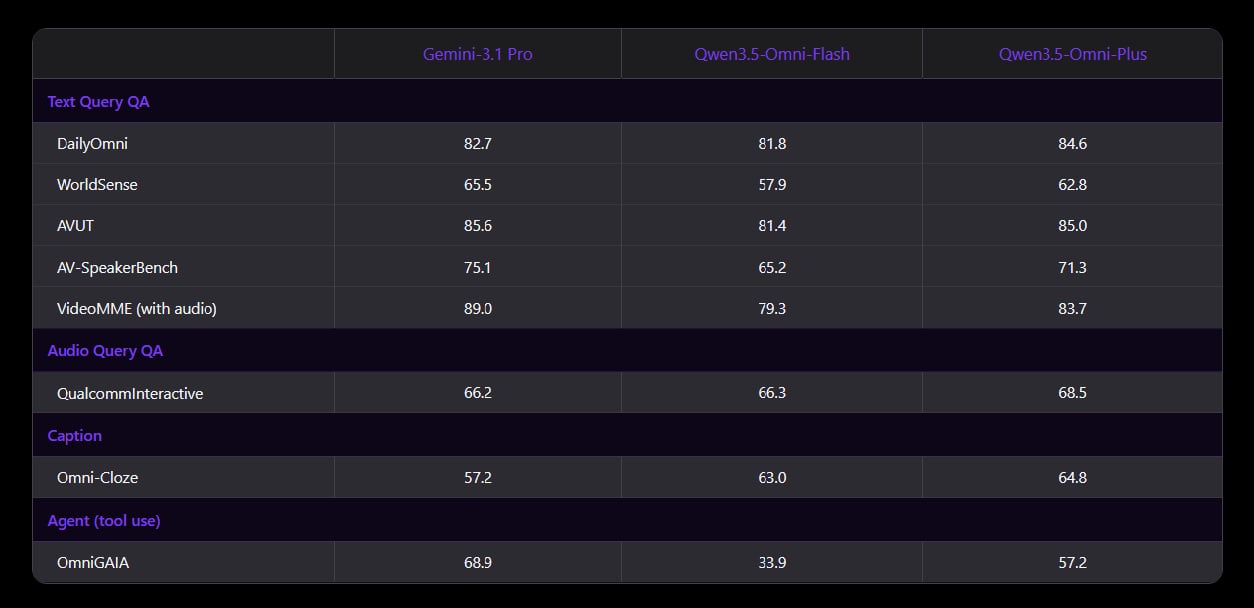
Qwen3.5-Omni-Plus erzielte in 215 Audio- und audiovisuellen Benchmarks die besten Ergebnisse. Im DailyOmni-Test erreichte es 84,6 Punkte gegenüber 82,7 Punkten bei Gemini 3.1 Pro. Bei der Spracherkennung im Librispeech-Datensatz erreichte es eine Fehlerquote von lediglich 1,11 %, während Gemini auf 3,36 % kommt.
Im IFBench-Test, der die Fähigkeit misst, komplexe Anweisungen präzise zu befolgen, erreichte die Version Qwen3.5-397B 76,5 % und übertraf damit GPT-5 High mit 73,1 %. Im MMLU-Pro-Benchmark, der auf fundiertes Fachwissen ausgerichtet ist, liegt GPT-5 mit 87,1 % zwar weiterhin vorn, doch Qwen ist ihm mit 86,3 % dicht auf den Fersen.
Was interessiert Führungskräfte jedoch mehr als Benchmarks? Der Preis. Ein API-Aufruf kostet weniger als 0,11 US-Dollar pro Million Token. Das ist ungefähr ein Zehntel dessen, was die Konkurrenz verlangt. Mit einer Latenz bis zum ersten Paket von etwa 234 Millisekunden antwortet das Modell zudem so schnell, dass eine Unterhaltung mit ihm einem normalen Gespräch ähnelt.
Tschechisch, das endlich nicht mehr roboterhaft klingt
Einer der größten Fortschritte betrifft die Sprachunterstützung. Das Modell erkennt Sprache in 113 Sprachen und Dialekten und kann in 36 Sprachen Sprache erzeugen. Tschechisch gehört zu den unterstützten Sprachen, auch bei der Sprachsynthese.
Hinter der Natürlichkeit der Stimme steht die Technologie ARIA (Adaptive Rate Interleave Alignment), die Text- und Spracheinheiten dynamisch aufeinander abstimmt. Sie löst Probleme, unter denen ältere Modelle litten: verschluckte Endungen, falsche Deklination von Zahlwörtern oder unnatürliche Pausen. Der Wert für die Natürlichkeit der Stimme (UTMOS) erreicht 4,16 von 5 und kommt damit menschlicher Sprache nahe.
Interessant ist auch die Funktion der semantischen Unterbrechung. Wenn Sie dem Modell ins Wort fallen, verstummt es sofort und reagiert auf Ihren neuen Impuls. Hintergrundgeräusche und Füllwörter ignoriert es dabei. Wer schon einmal versucht hat, auf einer belebten Straße mit einem Sprachassistenten zu sprechen, wird das zu schätzen wissen.
Vibe Coding: zeigen, beschreiben und Code erhalten
Eine der beeindruckendsten Demonstrationen? Das sogenannte Audio-Visual Vibe Coding. Sie richten die Kamera auf eine auf Papier gezeichnete Skizze einer Benutzeroberfläche, beschreiben per Sprache, was die Anwendung tun soll, und das Modell generiert funktionsfähige Komponenten in React oder HTML. Sie zeigen ihm einfach, was Sie meinen, und sagen, was Sie möchten. Es schreibt den Code.
Das Modell kann dabei mehr als 10 Stunden Audio oder 400 Sekunden hochauflösendes Video in einem einzigen Kontextfenster mit einer Länge von 256.000 Token verarbeiten. Das eröffnet Möglichkeiten zur Analyse vollständiger Besprechungen, Vorlesungen oder industrieller Videoaufzeichnungen, ohne dass Kontext verloren geht.
Offenes Modell
Die Veröffentlichung unter der Apache-2.0-Lizenz bietet Unternehmen, die mit sensiblen Daten arbeiten (Gesundheitswesen, Finanzwesen, öffentliche Verwaltung), die Möglichkeit, das Modell auf eigenen Servern zu betreiben, ohne Informationen an externe Stellen zu übermitteln. Damit werden die Anforderungen der europäischen Datenschutzvorschriften unmittelbar erfüllt.
Kleinere Varianten des Modells (etwa mit 35 Milliarden Parametern) benötigen dabei lediglich eine Grafikkarte mit 24 GB Speicher. Mit der Technik FOMOE (Fast Opportunistic MoE) und dem intelligenten Laden von Experten von NVMe-Laufwerken lässt sich sogar die Vollversion mit 397 Milliarden Parametern auf einer gewöhnlichen Workstation ausführen. Dabei wird eine Geschwindigkeit von etwa 9 Token pro Sekunde erreicht, was für einen Unternehmens-Chatbot mehr als ausreichend ist.
Drei Modellversionen
Das Modell ist in drei Größen erhältlich: Plus, Flash und Light. Plus ist das Flaggschiff für maximale Genauigkeit, Flash bietet das beste Verhältnis von Leistung und Geschwindigkeit, Light eignet sich für Implementierungen mit begrenzten Ressourcen. Alle unterstützen ein Kontextfenster von 256.000 Token.
Der Zugriff ist über die Offline-API (Stapelverarbeitung, lange Dokumente, detaillierte Videobeschreibungen) oder die Realtime-API (Live-Interaktion, Sprachassistent, Funktionsaufrufe und Websuche) möglich. Es ist auch über Qwen Chat und Alibaba Cloud Model Studio verfügbar.
Wer sich für Cybersicherheit interessiert, dürfte sich darüber freuen, dass die Community bereits modifizierte Varianten ohne Sicherheitsfilter erstellt hat, die sich beispielsweise für die forensische Analyse von Malware in einer isolierten Umgebung eignen. Das Modell führt schlicht sein eigenes Leben, und Entwickler aus aller Welt passen es an ihre Bedürfnisse an.


