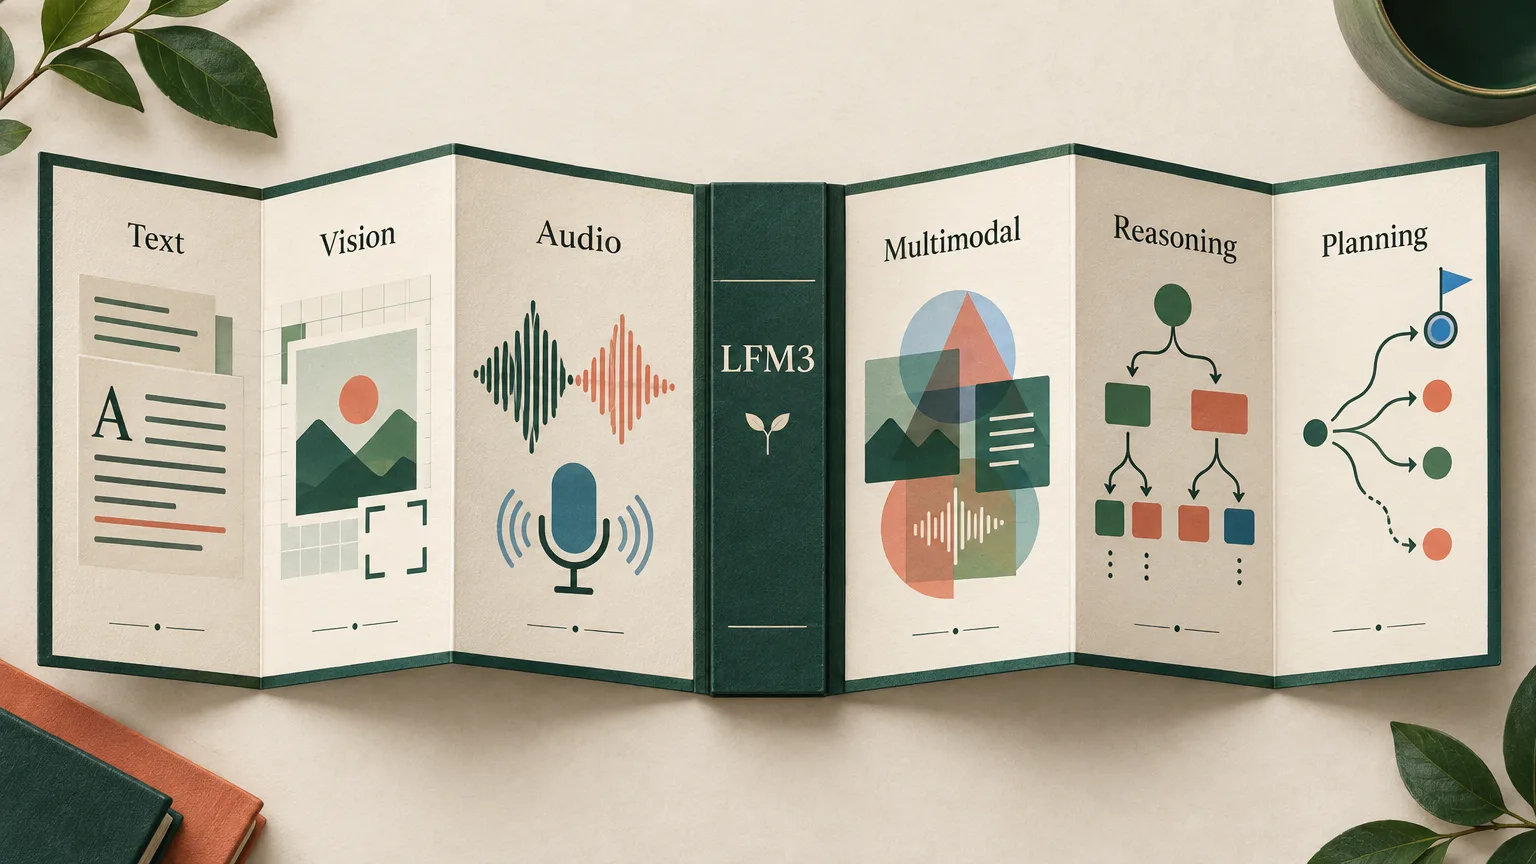
Liquid AI vydala LFM3, rodinu šesti malých modelů s otevřenými váhami pro práci s textem, obrazem, zvukem a strukturovanými rozhodnutími. Modely jsou určené k dodatečnému doučení na jedné grafické kartě a k nasazení v telefonech, laptopech, edge systémech i cloudu.
Společný základ a textový model pro agenty
Všechny varianty vycházejí ze základu LFM3-1.7B-Base a dostávají další součásti a dodatečný trénink podle svého zaměření. Textový LFM3-1.7B podporuje volání nástrojů a práci agentů a má kontextové okno až 256 tisíc tokenů. Podle Liquid AI překonává předchozí LFM2.5-2.6B, přestože má o 35 % méně parametrů.
Základní architektura má 24 vrstev. Třináct z nich používá krátké konvoluce, pět pracuje s pozorností nad klouzavým oknem posledních 256 tokenů a šest s globální pozorností nad celým dostupným kontextem.
V agentních testech Liquid AI dosáhl LFM3-1.7B skóre 45,6 na LiveClaw a 38,42 na WebArena-Verified. Srovnávaný Qwen3.5-9B získal 35,77 a 28,94. V testu BFCL V4, který hodnotí volání funkcí, firma naměřila novému modelu 71,39.
Paměť a rychlost při generování
Pro dlouhý kontext je důležitá také paměť potřebná k uchování stavu pozornosti během generování. Při délce 128 tisíc tokenů naměřila Liquid AI u LFM3-1.7B spotřebu 1,6 GB pro tuto cache. Ve stejném srovnání potřeboval Qwen3.5-4B 4,3 GB a MiniCPM5-2B 5,6 GB.
Při použití llama.cpp a čtyřbitové kvantizace Q4_0 generoval textový model podle firmy na třech cílových zařízeních 1,8–2,8krát rychleji než další nejrychlejší testovaný model.
Obrazový model zpracovává i video
LFM3-VL-2B přijímá obrázky a video. Jeho nový obrazový enkodér má 164 milionů parametrů a podle Liquid AI potřebuje přibližně třetinu výpočetního výkonu enkodéru SigLIP2 použitého v předchozích modelech firmy. Při zpracování videa spojuje dvojice vzorkovaných snímků do jednoho časového řezu, čímž zkracuje výslednou sekvenci tokenů na polovinu.
V souhrnném srovnání Liquid AI na 62 obrazových benchmarcích se novinka vyrovnala modelu Gemma 4 12B a překonala Gemini 3.5 Flash Lite. Slabší oblastí zůstalo agentní vidění, kde dosáhla průměru 42,5 a výrazně zaostala za nejpokročilejšími systémy.
Firma předvedla také specializaci modelu na kontrolu větrných turbín. Po několika hodinách doučování na jedné Nvidia A100 s přibližně 3 000 veřejnými snímky vzrostla v její demonstraci přesnost klasifikace vad z méně než 10 % na 67 %.
Liquid AI jej rovněž testovala při generování řídicích akcí pro robotiku. Ve čtyřech sadách LIBERO uvedla průměrnou úspěšnost 96,2 %, zatímco při stolních úlohách RoboCasa-GR1 dosáhla 45,7 %.
Řeč a multimodální vstupy
LFM3-Audio-2B přijímá a vytváří řeč v 18 jazycích a podporuje volání nástrojů. Příchozí zvuk dokáže zpracovávat už během promluvy. Liquid AI naměřila čas do prvního tokenu až 50 milisekund; celkovou latenci aplikace ale ovlivňují také detekce konce řeči, síť, vykonání nástrojů a přehrávání zvuku.
V interním testu volání nástrojů získal zvukový model 58,5 proti 44,3 u Qwen2.5-Omni-3B. V testu obecného porozumění zvuku MMAR naopak podle výsledků Liquid AI dosáhl 50,6, zatímco MiMo-Audio-7B získal 62,3. Další varianta, LFM3-Omni-2B, spojuje obraz, zvuk a jazyk v jednom modelu.
Modely d1 vracejí strukturované odpovědi
Dvojice rozhodovacích modelů přijímá vstup a seznam otázek, které zodpoví společně v jednom průchodu. Výstup může obsahovat ohraničení objektů, úryvky zdrojového textu, číselné rozsahy nebo výběr možností s kalibrovanými pravděpodobnostmi. Varianta d1-Omni-2B vedle textu a obrázků přijímá také zvuk.
Podle Liquid AI má d1-2B o třetinu méně parametrů než předchozí d1-3B. Ve firemním souhrnném indexu zahrnujícím 117 benchmarků dosáhl skóre 63,2 proti 58,8 u starší verze.
Kde jsou modely dostupné
Váhy modelů jsou ke stažení na Hugging Face. Hostovaný přístup nabízí API a Playground Liquid AI i platformy Qualcomm AI Hub a Vercel.
Mezi podporované nástroje pro běh modelů patří llama.cpp, MLX, vLLM, Ollama, LM Studio, Unsloth a SGLang. Celá rodina je navržená tak, aby ji bylo možné dodatečně doučit na jedné GPU.