Výzkumníci z laboratoře umělé inteligence Svobodné univerzity v Bruselu a z Univerzity v Namuru ukázali, že skupina samostatných programů si dokáže sama vytvořit funkční a společný způsob komunikace. Deset počítačových agentů, žádný slovník a milion krátkých rozhovorů. Nic víc belgičtí vědci nepotřebovali, aby umělá inteligence přišla s vlastním jazykem.
Proč strojům nestačí lidská řeč
Velké jazykové modely jako ChatGPT se učí jazyk, který už existuje. Prošly obrovské množství lidských textů a naučily se je napodobovat. Belgický tým to zkusil jinak. Jeho agenti se nic nebiflují. Slova si vymýšlejí sami a vážou je přímo na to, co zachytí svými čidly.
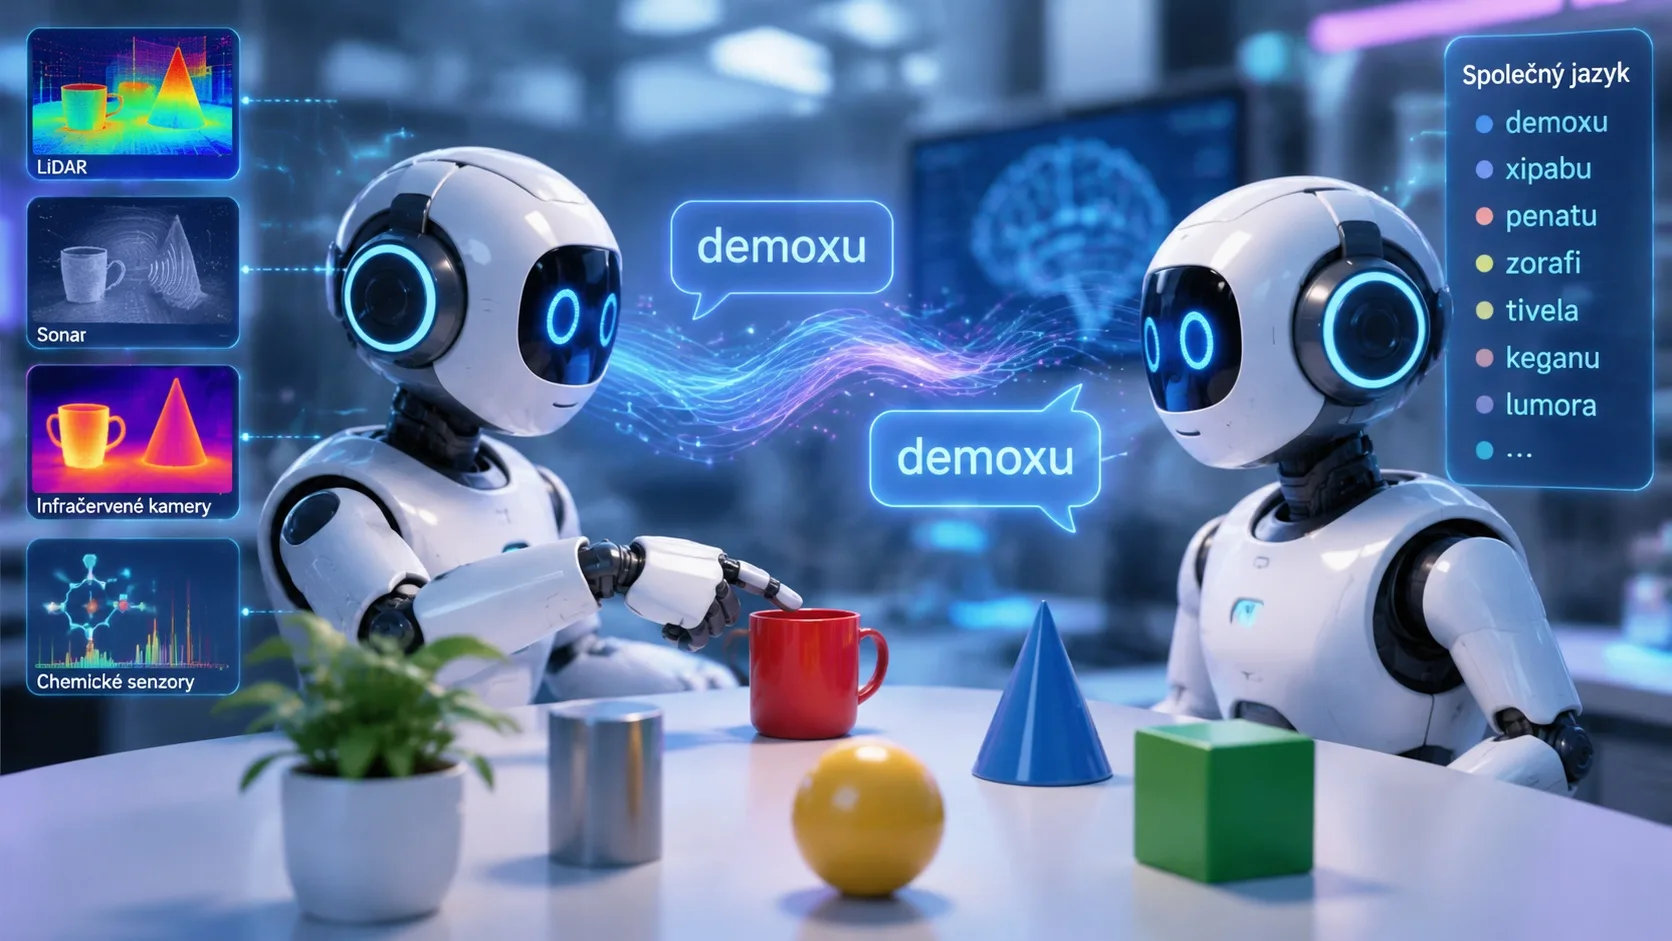
Ptáte se, proč to dělají? Lidské jazyky vznikly z lidských smyslů. Máme slova pro barvy, zvuky nebo chutě, protože je sami vnímáme. Stroje ale používají senzory, pro které člověk žádnou obdobu nemá, například lidar, sonar, infračervené kamery nebo přístroje na chemický rozbor. Pro to, co měří, nemá výstižná slova žádný lidský jazyk.
Doktorand Jérôme Botoko Ekila, hlavní autor studie, vysvětluje, že místo nucení strojů mluvit lidskou řečí, která jejich senzorům neodpovídá, jim tým dovolil vytvořit si vlastní umělý přirozený jazyk. Pojmy, které agenti takhle vytvoří, přesně sedí na to, co vnímají, i když by člověk ze samotných dat nic nevyčetl.
Profesor Paul Van Eecke přidává další důvod. Senzory na dvou robotech nebo autech nikdy nejsou nastavené úplně stejně. Lidé tento problém řeší jazykem. Když někdo řekne, že stojí u červeného auta, druhý ho najde, přestože jejich oči nevidí přesně stejný odstín. Jazyk tak tvoří jakousi vrstvu nad tím, co kdo vnímá, a právě takovou vrstvu si teď roboti vytvořili sami.
Hra na hádání
Agenti začínají jako čistý list. Neznají žádné slovo ani kategorii a o světě nevědí vůbec nic. Každý předmět kolem sebe vnímají jen jako řadu čísel ze svých čidel. Vědci jim dali pouze tři základní schopnosti, na kterých podle nich stojí i vývoj lidských jazyků. Agenti umějí vymyslet nové slovo, postupně ladit jeho význam a poučit se z toho, jestli se s druhým domluvili. Program vybere dva náhodné agenty a ukáže jim scénu s deseti předměty. Jeden dostane roli mluvčího a dozví se, na který předmět má druhého upozornit. Řekne slovo a posluchač hádá. Když se trefí, oba si slovo upevní. Když ne, mluvčí mu správný předmět ukáže a oba si význam slova poopraví.
Pokud mluvčí nemá po ruce vhodné slovo, prostě nějaké vymyslí. Slova jsou náhodné shluky tří slabik jako demoxu nebo xipabu a sama o sobě nic neznamenají. Význam získávají teprve tím, jak je agenti používají. Posluchač, který nové slovo slyší poprvé, si ho jednoduše přidá do vlastního slovníku.
Neexistuje žádný centrální počítač, který by určoval pravidla, říká profesorka Katrien Beuls z Namuru. Agenti spolu mluví vždy jen ve dvojicích a společný jazyk celé skupiny vzniká sám z obrovského množství drobných rozhovorů. Podle ní si tak agenti vytvoří přesně tolik kategorií, kolik k úkolu potřebují, a žádné zbytečné.
Na začátku vládne chaos. Každý agent vymýšlí vlastní slova a slovník skupiny rychle bobtná. V testu s obrázky geometrických těles vyskočil až na zhruba 90 slov. Potom se začne čistit. Slova, která fungují, přežijí, a ta neúspěšná postupně mizí. Po milionu rozhovorů zbylo v průměru necelých 50 slov. Úspěšnost domluvy přitom vystoupala na zhruba 96 procent už po 50 tisících rozhovorech a na konci se dostala skoro na sto procent.
Autoři v tom vidí tři fáze. Nejdřív agenti vymýšlejí a zkoušejí, potom se sjednotí na hrubých, ale použitelných pojmech a nakonec už jen dolaďují detaily a zaplňují mezery.
Víno, exoplanety i ptáci
Aby vědci vyloučili šťastnou náhodu, otestovali metodu na 37 různých sadách dat. Agenti se bavili o chemických rozborech vína, o datech NASA o planetách mimo sluneční soustavu, o houbách i o fotkách ptáků a lidských tváří. V sedmi podrobně popsaných případech se úspěšnost pohybovala zhruba mezi 96 a téměř 100 procenty. Agentům k tomu stačilo od 17 do 265 slov a většinu práce odvedlo jen pár desítek z nich.
Na rozdíl od řady systémů umělé inteligence, do kterých nikdo nevidí, se tady dá přesně zjistit, co které slovo znamená. Každé je totiž navázané na konkrétní hodnoty z čidel. Hezky to ukazuje slovo penatu, které vzniklo při rozhovorech o exoplanetách. Vědci zjistili, že agenti jím označují planety zemského typu s poloměrem asi 81 procent Země.
Rozbitá čidla je nezastaví
Tým agentům schválně ztěžoval život. Některým rozladil čidla, jiným do měření přidal šum. Sestavil i skupiny, ve kterých každý agent vnímal svět jinou sadou senzorů. V dalším pokusu všem agentům po 500 tisících rozhovorech najednou vypnul jedno nebo dokonce polovinu čidel.
Jazyk se pokaždé přizpůsobil. Agenti se sice méně shodovali v tom, jaké slovo pro co použít, protože každý sahal po výrazech, které nejlépe seděly jeho vlastním smyslům. Domluvit se ale ve většině případů dokázali dál. Pro srovnání vědci vyzkoušeli i jednodušší postup, kdy si každý agent rozdělí svět do pevných škatulek a teprve k nim se hledají jména. Dokud všichni vnímali stejně, fungoval slušně. Jakmile se jejich vnímání rozešlo, úspěšnost spadla na hodnoty od zlomku procenta po zhruba 43 procent.
Výzkumníci zkoušeli i větší skupiny až se stovkou agentů. Těm trvalo déle, než se shodly, výsledný slovník ale vyšel menší. Autoři to vysvětlují tím, že ve větší skupině vzniká víc nápadů a z nich se lépe vybírají ty nejlepší. Když agentům dovolili skládat až pět slov za sebou, slovníky se zmenšily na 17 až 48 slov, učení se ale protáhlo víc než desetkrát. Agenti si přesto v 95 procentech případů vystačili s jediným slovem.
Z laboratoře mezi stroje
Autoři vidí uplatnění všude tam, kde se spolu musejí domlouvat stroje. Jde o samořiditelná auta, roboty nebo průmyslová čidla, jejichž senzory nikdy nebudou nastavené na chlup stejně. Právě takové prostředí podle nich jazyk, který si stroje vybudují samy, zvládne lépe než předem naprogramované kódy.
Výpočetně přitom nejde o nic náročného. Milion rozhovorů zvládne běžný serverový procesor za šest až osm hodin a zdrojový kód vědci zveřejnili. V samotné studii zdůrazňují, že ji psali bez pomoci generativní umělé inteligence. Výzkum financovaly belgické vědecké fondy FWO a FNRS v rámci společného projektu WEAVE.