

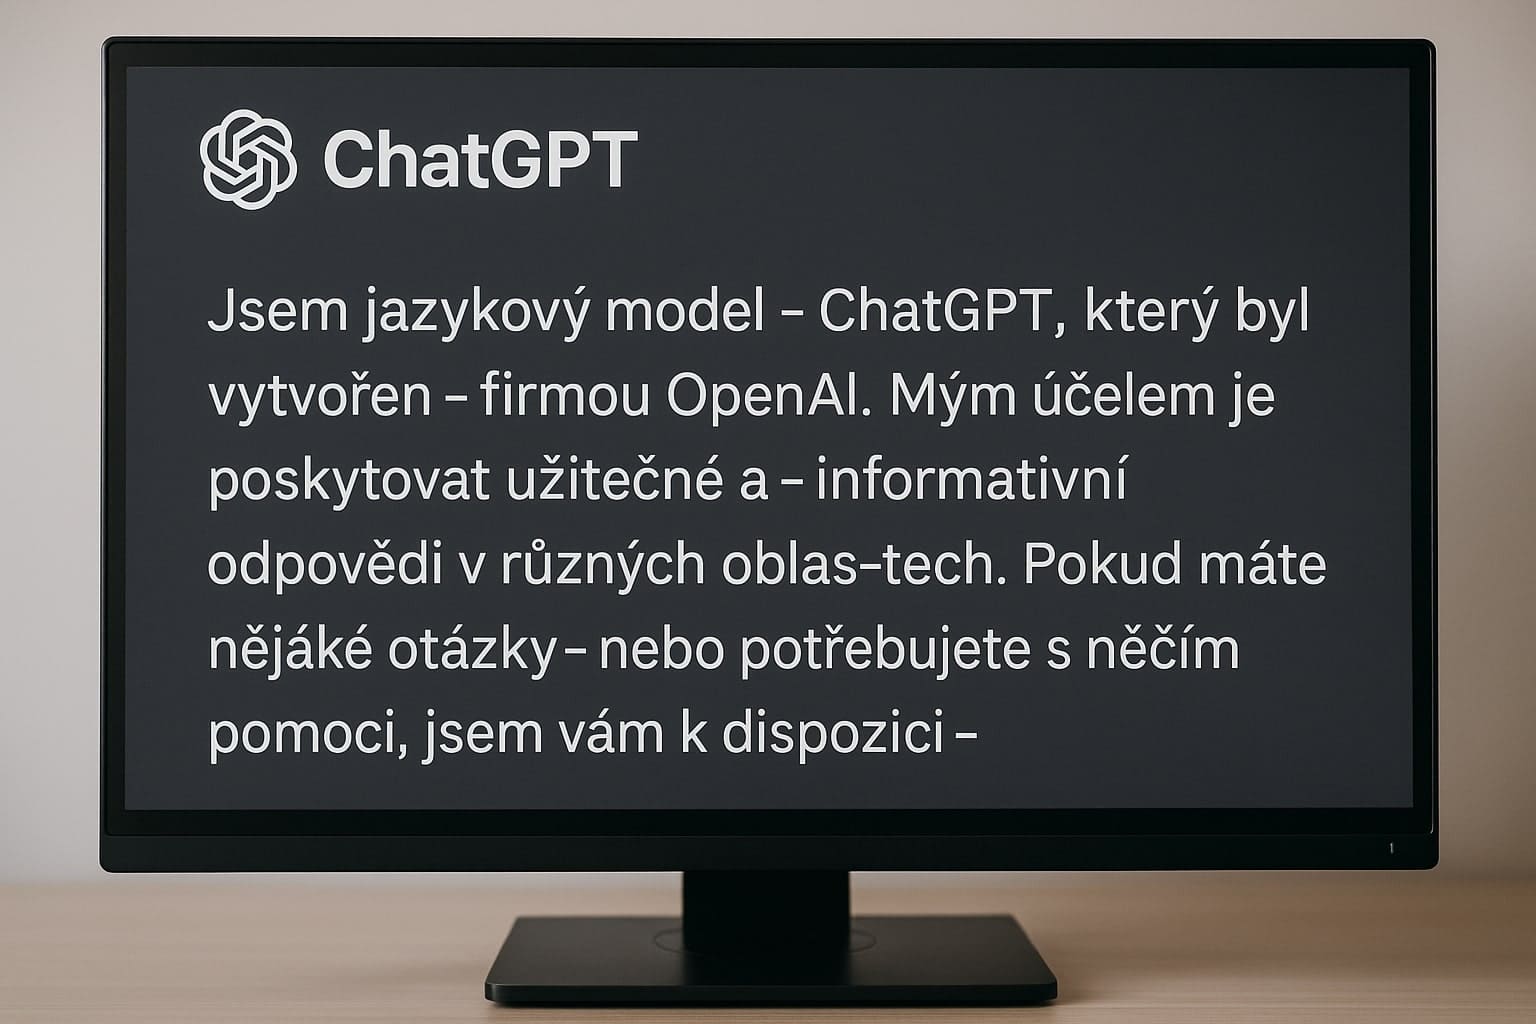
Was ist ein langer Gedankenstrich und wie verwendet ihn die KI?
Ein langer Gedankenstrich, im Englischen als Em-Dash bekannt, dient dazu, Gedanken in einem Text voneinander abzugrenzen – beispielsweise um eine Erklärung einzufügen oder eine Pause zu erzeugen. In gewöhnlichen, von Menschen verfassten Texten kommt er gelegentlich vor, doch in Texten moderner KI-Modelle wie GPT-4o findet man ihn sehr häufig. Sean Goedecke bemerkte, dass es zwischen 2022 und 2024 zu einer großen Veränderung kam. Das ältere Modell GPT-3.5 verwendete lange Gedankenstriche ähnlich wie Menschen in heutigen Texten, doch das neuere GPT-4o setzt sie drastisch häufiger ein. Das veranlasste ihn, nach den Gründen zu suchen.
Goedecke vergleicht Daten verschiedener Modelle und stellt fest, dass diese Veränderung damit zusammenhängt, wie diese Systeme trainiert werden. Künstliche Intelligenz lernt aus riesigen Mengen an Texten, die als Trainingsdaten dienen. Wenn sich diese Daten ändern, ändert sich auch der Schreibstil der KI.
Die Haupthypothese: Digitalisierung alter Bücher
Sean Goedecke vermutet, dass der Schlüssel zu diesem Phänomen in der Art und Weise liegt, wie Trainingsdaten für neuere Modelle gewonnen werden. Seiner Analyse zufolge begannen Labore wie OpenAI zwischen 2022 und 2024, mehr digitalisierte gedruckte Bücher zu verwenden. Diese Bücher stammen häufig aus dem 19. Jahrhundert, als die Verwendung langer Gedankenstriche ihren Höhepunkt erreichte. Konkret zitiert er eine Studie, die zeigt, dass die Häufigkeit von Gedankenstrichen in den 1860er-Jahren ihren Höchststand erreichte.
Warum ausgerechnet alte Bücher? Goedecke erklärt, dass ältere Modelle wie GPT-3.5 hauptsächlich mit aktuellen Inhalten aus dem Internet trainiert wurden, häufig aus illegal verbreiteten Quellen. Neuere Modelle benötigen jedoch hochwertigere Daten, weshalb die Labore auf öffentlich zugängliche digitalisierte Bücher aus der Vergangenheit zurückgreifen. Diese Texte enthalten 30 % mehr lange Gedankenstriche als moderne Texte. Das Ergebnis? Die KI erlernt diesen Stil und wendet ihn in ihren Ausgaben an.
Goedecke weist darauf hin, dass diese Veränderung der Daten nicht zufällig ist. Die Labore suchen nach Möglichkeiten, die Qualität zu verbessern, und die Digitalisierung älterer Werke stellt ihnen reichhaltiges Material zur Verfügung. Dennoch bleibt ein Paradox bestehen: Obwohl die KI so viele lange Gedankenstriche verwendet, ähnelt ihr allgemeiner Schreibstil in anderer Hinsicht kaum dem des 19. Jahrhunderts.
Alternative Erklärungen, die Goedecke in Betracht zieht
Goedecke beschränkt sich nicht auf eine einzige Idee. Er erwähnt auch andere mögliche Gründe, hält sie jedoch für weniger wahrscheinlich. Beispielsweise könnte der als RLHF (bestärkendes Lernen aus menschlichem Feedback) bezeichnete Prozess lange Gedankenstriche bevorzugen, weil sie dem Text einen konversationellen Ton verleihen. Menschen, die KI-Ausgaben bewerten, könnten einen solchen Stil bevorzugen.
Eine weitere Idee hängt mit Plattformen wie Medium zusammen, auf denen doppelte Bindestriche automatisch in lange Gedankenstriche umgewandelt werden. Wenn die Trainingsdaten viele Inhalte von Medium enthielten, könnte dies die KI beeinflusst haben. Goedecke hält diese Erklärung für unzureichend, da sie den allgemeinen Anstieg der Verwendung nicht erklären kann.
In den Kommentaren zum Artikel finden sich auch Reaktionen aus der Community. Ein Kommentator behauptet, dass gerade das Verhalten von Medium hinter allem stecke, doch Goedecke hält dies für eine zu eng gefasste Erklärung.
Warum bleibt die Erklärung spekulativ?
Sean Goedecke ist offen und räumt ein, dass seine Schlussfolgerungen spekulativ sind. Ohne direkte Informationen darüber, wie OpenAI und andere Labore ihre Daten beschaffen, lässt sich nichts mit hundertprozentiger Sicherheit bestätigen. Keine einzelne Ursache wird allgemein akzeptiert. Dennoch scheint seine Haupttheorie – dass die Digitalisierung älterer Bücher aus dem 19. Jahrhundert zum verstärkten Einsatz langer Gedankenstriche geführt hat – die überzeugendste zu sein.
Dieses Phänomen beeinflusst auch Menschen: Einige Autoren verzichten inzwischen auf lange Gedankenstriche, damit ihre Texte nicht wie von einer KI generiert wirken. Goedecke beschreibt all dies detailliert, jedoch ohne unnötige Spekulationen, die über die verfügbaren Daten hinausgehen.


