Reka hat eine Forschungsvorschau von Rho-1 veröffentlicht. Das Modell mit 19 Milliarden Parametern verarbeitet und erzeugt Text, Bilder, Video und Roboteraktionen in einem einzigen Checkpoint. Erzeugte Medien und Steuersignale bleiben im gemeinsamen Kontext erhalten, sodass weitere Schritte derselben Sitzung darauf aufbauen können, ohne den Zustand zwischen separaten Modellen übertragen zu müssen.
Vom Leuchtturmbild zur Videobearbeitung
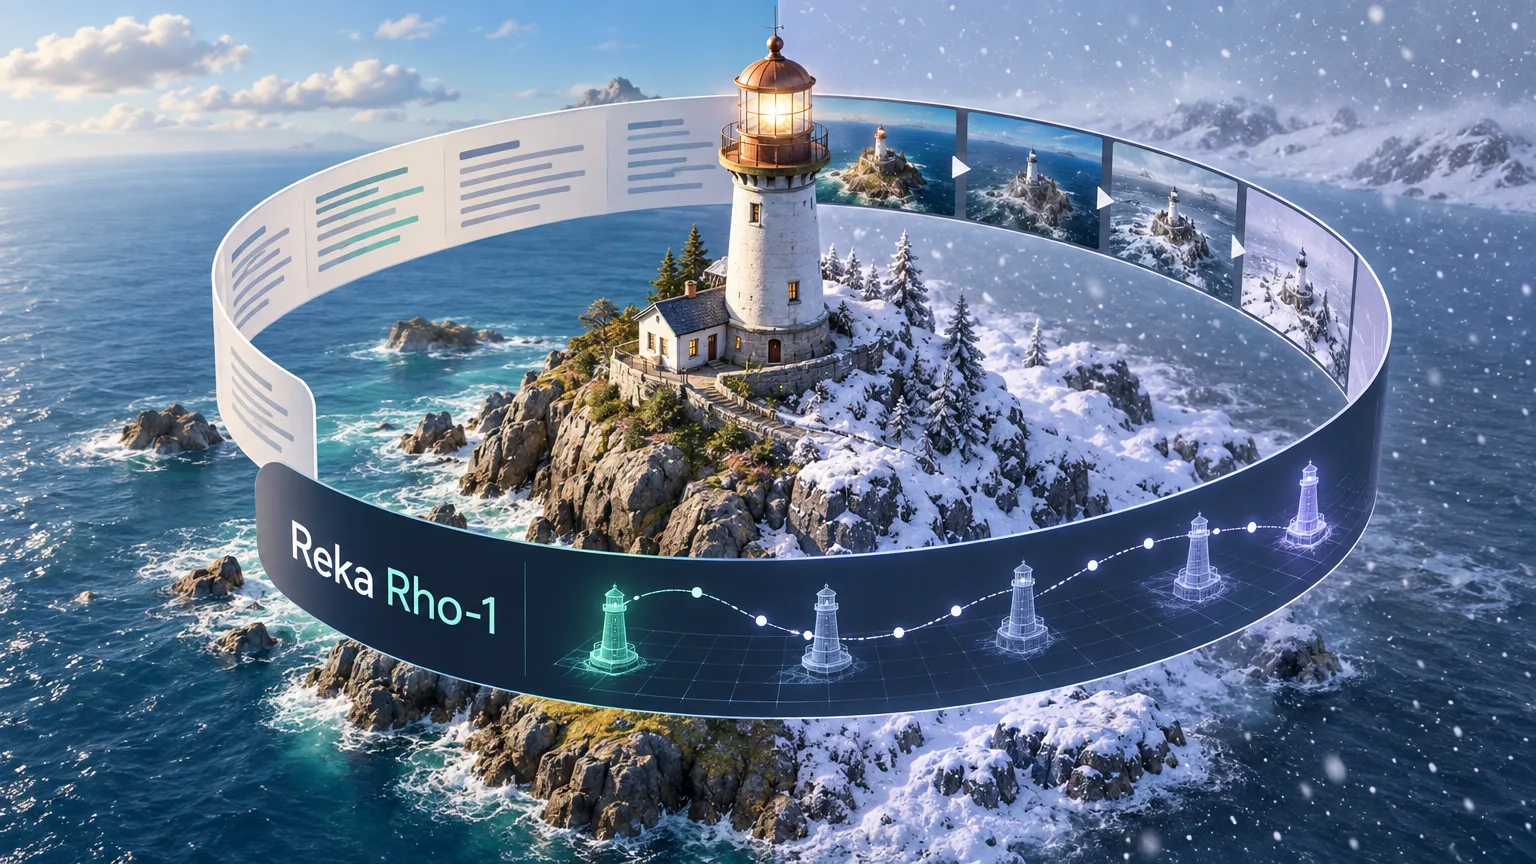
Reka demonstrierte das Zusammenspiel der Aufgaben anhand einer Szene mit einem Leuchtturm. Zunächst erzeugte das Modell ein Bild und markierte darin auf eine weitere Anweisung hin den Leuchtturm mit einem Begrenzungsrahmen. Anschließend animierte es die Szene als Drohnenanflug und fügte dem Video einen Schneesturm hinzu, wobei die Kamerabewegung erhalten blieb.
Zum Abschluss wechselte die Demonstration von der Erzeugung zurück zur Analyse: Rho-1 erläuterte die Unterschiede zwischen den entstandenen Videos. Ein einziges Modell bearbeitete die gesamte Abfolge und hielt den Sitzungszustand zwischen Bilderzeugung, Objektlokalisierung, Animation und sprachlichem Vergleich der Ergebnisse aufrecht.
Zwei Rechenzweige mit gemeinsamer Aufmerksamkeitsberechnung
Laut Rekas Forschungsbeschreibung teilt sich jeder Transformer-Block in zwei Zweige, die eine gemeinsame Aufmerksamkeitsberechnung nutzen. Der Zweig für das Verstehen verarbeitet Sprache, Token für Schlussfolgerungen und visuelle Informationen und gibt diskrete Token aus. Der generative Zweig nutzt dagegen Flow Matching, um kontinuierliche interne Darstellungen zu entrauschen, aus denen Bilder und Videos entstehen.
Diese Aufteilung zeigt sich auch in den Datenformaten. Text, symbolisches Schlussfolgern und übergeordnete Befehle werden als diskrete Token dargestellt. Kontinuierliche Repräsentationen tragen interne Bildrepräsentationen und Videobilder, aber auch Roboteraktionen und Propriozeption, etwa Angaben zur Position und Bewegung von Gelenken.
Rho-1 Flash und Richtungswechsel während der Generierung
Reka nennt für das Basismodell Rho-1 insgesamt 99 Entrauschungsschritte, eine mediane Generierungsgeschwindigkeit von 0,79× Echtzeit und den Beginn des Videostreams nach ungefähr sechs Sekunden. Die destillierte Variante Rho-1 Flash verwendet acht Schritte und erzeugt dem Unternehmen zufolge ein 5,3 Sekunden langes Video in etwa einer Sekunde. Bei der Videobearbeitung soll sie mit derselben Schrittzahl einen ungefähr einsekündigen Clip in rund 1,1 Sekunden neu rendern.
Eine weitere Demonstration von Reka zeigte, wie sich die Flugrichtung während der Videoerzeugung ändern lässt. Eine halbe Sekunde nach Beginn einer Flugsequenz trafen Anweisungen ein, nach links oder rechts zu neigen. Die beiden daraus entstandenen Varianten behielten dieselben Anfangsframes bei und folgten erst danach unterschiedlichen Flugbahnen.
Roboteraktionen in der LIBERO-Simulation
Den Robotikteil demonstrierte Reka in einer Simulationsaufgabe von LIBERO. Rho-1 erzeugte gleichzeitig sieben Aktionskanäle und eine Vorhersage des Bildes einer Kamera am Handgelenk des Roboters. Die Demonstration verband damit Steuerungsausgaben und visuelle Vorhersagen in einer Simulation, nicht in einem dokumentierten Einsatz auf einem physischen Roboter.
In seiner Forschung kombiniert das Unternehmen Rho-1 außerdem mit seinem Modell für inverse Dynamik. Dieses schätzt aus beobachtetem Video die Steuersignale, die die gezeigte Bewegung ausgelöst haben könnten, und kann geeignetes unbeschriftetes Videomaterial in abgeleitete Aktionsdaten umwandeln. Ob diese Daten nutzbar sind, hängt davon ab, wie gut das Videomaterial zum Einsatzgebiet passt und wie genau die Steuersignale geschätzt wurden.
Gemeinsame Modellbasis auf 320 GPUs trainiert
Der für die veröffentlichten Ergebnisse verwendete Checkpoint wurde drei Monate lang auf 320 Nvidia-H100-GPUs von Grund auf trainiert. Dieser Trainingslauf umfasste Sprache, visuelles Verstehen, Medienerzeugung und Steuerung innerhalb einer gemeinsamen Modellbasis.
Laut Rekas Forschungsbeschreibung verfolgt das Training gleichzeitig zwei Ziele. Die Vorhersage des nächsten Tokens dient diskreten Sequenzen wie Text und symbolischen Befehlen. Flow Matching wird für die kontinuierliche Erzeugung von Bildern, Videos und Aktionstrajektorien eingesetzt.
Längere Videos verlieren räumliche Konsistenz
Reka nennt strukturellen Drift bei längerer Generierung als eine der Grenzen des Modells. Ein 30-sekündiger Stream kann Texturen und feine Details erhalten, während sich die Raumaufteilung in eine räumlich inkonsistente Anordnung verändert. Nativ erzeugtes Video ist auf eine Auflösung von 672 × 384 Pixeln begrenzt.
Dem Unternehmen zufolge funktionieren Begrenzungsrahmen auf statischen Bildern, verfolgen Objekte in Videos jedoch nicht zuverlässig. Auch gezielte Bearbeitungen gelingen bei ausgewählten Prompts, bleiben bei einem breiteren Spektrum an Eingaben aber unzuverlässig.
Zugang über Zusammenarbeit auf Reka Cloud
Rho-1 ist bislang als Forschungsvorschau im Rahmen einer Zusammenarbeit auf Reka Cloud zugänglich. Reka hat weder öffentliche Modellgewichte noch eine öffentliche API veröffentlicht, sodass Entwickler das Modell noch nicht direkt in ihre Anwendungen integrieren können.