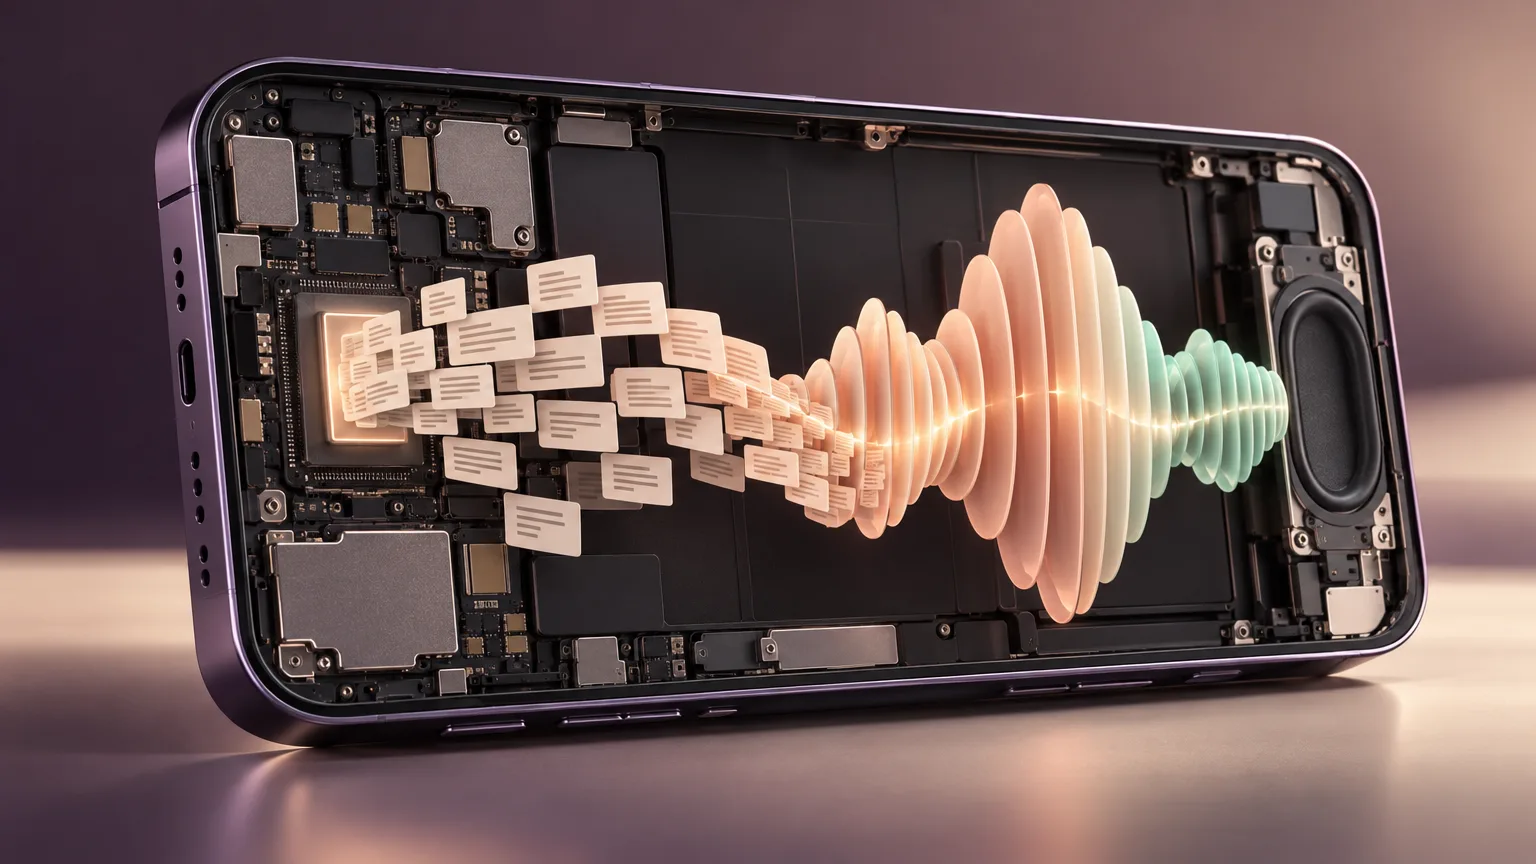
Die Entwickler haben Phonon veröffentlicht, ein kleines Text-zu-Sprache-Modell, das direkt auf dem Gerät und ohne Server oder Netzwerkverbindung läuft. Eingegebener Text verlässt das Gerät dabei nicht. Das Modell ist in zwei Größen erhältlich, unterstützt fünf Sprachen und bietet mehr als 100 vorgefertigte Stimmen.
Zwei Versionen und eigene Stimmen
Phonon ist in Größen von etwa 65 und 75 MB erhältlich. Die Version Phonon 31m spricht Englisch, während Phonon 40m alle fünf Sprachen unterstützt: Englisch, Französisch, Deutsch, Spanisch und Portugiesisch.
Neben den vorgefertigten Stimmen lassen sich in Gradium Studio eigene erstellen. Mit Einwilligung der sprechenden Person kann eine Stimme anhand einer kurzen Aufnahme geklont werden; alternativ lässt sich eine neue Stimme per Text beschreiben. Die fertige Datei wird heruntergeladen und in Phonon geladen, das anschließend auf dem Gerät läuft.
Nach der Ankündigung im April arbeiteten die Entwickler eigenen Angaben zufolge sechs Monate lang mit Partnern und ersten Nutzern an dem Modell. In dieser Zeit verkleinerten sie die Modelle und ergänzten weitere Sprachen sowie die Unterstützung eigener Stimmen.
Auf Telefonen, Computern und im Browser
Phonon lässt sich auf Telefonen, Notebooks und Einplatinencomputern sowie im Browser ausführen. Den Entwicklern zufolge verarbeitet es auch Telefonnummern, Datumsangaben und Codes.
Für das Modell entstand das Inferenz-Framework ptts, das mehr als zehn Backends für CPU, GPU und NPU unterstützt. Dazu gehören unter anderem WebAssembly, CUDA, Metal, WebGPU und Apple Core ML.
Die Referenzimplementierung in PyTorch ist seit Version 5.21 Teil der Bibliothek Transformers. Während ptts einen einzelnen Stream auf dem Gerät verarbeitet, ist die Transformers-Integration auf GPU-Durchsatz, Stapelgenerierung und die Synthese umfangreicher Sprachdatensätze ausgerichtet.
In der Transformers-Integration erzeugt das Modell autoregressiv latente Repräsentationen des Tons, die der Prozessor in Audio dekodiert. Stimmen werden als vorberechnete latente Sprecherrepräsentationen bereitgestellt; der mitgelieferte Audio-Tokenizer dient ausschließlich zum Dekodieren.
Verständlichkeit und Demonstrationen
Phonon baut auf der Pocket-TTS-Reihe auf und verwendet zur Audioerzeugung die Methode Flow Matching. Den Entwicklern zufolge war das Training zunächst numerisch instabil und musste angepasst werden, um in allen fünf Sprachen hochwertige Ergebnisse zu erreichen.
Im Hugging Face Open TTS Leaderboard belegte Phonon nach Angaben der Entwickler bei der Verständlichkeit von Deutsch und Spanisch jeweils den ersten Platz. In jeder von ihnen ausgewerteten Sprache lag es demnach unter den ersten drei. Das Leaderboard misst Verständlichkeit anhand der Wortfehlerrate der Ausgaben. Die Entwickler geben außerdem an, dass die Phonon-Modelle im CPU-Streaming-Test bei der Zeit bis zur ersten Audioausgabe führten.
Begleitende Demonstrationen zeigten einen sprachgesteuerten Begleiter für die Kaffeezubereitung auf einer Apple Watch mit ausgeschaltetem WLAN und das Zählen von Trainingswiederholungen auf einem iPhone ohne Empfang. Laut den Entwicklern wurde Phonon in den ersten zwei Wochen mehr als 200.000-mal heruntergeladen.
Lizenz und kommerzielle Nutzung
Das englischsprachige Phonon 31m steht unter der Lizenz Apache 2.0 und ist auch für kommerzielle Nutzung kostenlos. Phonon 40m hat eine nichtkommerzielle Lizenz; bei kommerzieller Nutzung der übrigen Modelle richtet sich der Preis nach der Zahl der Nutzer und nicht nach der Menge der erzeugten Sprache.