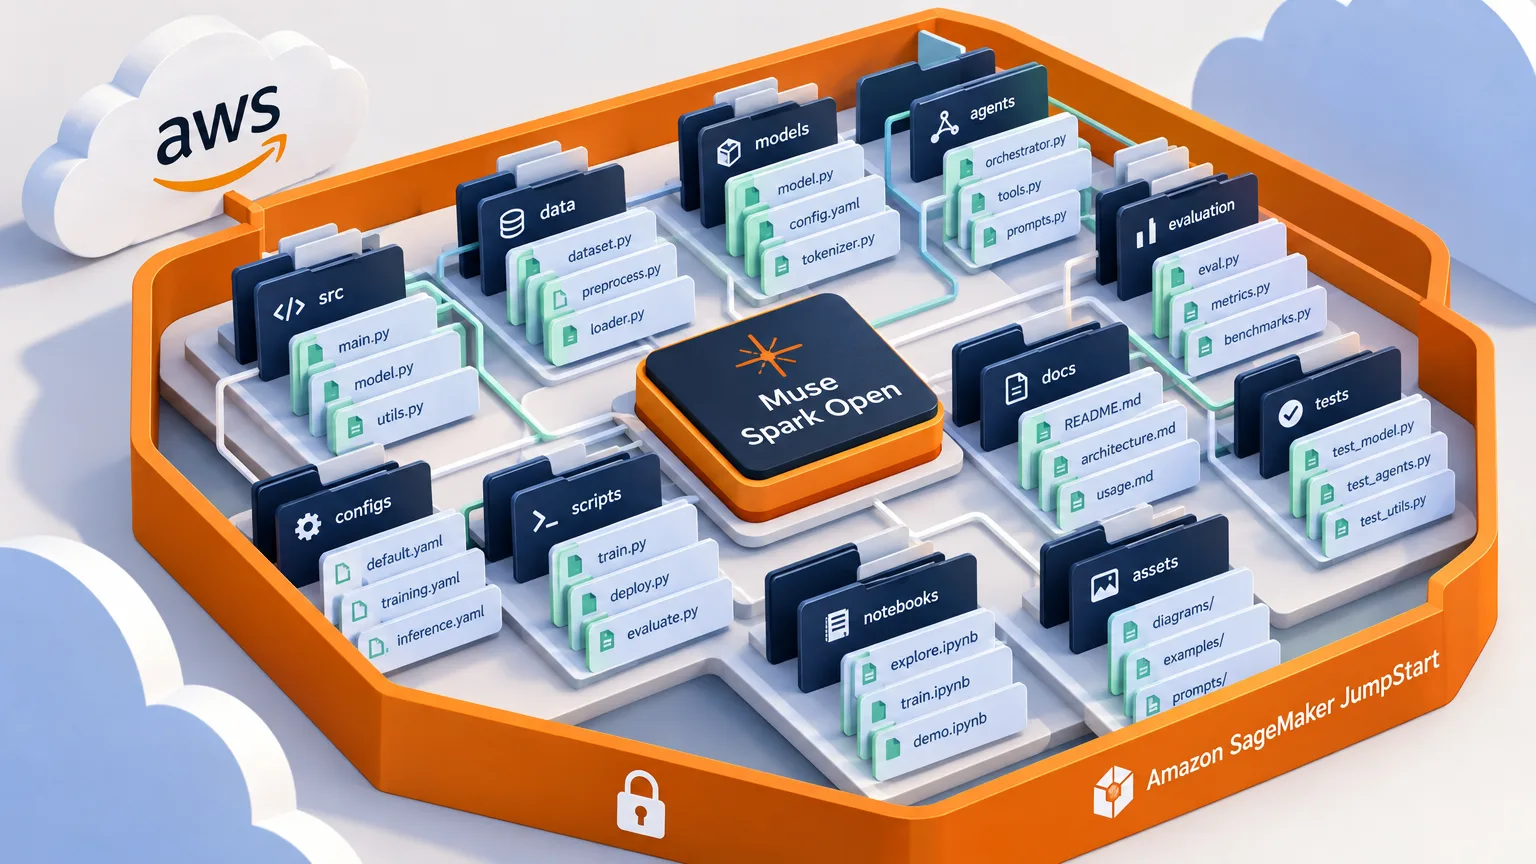
AWS hat Metas Programmiermodell Muse Spark Open mit offenen Gewichten in Amazon SageMaker JumpStart bereitgestellt. Entwickler können es auf einem Endpunkt im eigenen AWS-Konto betreiben; laut AWS soll das Kontextfenster von einer Million Token die Arbeit mit einem vollständigen Projekt samt Abhängigkeiten und Tausenden Dateien ermöglichen.
Training für Refactoring und länger andauernde Agentenaufgaben
Meta hat das Training laut AWS an der Arbeit von Entwicklern in realen Repositories ausgerichtet. Es umfasste neben der Codegenerierung auch Debugging, dateiübergreifendes Refactoring und Aufgaben, deren Bearbeitung längere Zeit beansprucht. In den Kontext lässt sich laut AWS auch älterer Code aufnehmen, nicht nur der gerade bearbeitete Teil eines Projekts.
Nach Angaben von Meta plant das Modell bei länger andauernden Agentenaufgaben sein Vorgehen, führt Aktionen aus, beobachtet deren Ergebnisse und korrigiert daraufhin den eigenen Ansatz, statt lediglich einzelne Werkzeugaufrufe auszuführen.
Zum Training gehörten laut AWS außerdem das Surfen im Web, die Koordination von Teilagenten und die Computerbedienung in Desktop-, Mobil- und Browserumgebungen. Beim Einsatz in SageMaker AI muss allerdings die Anwendung des Kunden oder dessen Agentenframework die benötigten Werkzeuge, den Browser und die Umgebung zur Computerbedienung bereitstellen.
Bild und Ton als Grundlage für Korrekturvorschläge
Die Eingabe ist laut AWS nicht auf Text beschränkt: Das Modell verarbeitet auch Dokumente und Bilder sowie Audio und audiovisuelles Material. Die Ausgabe erfolgt als Text. Als mögliche Anwendung nennt AWS die Verarbeitung von Screenshots, Entwurfsdokumenten oder einer Fehleraufzeichnung mit Bild und Ton, aus denen das Modell einen Plan zur Reproduktion des Problems oder einen Korrekturvorschlag erstellen soll.
Zwei Varianten mit unterschiedlichem Speicherbedarf
Laut AWS verwendet Muse Spark Open eine Mixture-of-Experts-Architektur mit insgesamt 816 Milliarden Parametern. Pro Token sind davon 42 Milliarden aktiv. Für den Betrieb muss der GPU-Speicher dennoch sämtliche 816 Milliarden Parameter aufnehmen können, weshalb nicht allein der aktive Teil des Modells die Anforderungen an das Deployment bestimmt.
JumpStart bietet die BF16-Ausführung unter dem Namen Muse-Spark-Open-816B-A42B und die quantisierte Variante Muse-Spark-Open-816B-A42B-NVFP4 an. Laut AWS benötigen die NVFP4-Gewichte ungefähr ein Viertel des Speichers der BF16-Gewichte. Die NVFP4-Variante läuft auf einer Instanz vom Typ ml.p5e.48xlarge, während BF16 ml.p6-b300.48xlarge nutzt.
Deployment im eigenen Konto und zwei verfügbare Regionen
Das Modell lässt sich über SageMaker Studio oder das SageMaker Python SDK bereitstellen; beide Wege erzeugen einen Endpunkt für Echtzeit-Inferenz. Laut AWS dauern die Bereitstellung der Instanz und das Laden der Gewichte üblicherweise 15–20 Minuten. Zum Start ist das Modell in den Regionen US East (N. Virginia) und US East (Ohio) verfügbar.
Kunden benötigen ein ausreichendes Kontingent für den unterstützten Instanztyp. Für das Deployment per SDK sind Python 3.10 oder neuer und das SageMaker Python SDK v3 erforderlich. Die Gewichte unterliegen der Muse Model License einschließlich der Muse Spark Usage Policy; für die Bereitstellung muss die Endnutzer-Lizenzvereinbarung EULA akzeptiert werden. Im SDK erfolgt die Zustimmung über accept_eula=True.
Der Endpunkt lässt sich an eine eigene Amazon VPC anbinden, sein Speicher mit einem AWS-KMS-Schlüssel verschlüsseln und der Container durch Netzwerkisolation abschirmen. Kunden legen außerdem den Instanztyp und die Skalierungsgrenzen fest. Eine festgelegte Modellversion ändert sich erst bei einem erneuten Deployment.
Der Endpunkt wird während seiner gesamten Laufzeit berechnet, auch ohne eingehende Anfragen; AWS empfiehlt deshalb, ihn nach Abschluss der Nutzung zu löschen.
Chat-API trennt Antwort und Reasoning-Ausgabe
Der Endpunkt akzeptiert OpenAI-kompatible Chat-Anfragen mit einer messages-Liste. Die endgültige Antwort steht im Feld message.content, die Reasoning-Ausgabe dagegen in message.reasoning_content. Die Zahl der für das Reasoning verwendeten Token weist usage.reasoning_tokens aus. Das Limit max_tokens muss genügend Spielraum sowohl für das Reasoning als auch für die endgültige Antwort lassen.
Unterstützt wird auch die fortlaufende Übertragung von Token während der Generierung. Anwendungen aktivieren sie mit "stream": true im Anfragekörper und verwenden statt invoke den Aufruf endpoint.invoke_with_response_stream.