Forscher aus dem Labor für künstliche Intelligenz der Freien Universität Brüssel und der Universität Namur haben gezeigt, dass eine Gruppe eigenständiger Programme selbstständig eine funktionierende gemeinsame Kommunikationsweise entwickeln kann. Zehn Computeragenten, kein Wörterbuch und eine Million kurze Gespräche. Mehr brauchten die belgischen Wissenschaftler nicht, damit die künstliche Intelligenz ihre eigene Sprache entwickelte.
Warum menschliche Sprache für Maschinen nicht ausreicht
Große Sprachmodelle wie ChatGPT lernen eine Sprache, die bereits existiert. Sie haben riesige Mengen menschlicher Texte verarbeitet und gelernt, diese nachzuahmen. Das belgische Team versuchte es anders. Seine Agenten pauken nichts. Sie denken sich die Wörter selbst aus und verknüpfen sie direkt mit dem, was sie über ihre Sensoren erfassen.
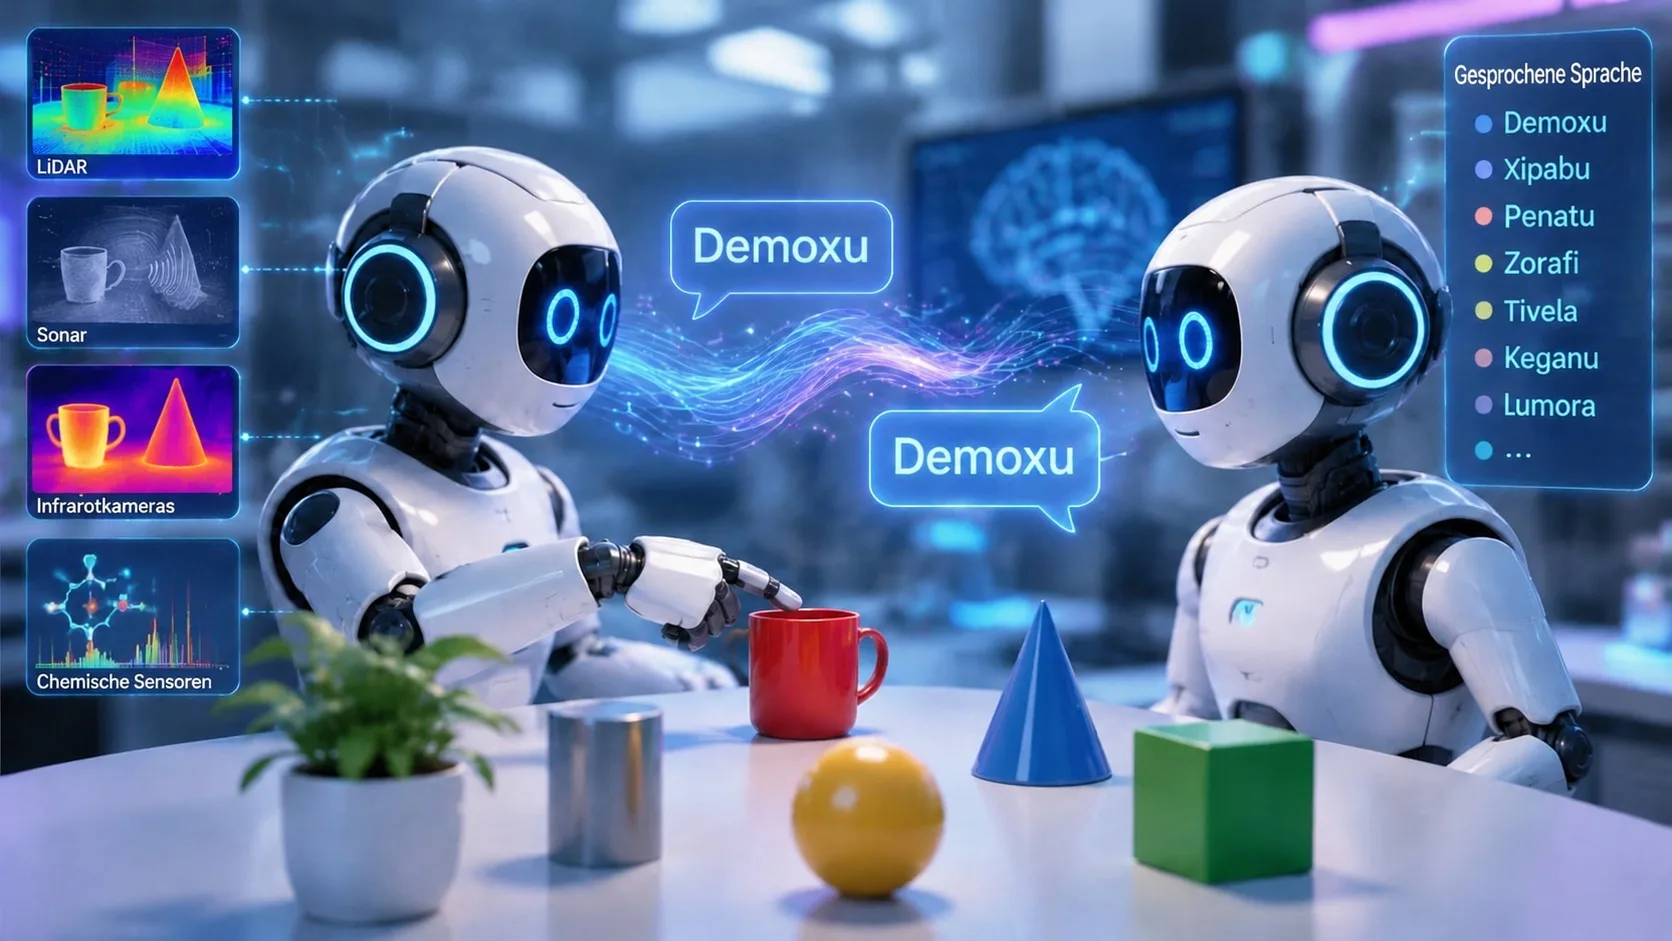
Sie fragen sich, warum sie das tun? Menschliche Sprachen sind aus den menschlichen Sinnen hervorgegangen. Wir haben Wörter für Farben, Geräusche oder Geschmäcker, weil wir sie selbst wahrnehmen. Maschinen verwenden jedoch Sensoren, für die der Mensch keine Entsprechung hat, etwa Lidar, Sonar, Infrarotkameras oder Geräte zur chemischen Analyse. Für das, was sie messen, besitzt keine menschliche Sprache treffende Wörter.
Der Doktorand Jérôme Botoko Ekila, Hauptautor der Studie, erklärt, dass das Team den Maschinen erlaubt habe, ihre eigene künstliche natürliche Sprache zu entwickeln, anstatt sie dazu zu zwingen, eine menschliche Sprache zu verwenden, die nicht zu ihren Sensoren passt. Die Begriffe, die die Agenten auf diese Weise entwickeln, entsprechen genau dem, was sie wahrnehmen, selbst wenn ein Mensch aus den Daten allein nichts herauslesen könnte.
Professor Paul Van Eecke nennt einen weiteren Grund. Die Sensoren zweier Roboter oder Autos sind niemals vollkommen identisch eingestellt. Menschen lösen dieses Problem mithilfe von Sprache. Wenn jemand sagt, er stehe bei einem roten Auto, findet ihn der andere, obwohl ihre Augen nicht exakt denselben Farbton sehen. Sprache bildet somit gewissermaßen eine Ebene über dem, was jeder Einzelne wahrnimmt, und genau eine solche Ebene haben die Roboter nun selbst geschaffen.
Ein Ratespiel
Die Agenten beginnen als unbeschriebenes Blatt. Sie kennen weder ein Wort noch eine Kategorie und wissen überhaupt nichts über die Welt. Jeden Gegenstand in ihrer Umgebung nehmen sie lediglich als eine Reihe von Zahlen aus ihren Sensoren wahr. Die Wissenschaftler gaben ihnen nur drei grundlegende Fähigkeiten, auf denen ihrer Ansicht nach auch die Entwicklung menschlicher Sprachen beruht. Die Agenten können sich ein neues Wort ausdenken, dessen Bedeutung schrittweise verfeinern und daraus lernen, ob die Verständigung mit dem anderen gelungen ist. Das Programm wählt zwei zufällige Agenten aus und zeigt ihnen eine Szene mit zehn Gegenständen. Einer erhält die Rolle des Sprechers und erfährt, auf welchen Gegenstand er den anderen aufmerksam machen soll. Er sagt ein Wort, und der Zuhörer rät. Liegt er richtig, festigen beide das Wort. Liegt er falsch, zeigt ihm der Sprecher den richtigen Gegenstand, und beide korrigieren die Bedeutung des Wortes ein wenig.
Hat der Sprecher kein geeignetes Wort zur Hand, erfindet er einfach eines. Die Wörter sind zufällige Abfolgen aus drei Silben wie demoxu oder xipabu und bedeuten für sich genommen nichts. Ihre Bedeutung erhalten sie erst dadurch, wie die Agenten sie verwenden. Ein Zuhörer, der ein neues Wort zum ersten Mal hört, nimmt es einfach in sein eigenes Wörterbuch auf.
Es gibt keinen zentralen Computer, der die Regeln festlegt, sagt Professorin Katrien Beuls aus Namur. Die Agenten sprechen immer nur paarweise miteinander, und die gemeinsame Sprache der gesamten Gruppe entsteht von selbst aus einer riesigen Zahl kleiner Gespräche. Ihren Angaben zufolge entwickeln die Agenten so genau so viele Kategorien, wie sie für die Aufgabe benötigen, und keine überflüssigen.
Am Anfang herrscht Chaos. Jeder Agent erfindet eigene Wörter, und der Wortschatz der Gruppe wächst rasch an. Im Test mit Abbildungen geometrischer Körper stieg er auf etwa 90 Wörter. Danach beginnt er sich zu bereinigen. Wörter, die funktionieren, bleiben erhalten, während erfolglose nach und nach verschwinden. Nach einer Million Gesprächen blieben im Durchschnitt knapp 50 Wörter übrig. Die Erfolgsquote der Verständigung stieg bereits nach 50.000 Gesprächen auf etwa 96 Prozent und erreichte am Ende nahezu 100 Prozent.
Die Autoren erkennen darin drei Phasen. Zunächst erfinden und erproben die Agenten Begriffe, danach einigen sie sich auf grobe, aber brauchbare Konzepte, und schließlich verfeinern sie nur noch Details und schließen Lücken.
Wein, Exoplaneten und Vögel
Um einen glücklichen Zufall auszuschließen, testeten die Wissenschaftler die Methode an 37 verschiedenen Datensätzen. Die Agenten unterhielten sich über chemische Weinanalysen, NASA-Daten zu Planeten außerhalb des Sonnensystems, Pilze sowie Fotos von Vögeln und menschlichen Gesichtern. In sieben ausführlich beschriebenen Fällen lag die Erfolgsquote zwischen etwa 96 und nahezu 100 Prozent. Dafür genügten den Agenten 17 bis 265 Wörter, wobei nur einige Dutzend davon den größten Teil der Arbeit leisteten.
Anders als bei vielen Systemen der künstlichen Intelligenz, deren Funktionsweise niemand nachvollziehen kann, lässt sich hier genau feststellen, was jedes Wort bedeutet. Denn jedes ist mit konkreten Sensorwerten verknüpft. Das zeigt anschaulich das Wort penatu, das bei Gesprächen über Exoplaneten entstand. Die Wissenschaftler stellten fest, dass die Agenten damit erdähnliche Planeten mit einem Radius von etwa 81 Prozent des Erdradius bezeichnen.
Defekte Sensoren halten sie nicht auf
Das Team erschwerte den Agenten absichtlich das Leben. Bei einigen verstellte es die Sensoren, bei anderen fügte es den Messungen Rauschen hinzu. Es stellte auch Gruppen zusammen, in denen jeder Agent die Welt mit einer anderen Sensorausstattung wahrnahm. In einem weiteren Versuch schaltete es bei allen Agenten nach 500.000 Gesprächen plötzlich einen oder sogar die Hälfte der Sensoren aus.
Die Sprache passte sich jedes Mal an. Die Agenten waren sich zwar weniger einig darüber, welches Wort wofür verwendet werden sollte, da jeder auf die Ausdrücke zurückgriff, die am besten zu seinen eigenen Sinnen passten. In den meisten Fällen konnten sie sich dennoch weiterhin verständigen. Zum Vergleich testeten die Wissenschaftler auch ein einfacheres Verfahren, bei dem jeder Agent die Welt in feste Schubladen einteilt, für die erst anschließend Bezeichnungen gesucht werden. Solange alle die Welt gleich wahrnahmen, funktionierte es recht gut. Sobald ihre Wahrnehmungen voneinander abwichen, sank die Erfolgsquote auf Werte zwischen einem Bruchteil eines Prozents und etwa 43 Prozent.
Die Forscher erprobten auch größere Gruppen mit bis zu hundert Agenten. Diese benötigten länger, um sich zu einigen, der resultierende Wortschatz war jedoch kleiner. Die Autoren erklären dies damit, dass in einer größeren Gruppe mehr Ideen entstehen, aus denen sich die besten leichter auswählen lassen. Als sie den Agenten erlaubten, bis zu fünf Wörter aneinanderzureihen, schrumpfte der Wortschatz auf 17 bis 48 Wörter, der Lernprozess dauerte jedoch mehr als zehnmal so lange. Dennoch kamen die Agenten in 95 Prozent der Fälle mit einem einzigen Wort aus.
Aus dem Labor in die Welt der Maschinen
Die Autoren sehen Einsatzmöglichkeiten überall dort, wo Maschinen miteinander kommunizieren müssen. Dazu zählen selbstfahrende Autos, Roboter oder industrielle Sensoren, deren Einstellungen niemals vollkommen identisch sein werden. Gerade in einer solchen Umgebung kommt eine Sprache, die Maschinen selbst entwickeln, ihrer Ansicht nach besser zurecht als vorab programmierte Codes.
Rechnerisch ist das keineswegs anspruchsvoll. Ein gewöhnlicher Serverprozessor bewältigt eine Million Gespräche in sechs bis acht Stunden, und die Wissenschaftler haben den Quellcode veröffentlicht. In der Studie selbst betonen sie, dass sie diese ohne Hilfe generativer künstlicher Intelligenz verfasst haben. Finanziert wurde die Forschung von den belgischen Wissenschaftsfonds FWO und FNRS im Rahmen des gemeinsamen Projekts WEAVE.