Liquid AI hat zwei Modelle mit offenen Gewichten veröffentlicht, die vorgegebene Optionen bewerten, statt Antworten zu schreiben. d1-3B verarbeitet Text und Bilder, das experimentelle d1-omni-600M Text entweder mit Bildern oder mit Audio. Bei Klassifikationsaufgaben liefern sie direkt strukturierte Wahrscheinlichkeiten, sodass Anwendungen keine generierte Textantwort nachträglich verarbeiten müssen.
Drei Möglichkeiten, Entscheidungsfragen zu stellen
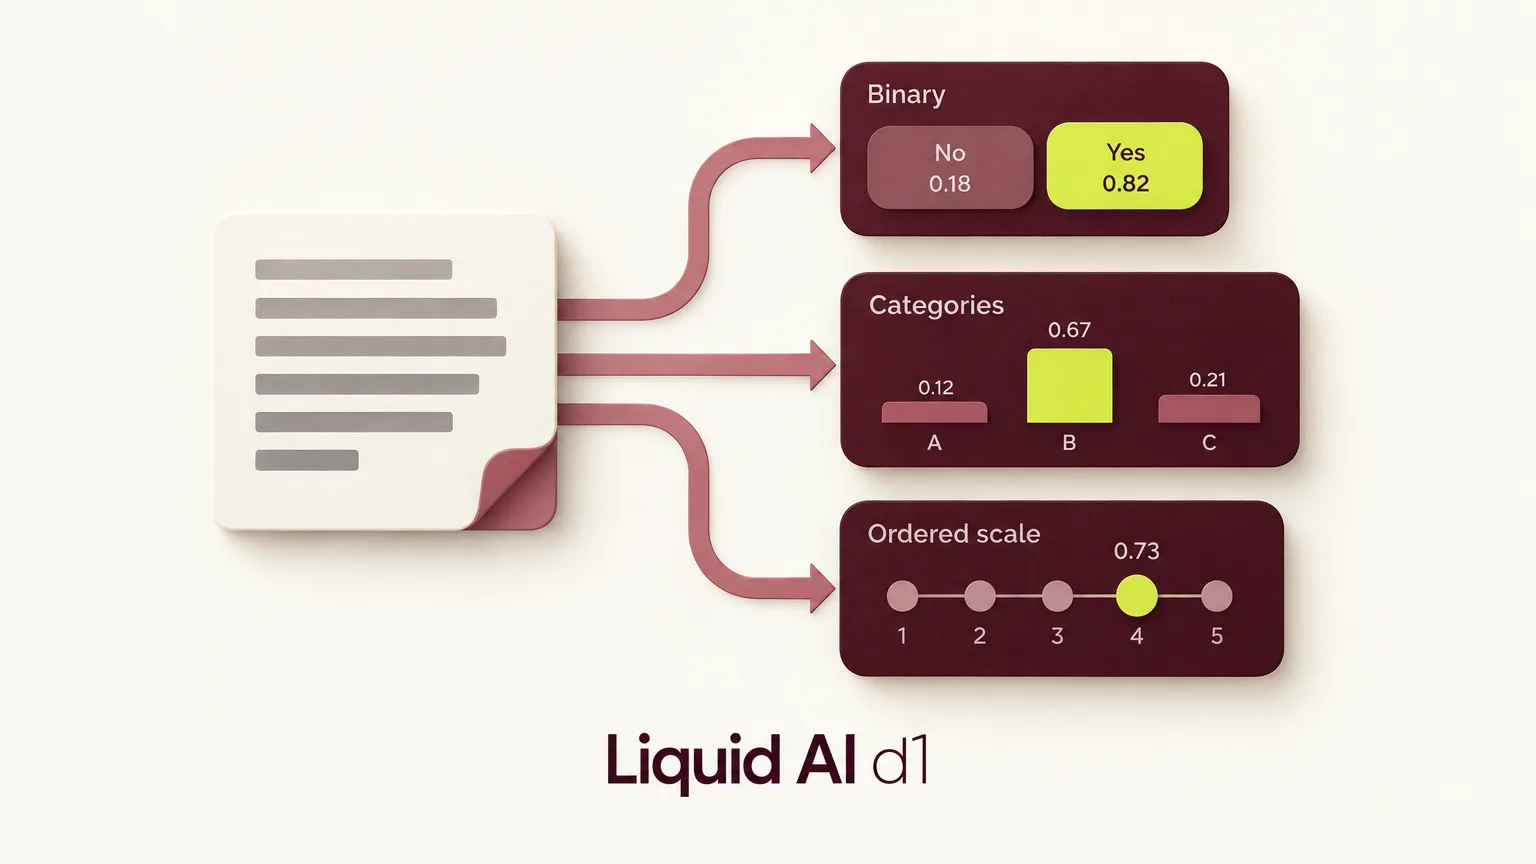
d1 bewertet die mit einer Anfrage übergebenen Optionen in einem einzigen Modelldurchlauf und gibt kalibrierte Wahrscheinlichkeiten zurück. Dabei erzeugt es keine Token. Die Schnittstelle bietet drei Fragetypen: für binäre Entscheidungen, die Auswahl einer Kategorie oder eine Bewertung auf einer geordneten Skala.
Noul ist für Ja-Nein-Fragen vorgesehen und liefert eine Wahrscheinlichkeit zwischen 0 und 1. Mögliche Anwendungen sind die Erkennung von Spam oder die Freigabe von Tool-Aufrufen. Choice verteilt dagegen Wahrscheinlichkeiten auf benannte Optionen: Eine Supportanfrage lässt sich damit etwa der Rechnungsabteilung, dem technischen Support oder der Kontoverwaltung zuordnen.
Score arbeitet mit einer geordneten Bewertungsskala und liefert eine mit Wahrscheinlichkeiten gewichtete Position darauf. Damit lassen sich beispielsweise Schweregrad, Dringlichkeit oder Antwortqualität einschätzen. Mehrere Fragen können dieselben Eingabedaten und eine gemeinsame Anfrage nutzen, etwa um gemeinsam das Anliegen eines Kunden zu erkennen, das zuständige Team auszuwählen und die Dringlichkeit zu bewerten.
Den Einsatzbereich begrenzen die vom Aufrufer festgelegten Optionen. d1 erzeugt keinen freien Text und ist nicht für mehrstufige Gespräche, Zusammenfassungen, Codegenerierung oder offene Fragen und Antworten vorgesehen.
Zwei Architekturen für unterschiedliche Eingaben
d1-3B basiert auf LFM2.5-VL-3B und verwendet eine Decoder-only-Architektur für die Verarbeitung von Text und Bildern. Das experimentelle d1-omni-600M hat 600 Millionen Parameter und baut auf LFM2.5-Encoder-350M auf. Hier setzt Liquid AI einen bidirektionalen Encoder mit Bild- und Audiokomponenten ein; unterstützt wird Text in Verbindung mit entweder Bildern oder Audio.
Latenz auf GeForce- und Jetson-Hardware
Liquid AI nennt für d1-3B bei einer einzelnen Frage eine Latenz von 8 ms auf der NVIDIA GeForce RTX 4090 und 9 ms auf dem AMD MI325X. Für den MI325X gibt das Unternehmen außerdem einen Durchsatz von 1 106 Eingangszuständen pro Sekunde bei gebündelter Verarbeitung an.
Auf dem NVIDIA Jetson AGX Thor dauert eine einzelne Frage laut Liquid AI 16 ms, während drei Fragen in einer gemeinsamen Anfrage 20 ms benötigen. Für den NVIDIA Jetson AGX Orin nennt das Unternehmen 26 ms und für den NVIDIA Jetson Orin Nano 50 ms, jeweils bei einer Frage.
Texttests und Vergleich mit Decider-Modellen
Im öffentlichen Teil von Decision Index v0.2.1, einem zusammengefassten Benchmark für Entscheidungsmodelle, erreicht d1-3B laut Liquid AI einen Wert von 48,57. Das Unternehmen bezeichnet es als führendes Modell unter denen mit weniger als 10 Milliarden Parametern. Zugleich beschreibt es die Leistung als vergleichbar mit Decider 35B-A3B, das nach seinen Angaben zwölfmal größer ist.
Einen konkreten Zahlenvergleich liefert eine Sammlung von sieben öffentlichen Textbenchmarks. Liquid AI gibt dafür einen Durchschnittswert von 82,9 für d1-3B gegenüber 81,1 für Decider 4B an. Die Tests umfassen Textverständnis und die Klassifikation von Absichten sowie die Erkennung toxischer Inhalte, die Beantwortung medizinischer Fragen und sprachübergreifendes Verständnis.
Für das experimentelle d1-omni-600M nennt Liquid AI einen Wert von 15,95 in Decision Index v0.2.1. Bei spezialisierten Textaufgaben veröffentlicht das Unternehmen 95,8 für die Erkennung toxischer Inhalte in Civil Comments und 79,5 für die Erkennung von Paraphrasen in PAWS-X.
Gehostete API liefert Auswahl und Konfidenzwert
Das gehostete Modell ist über den Endpunkt system_one zugänglich. Ein Aufruf enthält einen Eingangszustand, typisierte Fragen und gegebenenfalls Bilder; die Antwort umfasst die Wahrscheinlichkeitsverteilung, die ausgewählte Antwort und einen Konfidenzwert. Anwendungen können explizite Schwellenwerte festlegen, Fälle mit hoher Konfidenz automatisch bearbeiten und uneindeutige Eingaben an ein anderes Modell oder einen Menschen weitergeben.
Eine Anfrage kann bis zu acht Bilder und 10 000 Bildblöcke mit jeweils 32 × 32 Pixeln enthalten. Die gehostete API bietet die kostenpflichtige Variante d1 mit Bildunterstützung und die reine Textvariante d1:free; Liquid AI berechnet die Bildverarbeitung mit 1,5 Token pro Block.
Offene Gewichte, llama.cpp und Kamera-Demo
Beide Modelle sind auf Hugging Face unter Open-Weight-Lizenzen verfügbar. Die Veröffentlichung umfasst llama.cpp-Unterstützung für Hardware von Apple, AMD, Qualcomm und NVIDIA, einschließlich des Formats NVIDIA NVFP4. Jetson AI Lab hat Modellkarten für den Einsatz auf Endgeräten veröffentlicht.
Liquid AI stellt außerdem eine Live-Demo mit zehn kamerabasierten Beispielen bereit. Dazu gehören gestengesteuerte Spiele und Inhaltsmoderation, bei der das Modell pro Bild einen Durchlauf ausführt.