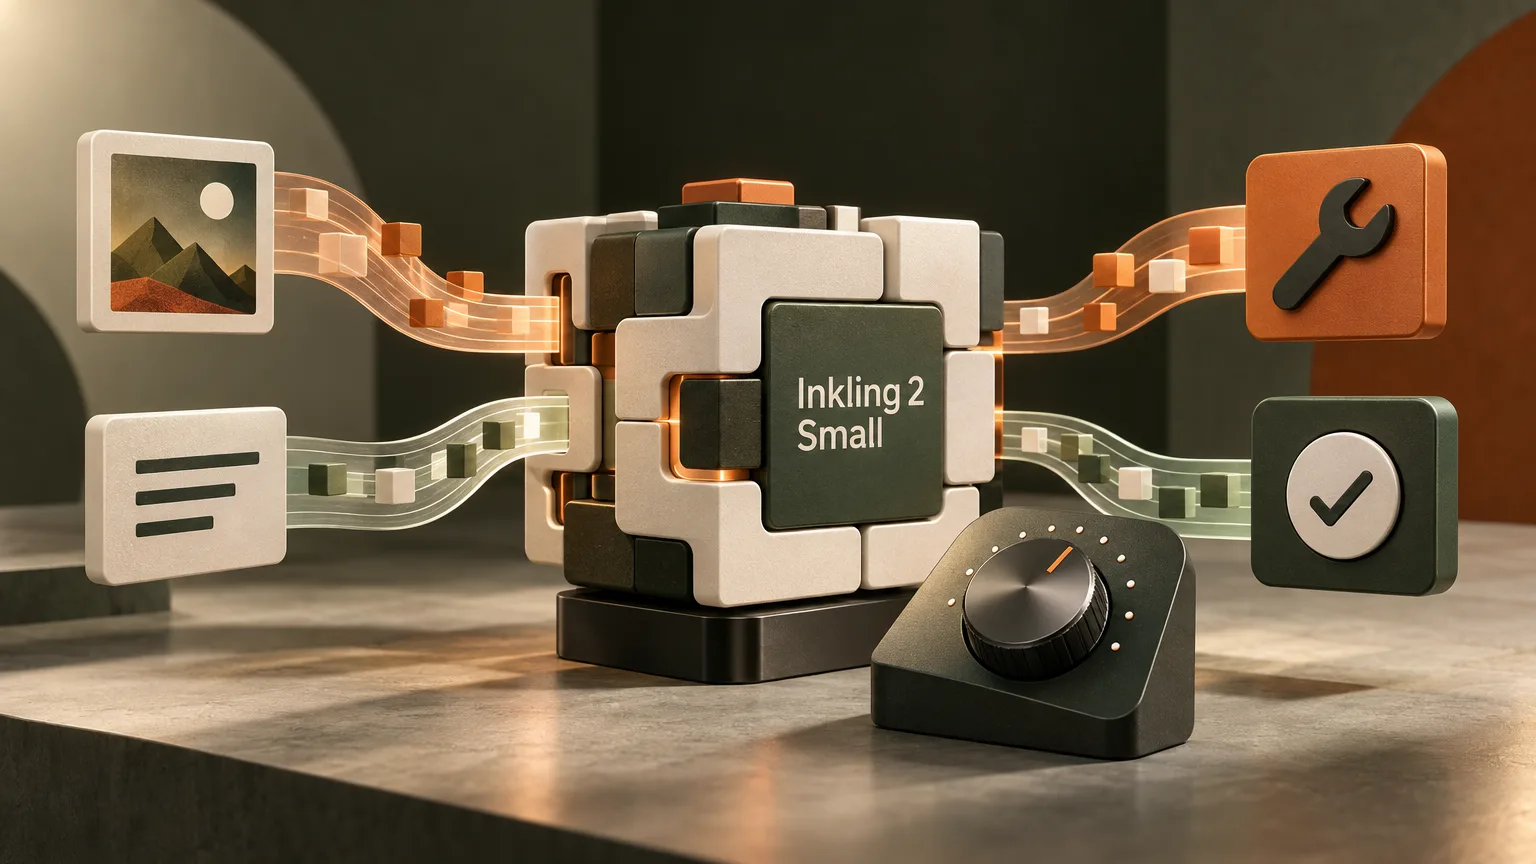
Thinking Machines Lab hat Inkling 2 Small veröffentlicht. Das Modell ist für die Nachtrainierung und die Entwicklung von KI-Agenten gedacht, die mehrstufige Aufgaben planen, Werkzeuge nutzen und Ergebnisse überprüfen. Es verarbeitet Text und Bilder und ist für Entwickler über Tinker verfügbar. Die Modellgewichte bleiben vorerst geschlossen.
Größeres Modell, Bildeingaben und variabler Rechenaufwand
Inkling 2 Small nutzt eine Mixture-of-Experts-Architektur: Für jedes Token wird ein Teil spezialisierter Parametergruppen ausgewählt. Insgesamt besitzt das Modell 594 Milliarden Parameter, von denen es 17 Milliarden pro Token aktiviert. Der Vorgänger Inkling Small hatte insgesamt 276 Milliarden und aktivierte 12 Milliarden Parameter.
Bei der Inferenz unterstützt das neue Modell einen variablen Rechenaufwand. Ein auf Perception Encoder basierender Bildencoder zerlegt Bilder in kleinere Teile und fügt deren Repräsentationen zwischen Text-Tokens ein. Anders als der Vorgänger verarbeitet das neue Modell jedoch keine Audioeingaben.
Ergebnisse bei visuellen Tests und Programmieraufgaben
Im Artificial Analysis Intelligence Index, der unter anderem Programmierung, logisches Denken und Wissensarbeit umfasst, erreichte Inkling 2 Small einen Wert von 31. In den veröffentlichten visuellen Tests von Thinking Machines lag es unter den verglichenen Modellen mit veröffentlichten oder geplanten offenen Gewichten beispielsweise bei PerceptionBench, ScreenSpot Pro und MMMU Pro vorn.
Laut Thinking Machines würde das Modell in dieser Kategorie auch bei DesignArena führen, sobald es die Voraussetzungen für eine Aufnahme erfüllt. In veröffentlichten Tests zum agentischen Programmieren lag es dagegen in mehreren Bewertungen hinter DeepSeek V4.1 Flash und bei SWE-bench Pro hinter Kimi K3. Auf FrontierCode v2.0 erreichte es 25,4 %, auf DeepSWE v1.1 72,1 % und auf SWE-bench Pro v2 Hard 86,3 %.
Nachtrainierung und Demonstration mit einem weiteren Modell
Die Nachtrainierung ist ein zentraler Teil des Einsatzkonzepts. Laut Thinking Machines erreichte Inkling 2 Small beim Zusammenfassen von Finanzdokumenten nach 75 Trainingsschritten die endgültige Leistung des Vorgängers Inkling Small und übertraf sie anschließend. Für das Experiment kamen Tinker Cookbook und das Reinforcement-Learning-Ziel Stable Reinforce zum Einsatz.
In einer weiteren Demonstration des Labors erhielt das Modell die Aufgabe, Zeitreihen vorherzusagen, und steuerte über Tinker das Training von Qwen3.5-4B. Es erstellte ein Auswertungsprogramm, wählte Daten und Trainingsverfahren aus und korrigierte einen Fehler in der Auswertung. Nach 4,5 Stunden und Ausgaben von 426 Dollar erreichte das trainierte Modell bei dieser Aufgabe mehr als den doppelten Wert.
Training für logisches Denken und Agentenaufgaben
Beim anfänglichen Vortraining wurden auf NVIDIA-GB300-NVL72-Systemen innerhalb von 68 Stunden 8,4 Billionen Tokens aus natürlicher Sprache, Code und Bildern verarbeitet. Drei weitere Phasen erweiterten den Kontext und konzentrierten sich auf höherwertige Daten für Agenten.
Anschließend nutzte das Labor einen gemeinsamen Reinforcement-Learning-Lauf für logisches Denken und Agentenverhalten. In neun Tagen entstanden auf 2.048 GPUs mehr als 17 Millionen Trainingsdurchläufe und drei Billionen Tokens. Das Training verwendete ein Kontextfenster von 256.000 Tokens und komprimierte längere Durchläufe.
Programmieraufgaben machten 38,5 % der Durchläufe und 65 % der in diesem Lauf erzeugten Tokens aus. Weitere Aufgaben umfassten Büroarbeit, Bildverarbeitung, die Entwicklung von Webanwendungen, Werkzeugnutzung und Sicherheit.
Nach internen Messungen des Labors sank der Wert für allgemeines unerwünschtes Verhalten von 66,8 beim ursprünglichen Inkling auf 14,9 beim neuen Modell; niedriger ist besser. Das Labor gibt zugleich an, dass geschlossene Modelle wie GPT-6.1 Sol bei diesen Messungen besser abschneiden.
Zugang über Tinker und geplante Freigabe der Gewichte
Entwickler können im Tinker Playground interaktive Anfragen stellen und Tinker zur Nachtrainierung und für Sampling-Aufträge nutzen. Die Gewichte sind noch nicht verfügbar, sodass sich das Modell weder lokal einsetzen noch sein Checkpoint unabhängig prüfen lässt. Thinking Machines plant, die Gewichte nach externen Sicherheitstests unter Apache 2.0 freizugeben und weitere Inferenzplattformen hinzuzufügen; einen festen Termin hat das Unternehmen nicht genannt.
Zu den Einschränkungen zählt das Unternehmen ausschweifende Antworten, eine schwächere Gesprächsorganisation und eine inkonsistente Werkzeugauswahl in Codebasen mit vielen verfügbaren Fähigkeiten. Es weist außerdem auf übertriebene Reaktionen bei Fragen zur psychischen Gesundheit hin.