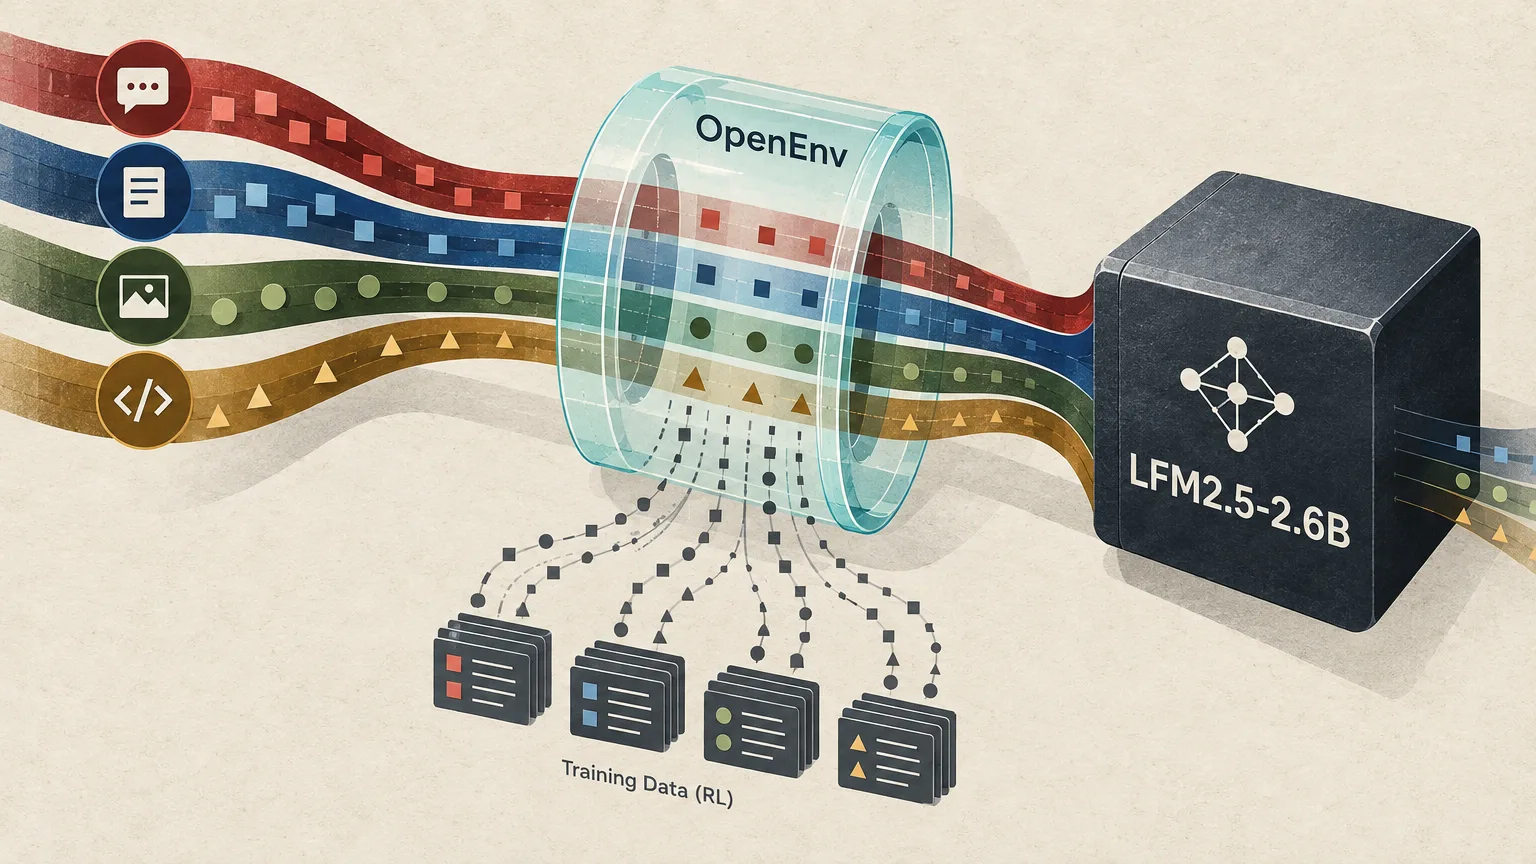
Hugging Face und Liquid AI haben eine offene Werkzeugsammlung für Reinforcement Learning direkt in Coding-Agenten veröffentlicht, darunter Claude Code, Codex und OpenCode. Entwickler müssen deren Quellcode nicht ändern: Sie leiten die Modellanfragen über einen Proxy, der das bisherige Kommunikationsformat des Agenten beibehält und die für das Training benötigten Daten aufzeichnet.
LFM2.5-2.6B verbessert sich im Experiment in vier Umgebungen
Im Hauptexperiment von Hugging Face und Liquid AI stieg die Gesamterfolgsquote von LFM2.5-2.6B, gemessen als pass@1, von 42,2 % auf 54,2 %. Diese Metrik erfasst den Anteil der Aufgaben, die im ersten Versuch gelöst werden. Beide Teams verzeichneten Verbesserungen in allen vier untersuchten Agentenumgebungen.
Auch die Zahl der Werkzeugaufrufe sank im Experiment. Die in mehreren Umgebungen trainierte Variante benötigte 31 % weniger Aufrufe als das Basismodell; verglichen wurden dabei nur Aufgaben, die beide Versionen erfolgreich lösten. Beim ausschließlich in OpenCode trainierten Modell betrug der Rückgang 11 %.
Das Training in nur einer Umgebung führte laut Hugging Face und Liquid AI zu einem anderen Ergebnisprofil: Das ausschließlich in OpenCode trainierte Modell erreichte bei der Auswertung in OpenCode eine Erfolgsquote von 58 %. Die in mehreren Umgebungen trainierte Variante schnitt in Claude Code und Codex besser ab. In Claude Code benötigte das nur in OpenCode trainierte Modell zudem mehr Werkzeugaufrufe und Token als das Basismodell.
Einbindung über den Modellendpunkt und Übersetzung der API-Formate
Der Proxy zur Datenerfassung sitzt zwischen dem Agenten und dem Inferenzserver vLLM. Entwickler tragen im Agenten die Proxy-Adresse als Modellendpunkt ein, ohne dessen Quellcode anzupassen. Der Agent sendet seine Anfragen und empfängt die Antworten weiterhin in seinem ursprünglichen Format.
Anhand des Anfragepfads, der Header und des Anfrageinhalts erkennt der Proxy eines von vier unterstützten API-Formaten. Aus NVIDIA Polar übernommene Konverter übertragen die Eingabe in das Format Chat Completions. Anschließend wird die generierte Antwort in das vom aufrufenden Agenten erwartete Format zurückübersetzt.
Der Proxy erfasst exakte Token und verzweigte Abläufe
Für Aktualisierungen mittels Policy-Gradient reicht es nicht, nur den ausgegebenen Text zu archivieren. Der Proxy speichert die exakten IDs der vom Modell generierten Token und ihre verarbeiteten logarithmischen Wahrscheinlichkeiten. Würde der Text erst gespeichert und später erneut tokenisiert, könnten für denselben sichtbaren Inhalt andere Token-IDs entstehen.
Die Aufzeichnung berücksichtigt auch Abläufe mit wiederholten Versuchen, Unteragenten oder einer Kürzung des Kontexts. Jeder Modellaufruf wird als Knoten gespeichert und anhand des längsten exakt übereinstimmenden Token-Präfixes mit früheren Aufrufen verknüpft. Jeder Pfad von der Wurzel bis zu einem Blatt bildet anschließend eine Trainingssequenz.
Beim Sampling nutzt der Proxy die vollständige Modellverteilung: top_p ist auf 1,0 gesetzt, die Begrenzung durch top_k ist deaktiviert. Laut Hugging Face und Liquid AI verschob die Einstellung von top_p auf 1,0 das gemessene Importance-Sampling-Verhältnis von 0,985–0,993 auf 0,9984–0,9999. Ein Wert nahe 1 zeigt an, dass die Wahrscheinlichkeiten bei der Generierung der Trainingsläufe und beim eigentlichen Training übereinstimmen.
Acht Versuche pro Aufgabe und ein Bonus für sparsamere Lösungen
Hugging Face und Liquid AI testeten LFM2.5-2.6B mit SmolDataEnvs. Die Sammlung umfasst 1 000 Datenanalyseaufgaben, die aus Kaggle-Notebooks abgeleitet wurden. Beide Trainingsvarianten nutzten Async GRPO in TRL und liefen über 1 000 Trainingsschritte auf zwei H100-GPUs.
Die Varianten unterschieden sich bei der Auswahl der Umgebung. In der ersten fanden alle Versuche in OpenCode statt. In der zweiten verwendete jede Gruppe von Versuchen eine von vier Umgebungen: OpenCode, Claude Code, Codex oder Mini-SWE-Agent.
Im Training umfasste jede GRPO-Gruppe acht Lösungsversuche für dieselbe Aufgabe. Eine richtige Antwort erhielt eine Belohnung von 1, eine falsche von 0. Erfolgreiche Lösungen konnten zusätzlich einen Bonus von bis zu 0,1 für weniger Werkzeugaufrufe erhalten; dieser lieferte auch dann ein weiteres Lernsignal, wenn alle acht Versuche einer Gruppe erfolgreich waren.
Separater Vergleich mit dem Training durch ein Lehrermodell
Neben Reinforcement Learning erprobten beide Teams auch überwachtes Fine-Tuning mit einem Lehrermodell. Sie ließen Qwen3.8-27B in allen vier Umgebungen laufen und wählten 3 189 erfolgreiche Lösungsverläufe aus. Mit diesen Daten trainierten sie LFM2.5-2.6B anschließend weiter.
In diesem separaten Vergleich erreichte die mit Reinforcement Learning in mehreren Umgebungen trainierte Variante laut Hugging Face und Liquid AI einen pass@1-Wert von 54,6 %. Die ausschließlich für OpenCode überwacht trainierte Variante kam auf 47,5 %, die in mehreren Umgebungen überwacht trainierte auf 43,1 %.
Bei der Variante mit überwachtem Training in mehreren Umgebungen verzeichneten die Teams zudem schlechtere Ergebnisse in Mini-SWE-Agent. Die Erfolgsquote sank dort von 62,1 % beim Basismodell auf 45,2 %, was die Verbesserungen in den anderen drei Umgebungen aufwog.
Werkzeuge, Daten und sieben Checkpoints sind öffentlich verfügbar
Die veröffentlichte Sammlung umfasst den Proxy OpenEnv zur Datenerfassung und die FineEnvs-Skripte zum Definieren von Umgebungen und Starten des Trainings. Verfügbar sind außerdem die Integration des Trainingswerkzeugs TRL und die Aufgabensammlung SmolDataEnvs. Zum Paket gehören auch Daten für überwachtes Lernen sowie alle sieben trainierten Checkpoints.