

Das chinesische Unternehmen DeepSeek hat sein neuestes Modell V4.1-Flash veröffentlicht und sofort kostenlos zum Download bereitgestellt. Es ist das kleinste Modell der neuen Generation, schneidet in Tests jedoch besser ab als das bisher leistungsstärkste Modell des Labors, das fast dreimal so viele Parameter besitzt. DeepSeek nimmt sein Flaggschiff daher schrittweise außer Betrieb und ersetzt es durch dieses kleinere Modell.
Was am neuen Modell anders ist
Die größte Veränderung fand im Inneren statt und macht sich für den Nutzer vor allem bei der Geschwindigkeit und den Kosten bemerkbar. Das Modell hat gelernt, die Arbeit in zwei Teile aufzuteilen, nämlich in das Lesen der Aufgabenstellung und das Verfassen der Antwort, wobei es beim Lesen nur einen kleinen Teil seiner Kapazität aktiviert. Während das gesamte Modell über 552 Milliarden Parameter verfügt, verwendet es für jedes Wort der Eingabe lediglich acht Milliarden und beim Schreiben sechzehn Milliarden Parameter. Das klingt nach einem technischen Detail, doch die Auswirkungen sind deutlich spürbar. Die meisten heutigen Werkzeuge, die selbstständig Code, Dokumente oder Webseiten durchsuchen, verarbeiten enorme Textmengen und verfassen selbst vergleichsweise wenig. Genau für diese Arbeitsweise wurde das neue DeepSeek entwickelt.
Die zweite große Veränderung betrifft den Speicher. Wenn das Modell einen langen Text liest, muss es sich fortlaufend merken, was es bereits gelesen hat, und dieser Arbeitsspeicher verursacht die höchsten Kosten und benötigt den meisten Platz. DeepSeek hat ihn gegenüber der vorherigen Generation auf etwa ein Viertel reduziert, und der Teil, der zuvor auf den Datenträger ausgelagert wurde, ist auf ein Achtel gesunken. Das Unternehmen konnte daher unmittelbar seine Preise senken.
Es erkennt Bilder und liest tausend Seiten
Die Version V4.1-Flash kann Aufgaben aus Text und Bild gleichzeitig verarbeiten. Der visuelle Teil wurde von Anfang an gemeinsam mit dem sprachlichen Teil trainiert, sodass das Modell Fotos, Diagramme, Formulare oder Screenshots als gewöhnliche Eingaben behandelt. Beim Lesen von Dokumenten mit Tabellen und Diagrammen erreicht es in Tests eine Erfolgsquote von fast fünfundneunzig Prozent. Sein Speicher fasst eine Million Token auf einmal, was ungefähr tausend Textseiten entspricht. Trainiert wurde es mit einem Datensatz von 45 Billionen Token – einer Menge, die ein Mensch nicht einmal in tausend Leben lesen könnte.
Hinzugekommen ist außerdem eine neue Funktion. Nutzer können auf einer Skala von eins bis hundert einstellen, wie intensiv das Modell über eine Aufgabe nachdenken soll. Eine niedrige Einstellung bedeutet eine schnelle und günstige Antwort, eine hohe Einstellung führt zu längeren Wartezeiten und größerer Genauigkeit. Damit entfällt die Wahl zwischen zwei unterschiedlichen Modellen.
Hervorragend bei Textaufgaben
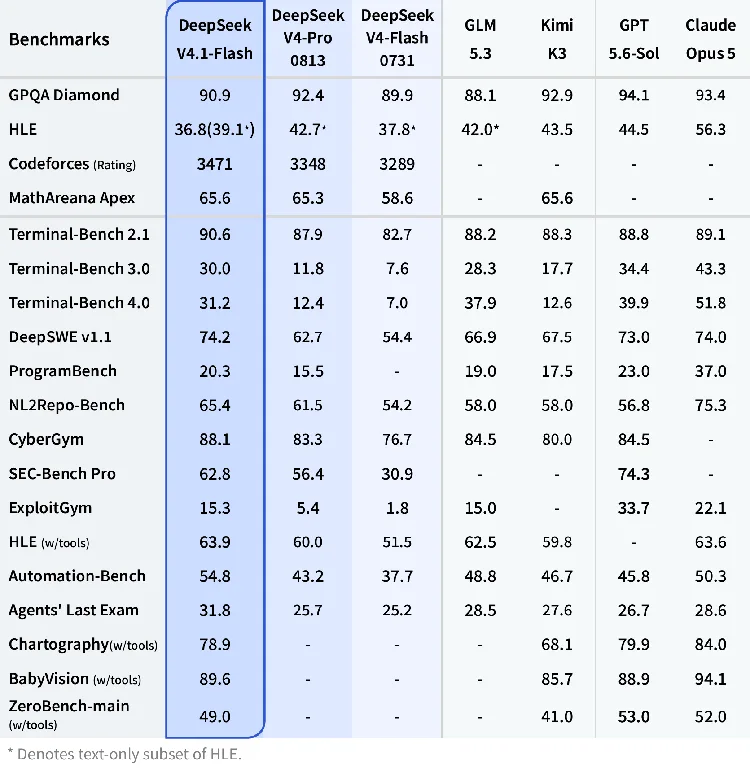
Am besten schneidet das Modell bei Aufgaben ab, die es selbstständig bearbeiten soll. Beim kompetitiven Programmieren erzielt es die höchste Bewertung unter allen verglichenen Modellen. In einem Test, bei dem es eigenständig Fehler in realen Programmen beheben musste, löste es etwa drei Viertel der Aufgaben und lag damit vor Opus 5.0 und GPT-5.6. Bei der Bedienung der Kommandozeile schnitt es ähnlich ab, und bei Sicherheitsaufgaben erreichte es achtundachtzig Prozent.
Andererseits ist es nicht in allen Bereichen führend. In den schwierigsten Tests für selbstständiges Arbeiten am Computer bewältigte es rund dreißig Prozent der Aufgaben, während Opus 5.0 über vierzig beziehungsweise fünfzig Prozent erreichte. Auch Wissensfragen, bei denen nicht das Nachdenken hilft, sondern der Umfang des im Modellspeicher abgelegten Wissens, liegen ihm nicht besonders. In einem Faktentest erzielte es zweiundvierzig Punkte gegenüber fünfundfünfzig Punkten seines größeren Schwestermodells. In der Praxis bedeutet dies, dass man bei der Überprüfung von Fakten weiterhin vorsichtig sein muss.
Die Tests zeigten zugleich, dass sehr viel von dem Programm abhängt, in dem das Modell läuft. Dasselbe Modell erreichte in einer Umgebung vierundsiebzig Prozent und in einer anderen fünfundsechzig Prozent. Der Unterschied von fast neun Prozentpunkten wurde somit allein durch die umgebende Software verursacht.
Niedrigere Preise und das Ende des älteren Modells
Die neuen Preise traten direkt am Veröffentlichungstag in Kraft. DeepSeek verwendet je nach Auslastung zwei unterschiedliche Tarife, und wer seine Aufgaben außerhalb der Spitzenzeiten einplant, zahlt nur die Hälfte. Das Unternehmen erklärt, die Einsparungen durch die effizientere Architektur des Modells direkt an die Kunden weiterzugeben.
Nutzer älterer Versionen müssen sich auf Änderungen einstellen. Sowohl die vorherige Flash-Version als auch ihre experimentelle Bildvariante wurden eingestellt, und ihre Anfragen werden vorerst automatisch an das neue Modell weitergeleitet. Ab dem Morgen des 14. September wird auch alles, was an das bislang leistungsstärkste Modell V4-Pro gesendet wird, zum kleineren Modell weitergeleitet – und zwar zu dessen Preisen. Dies gilt so lange, bis DeepSeek eine leistungsfähigere Version der neuen Generation veröffentlicht. Die Werkzeuge WorkBuddy mit CodeBuddy sowie OpenCode melden bereits vollständige Unterstützung.
Kostenlos zum Download
Das Modell ist auf der Plattform Hugging Face unter der MIT-Lizenz verfügbar, sodass es jeder kostenlos herunterladen, anpassen und kommerziell nutzen kann. Es lässt sich mit gängigen Werkzeugen für den Betrieb großer Modelle ausführen. Damit bleibt DeepSeek seiner Linie treu, leistungsstarke Modelle öffentlich bereitzustellen, anstatt sie hinter einer kostenpflichtigen Schnittstelle unter Verschluss zu halten.
Eine Komplikation gibt es allerdings. Zur Veröffentlichung fehlt eine fertige Vorlage für die Formatierung von Konversationen, sodass Entwickler die Kommunikation mit dem Modell selbst zusammenstellen müssen. DeepSeek stellt dafür Beispielcode in Python und eine Reihe von Bibliotheken für den Produktivbetrieb bereit, überlässt die eigentliche Inbetriebnahme und die Anbindung an andere Werkzeuge jedoch den Nutzern. Ein Heimcomputer reicht dafür ohnehin nicht aus, da das Modell Servertechnik benötigt. Unternehmen, die eine Bereitstellung mit zweitausend Grafikkarten planen, bietet DeepSeek direkte Verhandlungen über die Konditionen an.


