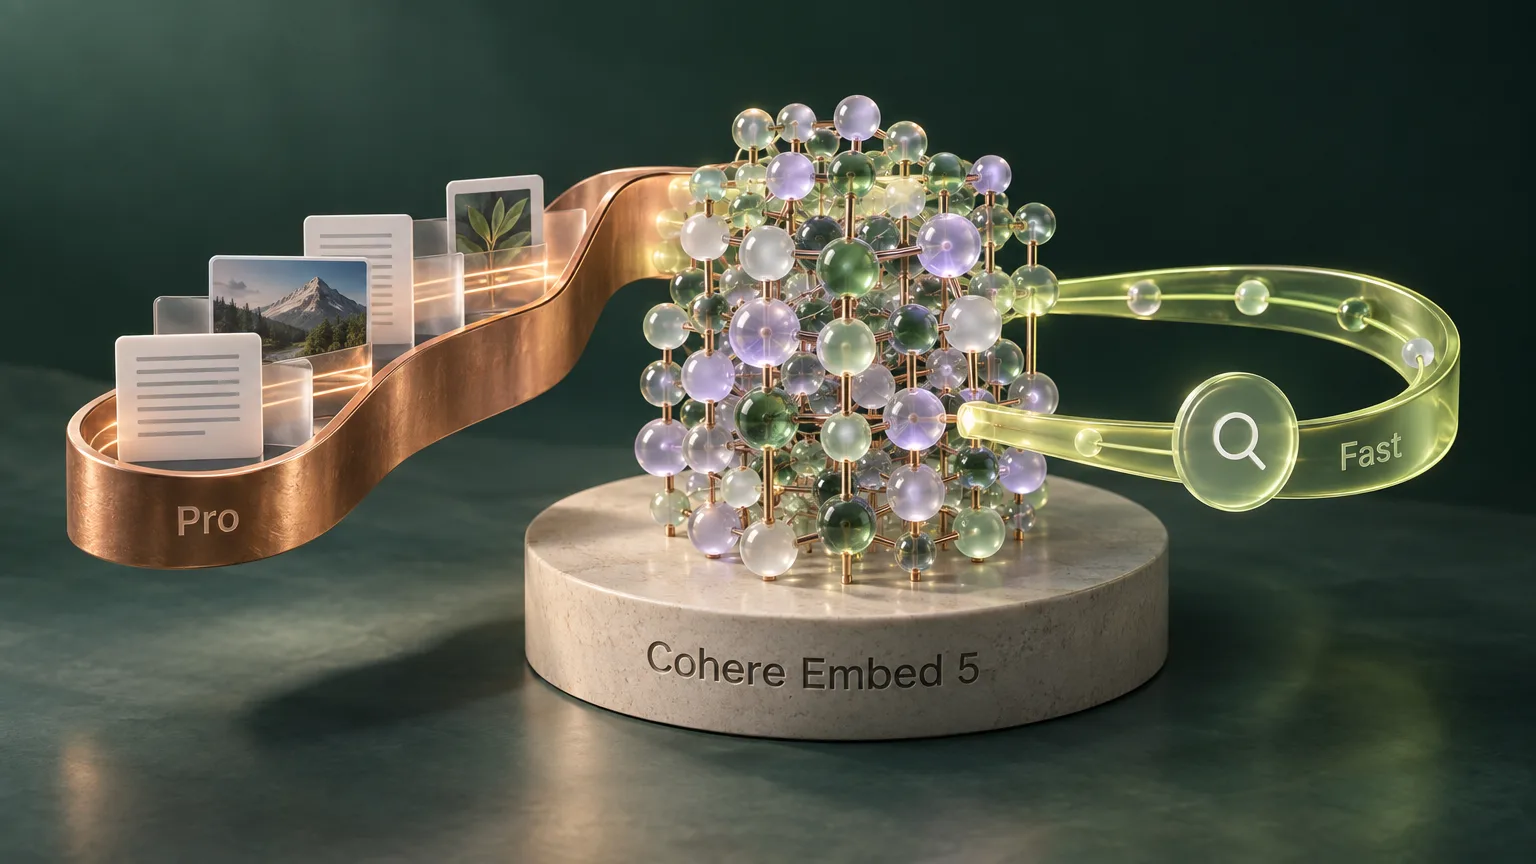
Cohere hat Embed 5 veröffentlicht, eine Modellfamilie, die Inhalte in Vektoren umwandelt und bei der sich Dokumente und Suchanfragen mit unterschiedlichen Varianten verarbeiten lassen. Pro ist auf hohe Qualität bei der Indexierung ausgelegt, Fast auf niedrige Latenz und hohen Durchsatz bei interaktiver Suche und in Agentenabläufen. Der gemeinsame Vektorraum erlaubt es, beide Varianten ohne Neuaufbau des Index zu kombinieren.
Ein gemeinsamer Index, unterschiedliche Modelle für Dokumente und Anfragen
Entwickler können Dokumente mit Pro in Vektoren umwandeln und spätere Suchanfragen mit Fast über denselben Index verarbeiten. Die Kompatibilität setzt jedoch übereinstimmende Einstellungen auf beiden Seiten voraus: Vektordimensionen, Ausgaberepräsentation und Konfiguration des Ähnlichkeitsvergleichs müssen identisch sein.
Cohere hat sämtliche Kombinationen von Dokument- und Anfragemodellen auf 40 Entwicklungsdatensätzen getestet. Kombinationen unterschiedlicher Modelle erzielten nach Angaben des Unternehmens im Durchschnitt eine um 1,6 % beziehungsweise 2,7 % geringere Leistung als die jeweiligen Referenzkonfigurationen, bei denen dasselbe Modell Dokumente und Anfragen verarbeitete.
Bei Messungen über typische Kontextlängen hinweg erreichte Fast laut Cohere im Durchschnitt den 2,4-fachen Durchsatz von Pro. Das Unternehmen nennt etwa 377 Dokumente pro Sekunde für Fast und 160 für Pro; gemessen wurde der Durchsatz bei der Dokumentverarbeitung, nicht die Gesamtlatenz einer Nutzeranfrage.
Text, Bilder und ein Kontextfenster von 128.000 Token
Embed 5 verarbeitet Text- und Bildeingaben sowie Kombinationen aus beiden, etwa PDF-Seiten mit Text und Bildern. Die Modellfamilie unterstützt mehr als 100 Sprachen und hat ein Kontextfenster von 128.000 Token.
Für die Ausgabe lassen sich 256, 512, 768, 1.024, 1.536 oder 2.048 Dimensionen wählen. Die Modelle bieten die Repräsentationen float, int8 und binary. Beide Varianten unterstützen Matryoshka embeddings, mit denen Anwendungen gekürzte Vektoren speichern können, wenn geringerer Speicherbedarf wichtiger ist als maximale Suchqualität.
Vektorgröße an den Speicherbedarf anpassen
Dimensionen und Repräsentation haben großen Einfluss auf die Größe eines einzelnen Vektors. Ein float32-Vektor mit 2.048 Dimensionen belegt 8 KB, ein int8-Vektor mit 1.024 Dimensionen dagegen 1 KB. Ein binärer Vektor mit 256 Dimensionen benötigt 32 Byte; diese Angaben schließen Indexmetadaten, Graphstrukturen, Replikate und den zusätzlichen Speicherbedarf der Datenbank nicht ein.
Cohere empfiehlt int8-Vektoren mit 1.024 Dimensionen als Kompromiss zwischen Speicherbedarf und Suchqualität. Für beide Modelle berichtet das Unternehmen dabei eine Leistung nahe der float-Repräsentation. Der Datenbankindex muss die gewählte Repräsentation sowohl beim Speichern als auch beim Vergleichen der Vektoren unterstützen.
Ergebnisse für Unternehmensdokumente und Finanzaufgaben
Für ViDoRe V3, einen Benchmark mit Schwerpunkt auf visuell komplexen Unternehmensdokumenten, nennt Cohere einen durchschnittlichen Wert von 85,8 für Embed 5 Pro und 84,7 für Fast. Im selben Vergleich des Unternehmens erreicht Voyage 4 Large 83,7, Gemini Embedding 2 kommt auf 83,2 und OpenAI text-embedding-3-large auf 75,5.
In den Finanztests von Cohere erreichte Pro 80,1 auf FinanceBench, 90,0 auf FinQA und 85,0 auf ViDoRe V3 Finance. Fast belegte dem Unternehmen zufolge in allen drei Tests den zweiten Platz. Auf FinanceBench gibt Cohere für Pro einen Vorsprung von 21,4 Punkten gegenüber OpenAI text-embedding-3-large an.
Der Vergleich mit dem Vorgänger Embed 4 umfasst auch mehrsprachige Ergebnisse. Die größte Verbesserung meldet Cohere für Persisch mit 13 Punkten; für Telugu und Hindi beträgt der berichtete Zuwachs jeweils 12 Punkte.
Neue Metrik bewertet die Relevanz gefundener Dokumente
Cohere hat Embed 5 mithilfe von RCP-nDCG@10 optimiert, einer Metrik zur Bewertung von Suchergebnissen, die für unvollständige Relevanzannotationen entwickelt wurde. Ein kalibrierter KI-Bewerter beurteilt dabei jedes gefundene Dokument anhand eines einheitlichen Bewertungsrasters.
In einer Cohere-Studie mit 46 menschlichen Annotatoren erreichten die bisherigen Benchmark-Annotationen einen AUC-Wert von 0,65 bei der Vorhersage menschlicher Relevanzurteile. Ein kalibrierter Bewerter auf Basis eines großen Sprachmodells kam auf 0,91. Die menschlichen Bewerter hielten zudem 28 % der Dokumente für nützlich, die der Benchmark als irrelevant eingestuft hatte.
Bei paarweisen Systemvergleichen wählte RCP-nDCG@10 laut der Forschung von Cohere in 77 % der Fälle das von Menschen bevorzugte System aus, gegenüber 52 % bei herkömmlicher nDCG. Die Berücksichtigung relevanter Dokumente, die in der Referenzliste fehlten, führte in dieser Untersuchung zu einer Verbesserung um 19 Punkte.
Zugang über API und Bereitstellungsplattformen
Embed 5 ist über die Cohere Embed API, Microsoft Foundry und Amazon SageMaker verfügbar. Für Bereitstellungen, die einem einzelnen Kunden vorbehalten sind, steht Model Vault zur Verfügung.
Der API-Listenpreis beträgt 0,12 USD pro Million Token für Pro und 0,08 USD für Fast, während für gehostete und einem einzelnen Kunden vorbehaltene Bereitstellungen plattformspezifische Konditionen gelten können.