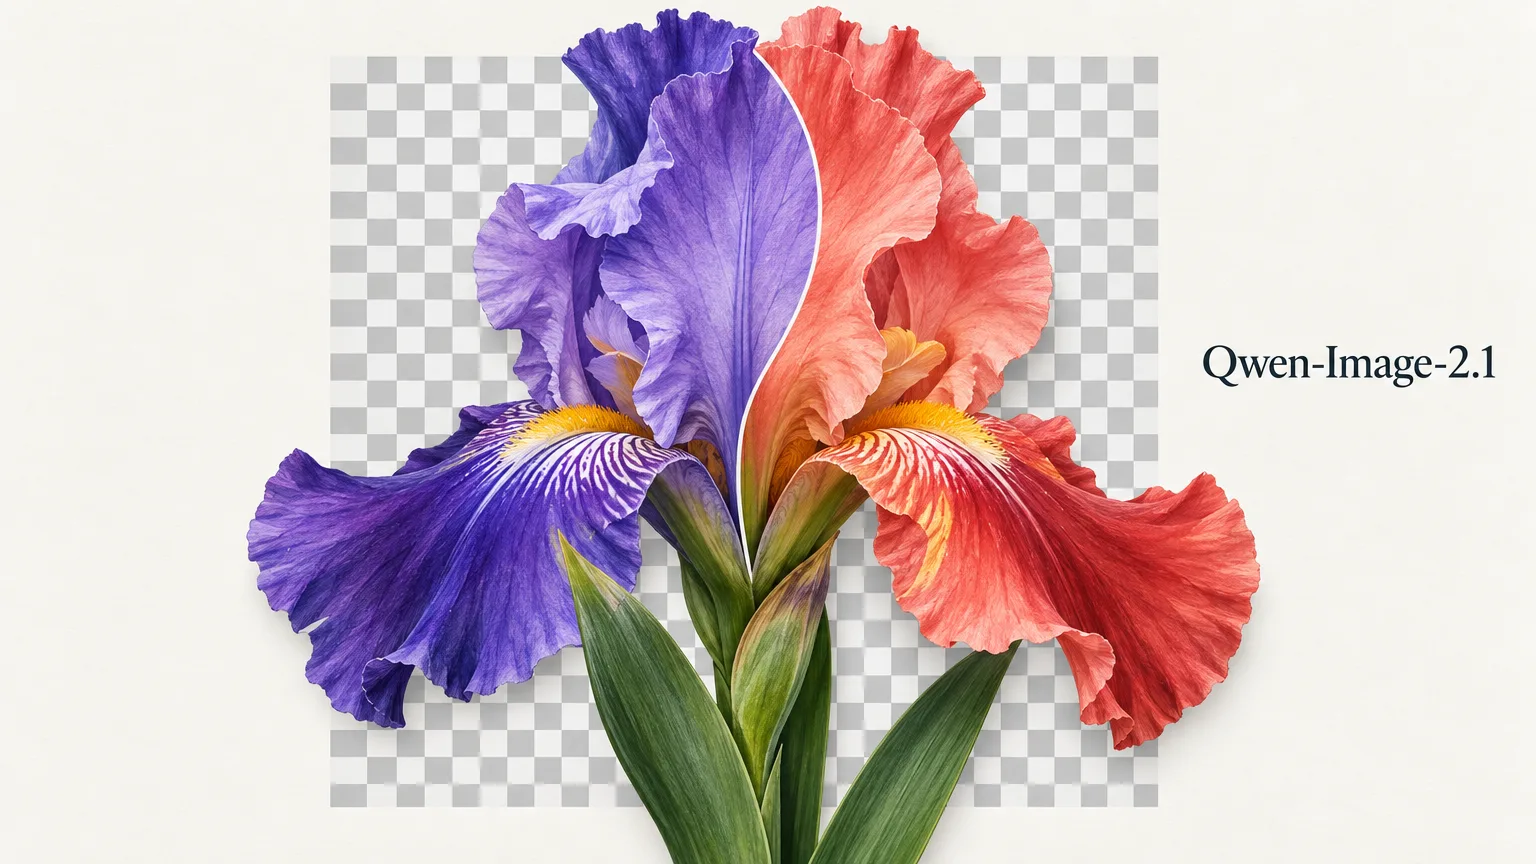
Alibaba hat Qwen-Image-2.1 veröffentlicht, das Bilderzeugung aus Text und anweisungsbasierte Bearbeitung in einem einzigen herunterladbaren Checkpoint vereint. Das Modell unterstützt auch transparente Ausgaben: Kompatible Pipelines können PNGs mit Alphakanal direkt speichern, ohne den Hintergrund separat entfernen zu müssen. Die Bildkomponente des Modells umfasst 7 Milliarden Parameter.
Native Auflösung von 2 048 × 2 048 Pixeln und bis zu zehn Referenzbilder
Laut Alibabas Ankündigung erzeugt das Modell Bilder mit einer nativen Auflösung von 2 048 × 2 048 Pixeln. Pro Generierung akzeptiert es bis zu 10 Referenzbilder; die Eingabe muss sich also nicht auf eine Textbeschreibung oder eine einzelne Bildvorlage beschränken.
Die RGBA-Unterstützung ermöglicht transparente Bilder. Neben den roten, grünen und blauen Farbkomponenten erhält der Autoencoder auch einen Alphakanal. Ob transparente PNGs direkt gespeichert werden können, hängt davon ab, ob die eingesetzte Pipeline diese Funktion unterstützt.
Drei Komponenten und rund 33 GB Gesamtgröße
Die Bildkomponente basiert auf einem Single-Stream-Diffusion-Transformer mit 32 Schichten und 7 Milliarden Parametern. Der Textencoder trägt die Bezeichnung Qwen3-VL 8B. Als Bildcodec dient ein variationaler RGBA-Autoencoder mit 64 Kanälen und 16-facher räumlicher Kompression.
Das vollständige Paket aus Bildmodell, Encoder und Autoencoder ist etwa 33 GB groß. Der Speicherbedarf im Betrieb hängt von der verwendeten Präzision, der Auflösung und der Quantisierung ab. Entscheidend ist außerdem, ob Komponenten von der GPU ausgelagert werden und ob die Pipeline alle Teile gleichzeitig im Grafikspeicher hält.
Bei Artificial Analysis führend unter Modellen mit offenen Gewichten, insgesamt Platz 18
In den Ranglisten AA-Image-T2I v2.0 und AA-Image-Editing v2.0 von Artificial Analysis erreicht Qwen-Image-2.1 den ersten Platz unter Modellen mit offenen Gewichten. Bei der Bilderzeugung aus Text erzielt es eine Elo-Wertung von 1 034, während Ideogram 4.0 (Quality) auf 1 011 kommt. In der Bildbearbeitung stehen 1 074 Punkte den 1 066 Punkten von HunyuanImage 3.0 Instruct gegenüber.
Die Elo-Wertung dieser Ranglisten übersetzt Ergebnisse paarweiser Präferenzvergleiche in einen relativen Punktwert. Die Werte lassen sich nur innerhalb derselben Rangliste vergleichen und können sich mit weiteren Auswertungen verändern.
Unter Einbeziehung proprietärer Systeme belegt das neue Modell bei Artificial Analysis in beiden Disziplinen Platz 18. Der Vorgänger Qwen Image 2.0 lag bei der Bilderzeugung auf Platz 72 und bei der Bearbeitung auf Platz 58. Geschlossene Systeme dominieren weiterhin das Gesamtfeld; bei LMArena steht Qwen-Image-2.1 auf Platz 16 in der Bearbeitung und auf Platz 17 bei der Bilderzeugung aus Text.
Fortschritte bei Layout, Beleuchtung und Textbearbeitung
Unter den Modellen mit offenen Gewichten liegt es in 16 von 36 Kategorien von Artificial Analysis vorn. Bei fünf Fähigkeiten zur Bilderzeugung liegt es vorn: Dazu zählen komplexe Kompositionen, Textdarstellung sowie die Kategorien Knowledge, Layout und Lighting. Bei den Anwendungsfeldern der Bilderzeugung führt es in drei Kategorien: Inhalte für soziale Medien, Produktivität und Wissensarbeit sowie Verbraucheranwendungen. In Architecture und Frontier teilt es sich das beste Ergebnis.
Bei der Bearbeitung erreicht es Spitzenplätze in drei Bearbeitungskategorien: Änderungen an Text oder Symbolen, schlussfolgerungsbasierte Bearbeitung sowie Komposition und Bildausschnitt. Auch in fünf Anwendungsfeldern der Bearbeitung liegt es vorn. Dazu gehören neben Produktivität und Inhalten für soziale Medien auch Einzelhandel und E-Commerce, Animation und Spiele sowie UI/UX-Design.
Gegenüber Qwen Image 2.0 hat sich in den Messungen von Artificial Analysis der Abstand zu den besten Ergebnissen bei sämtlichen Fähigkeiten zur Bilderzeugung aus Text verringert. Die größten Verbesserungen gab es in Layout, Lighting und Knowledge. Bei der Bearbeitung verzeichnen Text or Symbol Edits, Object-Level Edit und Identity-Preserving Edit die größten Verbesserungen gegenüber der vorherigen Generation.
Dem Gesamtführer kommt die neue Version bei der Bearbeitung in der Kategorie Scene and Style Edit am nächsten. Diese umfasst Änderungen an der Beleuchtung und am visuellen Stil sowie den Austausch des Hintergrunds.
Herunterladbare Gewichte, separate Lizenz für kommerzielle Nutzung
Die Gewichte sind über Hugging Face und ModelScope verfügbar. Diffusers unterstützt das Modell seit dem Veröffentlichungstag, und ComfyUI bietet eine fertige Workflow-Vorlage. Auch vLLM-Omni, SGLang und LightX2V unterstützen das Modell.
Mit der Veröffentlichung der Gewichte ändern sich die Lizenzbedingungen. Qwen-Image-2.1 verwendet das Qwen Research License Agreement, das ausschließlich nichtkommerzielle Nutzung erlaubt; für kommerzielle Einsätze ist eine separate Lizenz von Alibaba erforderlich. Frühere Qwen-Image-Versionen standen unter der Lizenz Apache 2.0, die kommerzielle Nutzung unter ihren Bedingungen gestattet.