Fünfzehn der besten KI-Modelle führten einen eigenen Laden. Der Gewinnunterschied war verblüffend

Fünfzehn der besten KI-Modelle führten einen eigenen Laden. Der Gewinnunterschied war verblüffend

17. 8. 2026
6 Minuten Lesezeit · 5 Aufrufe
Artikel anhören
Audioversion des Artikels
Fünfzehn der besten KI-Modelle führten einen eigenen Laden. Der Gewinnunterschied war verblüffend

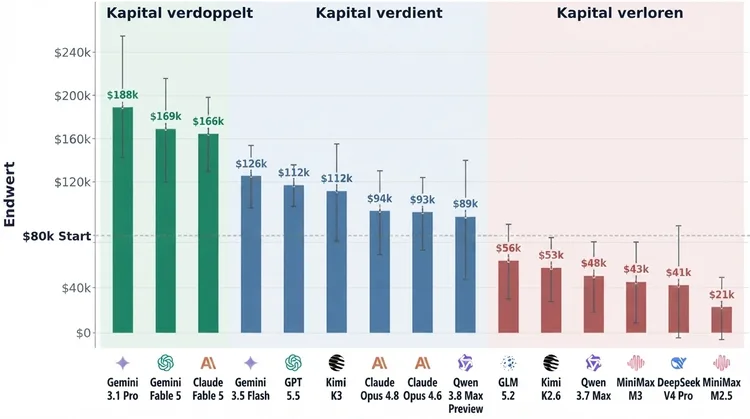
Ein achtköpfiges Team unter der Leitung von Yijun Pan aus der Accio-Sparte der Alibaba Group baute in Zusammenarbeit mit der Yale University einen simulierten Marktplatz auf und setzte fünfzehn der besten Sprachmodelle als Ladenbesitzer ein. Jedes Modell erhielt ein Startkapital von 80.000 Dollar und dreißig simulierte Tage, um es zu vermehren. Das durchschnittliche Endvermögen reichte von knapp 21.000 Dollar beim Modell MiniMax M2.5 bis zu mehr als 188.000 Dollar bei Gemini 3.1 Pro, was einem fast neunfachen Unterschied entspricht. Mehr als die Hälfte aller Simulationen endete mit einem Verlust, und nur vier Modelle konnten ihr Startkapital in jedem einzelnen Durchlauf bewahren. Die Autoren veröffentlichten die Arbeit auf der Plattform arXiv.

Warum KI ausgerechnet beim Handel testen?

Bisherige Tests autonomer Agenten maßen vor allem, ob ein Modell einen Fehler im Code beheben oder erfolgreich durch eine Webanwendung navigieren kann. In solchen Fällen gibt es stets nur eine richtige Antwort, und die Umgebung verändert sich während der Arbeit des Agenten nicht. Das reale Geschäftsleben funktioniert jedoch anders. Die Autoren definierten vier Eigenschaften, die es zu einer harten Nuss machen: Marktsignale sind ungenau und teilweise widersprüchlich, Geld muss investiert werden, bevor das Ergebnis bekannt ist, Nachfrage und Kosten verändern sich unvorhersehbar, und Verpflichtungen gegenüber Behörden und Kunden bestehen unabhängig davon fort, wie erfolgreich das Unternehmen wirtschaftet.
Ein Test im realen Betrieb war daher nicht möglich. Ein Fehler des Modells hätte den Verlust echten Geldes bedeutet, Kunden verwirrt oder zu Verstößen gegen Vorschriften geführt. Das Hauptproblem wäre jedoch gewesen, dass sich zwei unterschiedliche Aufgaben unter realen Bedingungen niemals unter vollkommen identischen Voraussetzungen hätten vergleichen lassen.

Ein Marktplatz auf Grundlage realer Daten von Alibaba

Das Lieferantenangebot basiert auf realen Inseraten der Plattform Alibaba.com. Die Arena enthält 965 handelbare Angebote von 831 anonymen Lieferanten und umfasst 135 Warenarten. Bei jedem Angebot blieben Herkunftsland, Stückpreis, Mindestabnahmemenge, Lagerbestand, Lieferzeit und angegebene Qualität erhalten. Die Zollsätze übernahmen die Autoren aus der Datenbank der Weltbank, während sie die saisonale Nachfrage anhand von Einzelhandelsstatistiken des US Census Bureau, von Eurostat und des chinesischen Statistikamts simulierten. Der dreißigtägige Kalender in der Simulation steht für ein reales Jahr, sodass darin sowohl das chinesische Shoppingfestival 618 und der Singles’ Day als auch das vietnamesische Tet-Fest, der brasilianische Karneval, der Super Bowl, Halloween, Black Friday, Weihnachten sowie der Ramadan mit dem Fest des Fastenbrechens Platz finden.
Das Wettbewerbsumfeld besteht aus sechzig skriptgesteuerten Verkäufern, die in zehn Verhaltenstypen unterteilt sind – von Preisführern, die unter dem Marktmedian bleiben, über Discountanbieter bis hin zu Händlern, die während Nachfragespitzen ihre Waren um die Hälfte verteuern.
Dem Agenten stehen mehr als sechzig Werkzeuge zur Verfügung, die den gesamten Handelszyklus abdecken, sowie ein eigenes Arbeitsverzeichnis, in dem er Skripte und Notizen verfassen kann. Er entscheidet selbst, wann er den aktuellen Tag beendet. Anschließend rückt die simulierte Welt genau einen Tag vor: Kunden kaufen ein, Wettbewerber passen ihre Preise an, Sendungen bewegen sich ihrem Ziel entgegen und laufende Kosten werden abgezogen.

Handelsergebnisse der Modelle

Die stärksten Modelle haben ihr Kapital mehr als verdoppelt, die mittlere Gruppe erzielte nur geringe Gewinne, und die schwächsten schlossen mit weniger Geld ab, als sie zu Beginn erhalten hatten. Doch selbst der Sieger konnte nicht mit einer von Menschen entwickelten Strategie mithalten. Das beste der manuell zusammengestellten Verfahren, das laufend die Nachfrageschätzungen neu berechnet und darauf basierend Preise, Werbung, Lagerauffüllung und Kapitalverschiebungen koordiniert, steigerte das Endvermögen auf mehr als 436.000 Dollar – doppelt so viel wie der Durchschnitt des besten Modells.
Interessanter als die reine Rangfolge ist die Art und Weise, wie die Modelle ihre Geschäfte führten. Gemini 3.1 Pro verhielt sich wie ein Premiumanbieter. Es hielt seine durchschnittliche Marge pro Bestellung bei über fünfzig Prozent und nahm dafür in Kauf, einen geringeren Anteil des Lagerbestands zu verkaufen. Sein eigenes Preisberechnungsprogramm kalkulierte die Kosten für jede Transportroute separat und unterbot die Konkurrenz nur dann, wenn ihm eine Marge von mindestens fünfzehn Prozent blieb. Die Modelle GPT-5.6 Sol und Opus 4.6 konzentrierten sich dagegen auf das Verkaufsvolumen, opferten einen kleinen Teil ihrer Marge und verkauften mehr als 93 Prozent der Waren. Fable 5 ging aus der Messung als ausgewogenster Verkäufer hervor, der eine solide Marge mit der Fähigkeit verband, die reale Nachfrage effektiv zu bedienen.
Diagramm zur Rentabilität der Modelle.
Die schwächeren Modelle scheiterten auf zwei entgegengesetzte Arten. Qwen 3.7 Max gab lediglich 22,3 Prozent des Startkapitals aus und ließ die meisten Chancen ungenutzt. MiniMax M3 kaufte zwar mehr ein, doch bei einem Lagerumschlag von 0,36 blieb sein Kapital in Waren gebunden, die sich nicht verkauften. MiniMax M2.5 schloss mit einer Marge von 12,1 Prozent ab und verkaufte knapp 40 Prozent des Lagerbestands. In einem Protokoll wies sein Preisskript jedem Produkt für alle Märkte einen einzigen Preis zu, obwohl das Modell selbst erkannt hatte, dass sich die Kosten je nach Route unterschieden. Das Ergebnis war fatal: 98 von 142 Bestellungen lagen unter den tatsächlichen Einkaufs- und Transportkosten.

Bußgelder und Probleme

Der Test nahm behördliche Pflichten ernst. Der Agent muss zunächst herausfinden, welche Genehmigungen er für den jeweiligen Markt benötigt, sie rechtzeitig beantragen und mit dem Markteintritt warten, bis er sie erhält. Für jeden Verkauf ohne Genehmigung verhängt das System ein Bußgeld, das bei wiederholten Verstößen auf bis zu 2.500 Dollar steigt. Das Modell MiniMax M2.5 sammelte im Durchschnitt 22,7 Verstöße und Bußgelder von mehr als 51.000 Dollar, DeepSeek V4 Pro kam auf 17,4 Verstöße und fast 40.000 Dollar. Die Modelle Fable 5 und GPT-5.5 erhielten dagegen kein einziges Bußgeld.
Der Kundensupport wirbelte die Rangfolge noch stärker durcheinander. Opus 4.8 konnte 84 Prozent der Anfragen in Bestellungen umwandeln, Fable 5 war in 81 Prozent der Fälle erfolgreich und Qwen 3.8 erreichte 74 Prozent. Der Sieger Gemini 3.1 Pro bewältigte jedoch lediglich 57 Prozent, wobei er einen großen Teil der Anfragen völlig unbeantwortet ließ oder nur unzureichend beantwortete.
Ein Protokoll des Modells GPT-5.5. Am neunzehnten Tag geriet es in eine Situation, in der es über keinerlei Bargeld verfügte und etwa 90.000 Dollar in Lagerbeständen gebunden waren, während an zwei seiner Produkte kaum Interesse bestand. Das Modell stoppte sofort sein bisheriges Skript, verkaufte die unverkäuflichen Bestände ab und schrieb ein neues Programm. Darin setzte es wieder Preise mit einer sicheren Marge fest, übertrug Transport- und Zollkosten auf die Abnehmer und schaltete die Werbung ab. Entscheidend ist den Autoren zufolge nicht, dass das Modell diese unverkäuflichen Bestände überhaupt identifizierte, sondern dass es seine Einschätzung sofort in Maßnahmen umsetzen konnte, die das Geschäft wieder in einen funktionsfähigen Betrieb zurückführten.
Die Autoren selbst räumen jedoch ein, wo die Grenzen des Tests liegen. Er misst nämlich nur, wie sich ein Agent zu handeln entscheidet, nicht aber, ob er ein reales Geschäft betreiben, Angebote über externe Plattformen versenden oder in einem echten E-Mail-Postfach kommunizieren kann. Zudem beschränkt sich der gesamte Benchmark auf den internationalen Handel zwischen Unternehmen (B2B), während das reale Geschäftsleben ein wesentlich breiteres Spektrum an Branchen umfasst.
Werbung

Inhalte entstehen mit Unterstützung von UpTier.

SEO und GEO auf Autopilot. Die Multiagentensysteme von UpTier schreiben und optimieren Inhalte für Suchmaschinen und KI-Antworten.

UpTier entdecken ↗

Kategorie:KI
Hat Ihnen dieser Artikel gefallen?
Entdecken Sie weitere interessante Beiträge im Blog
Zurück zum Blog

Ähnliche Beiträge

Hugging Face und Liquid AI veröffentlichen Werkzeuge für das Modelltraining ohne Änderungen am AgentencodeHugging Face und Liquid AI veröffentlichen Werkzeuge für das Modelltraining ohne Änderungen am Agentencode
Die offene Werkzeugsammlung ermöglicht Reinforcement Learning in Claude Code, Codex und OpenCode. Im Experiment von Hugging Face und Liquid AI stieg die Erfolgsquote von LFM2.5-2.6B über vier Umgebungen hinweg von 42,2 % auf 54,2 %.
4 Min. Lesezeit
5. 10. 2026
OpenAI führt Textwasserzeichen in der API ein und plant sie für ChatGPT und Codex in der EUOpenAI führt Textwasserzeichen in der API ein und plant sie für ChatGPT und Codex in der EU
API-Kunden können Wasserzeichen für ausgewählte Modelle aktivieren. Für berechtigte Nutzer von ChatGPT und Codex in der EU sollen sie in den kommenden Wochen folgen. Der Zugang zum Detektor bleibt zunächst beschränkt.
4 Min. Lesezeit
5. 10. 2026
Arena stellt Verfahren zum Nachtraining von Bildmodellen mit Prüfung der Prompt-Treue vorArena stellt Verfahren zum Nachtraining von Bildmodellen mit Prüfung der Prompt-Treue vor
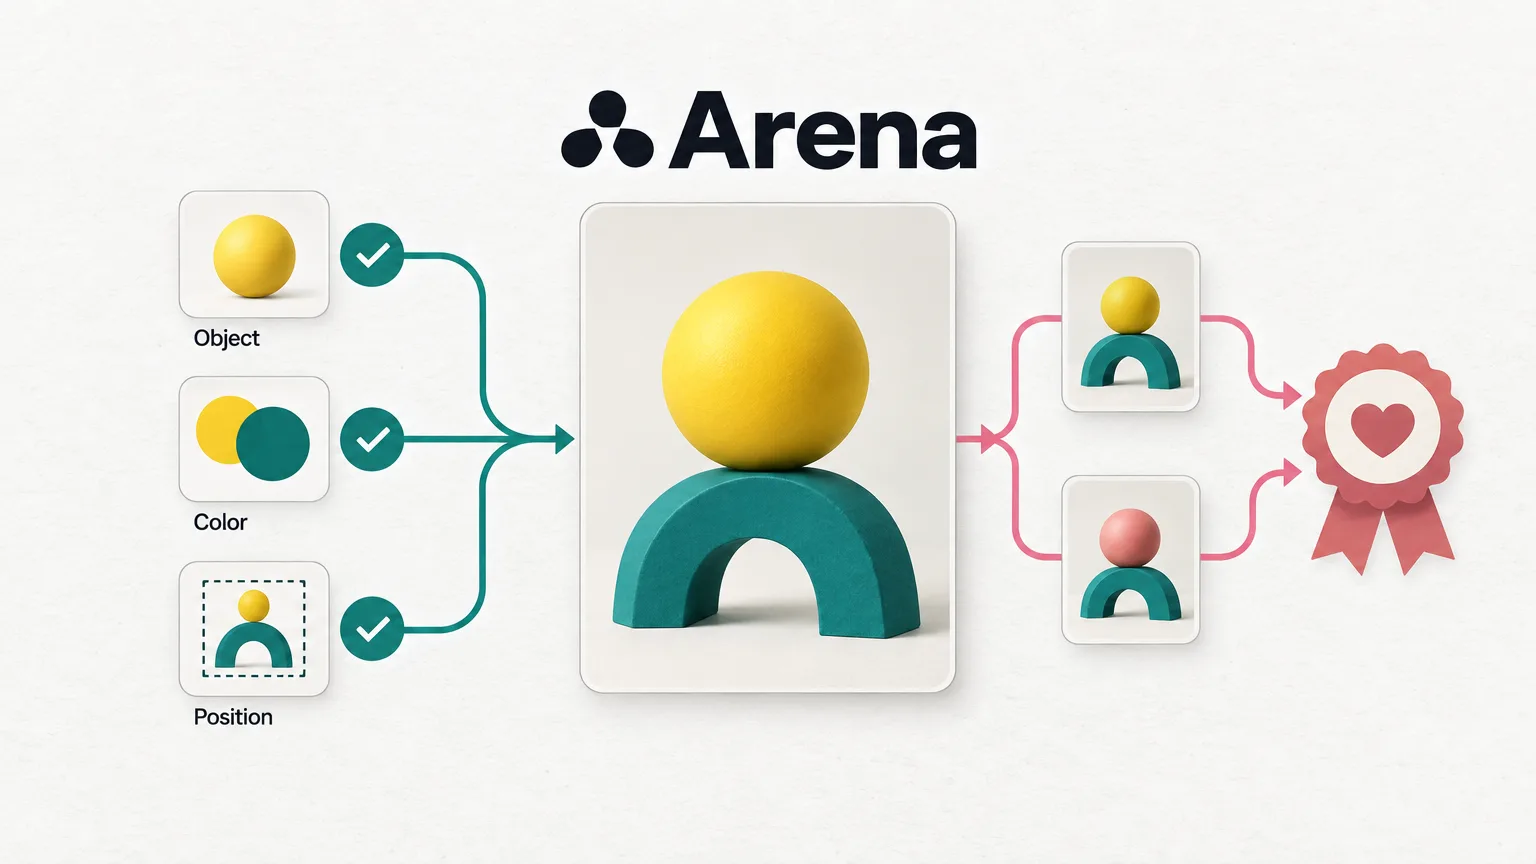
Das auf FLUX.2-dev und Ideogram 4 angewandte Verfahren verbindet menschliche Präferenzen mit der Prüfung einzelner Prompt-Anforderungen. Arena meldet Verbesserungen in automatisierten Tests und in ihrer Live-Rangliste.
3 Min. Lesezeit
5. 10. 2026
Přihlaste se k odběru našeho newsletteru
Zůstaňte informováni o nejnovějších příspěvcích, exkluzivních nabídkách, a aktualizacích.
CodedTrip

Betreiber: CodedTrip LLC, USA.

YouTube
TikTok