

Wie Anthropic die Zukunft der KI-Forschung auf die Zusammenarbeit mehrerer Agenten aufgebaut hat
Claude von Anthropic verfügt nun über eine Forschungsfunktion (Research feature), mit der das Web, Google Workspace und weitere integrierte Dienste zur Lösung komplexer Aufgaben durchsucht werden können. Dieses System nutzt mehrere gleichzeitig arbeitende Claude-Agenten und stellt damit eine grundlegende Abkehr von herkömmlichen einfachen KI-Assistenten dar. Das Entwicklerteam unter der Leitung von Jeremy Hadfield, Barry Zhang, Kenneth Lien, Florian Scholz, Jeremy Fox und Daniel Ford teilt Erkenntnisse aus diesem Weg vom Prototyp bis zur Produktionsbereitstellung.
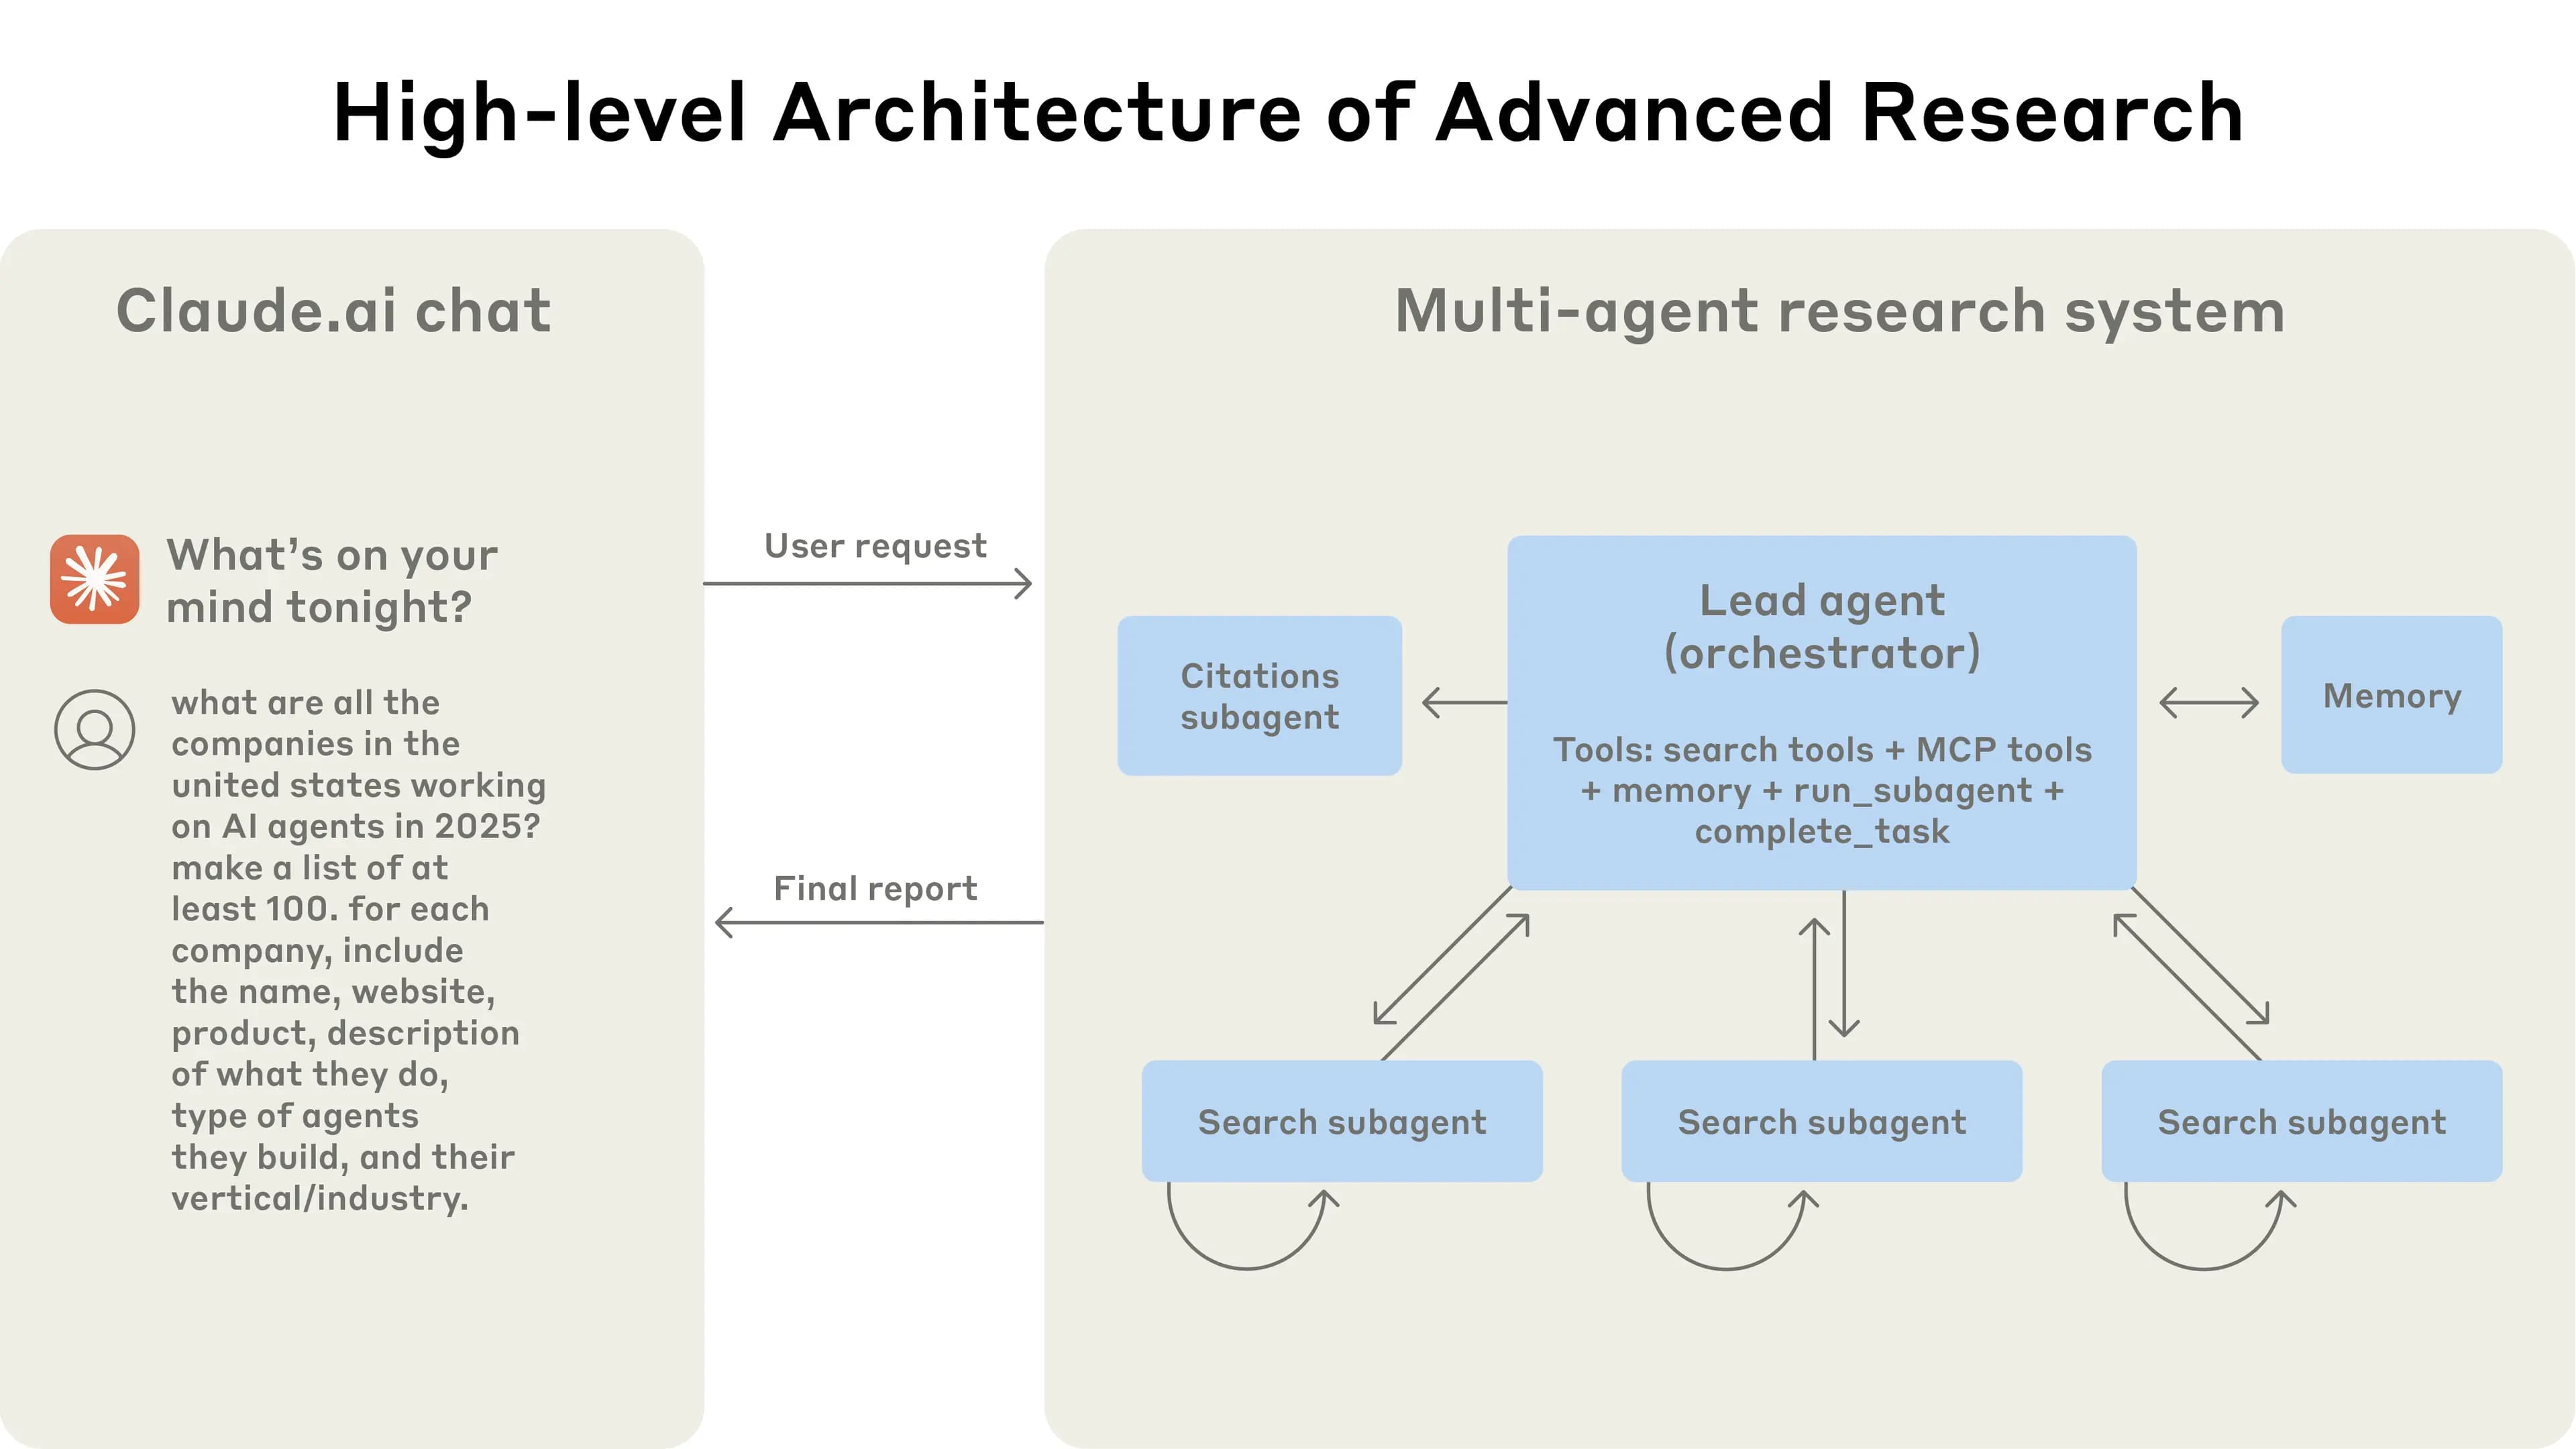
Der Weg vom experimentellen System zur Produktionsversion vermittelte den Entwicklern wichtige Erkenntnisse über Systemarchitektur, Werkzeugdesign und Prompt Engineering. Ein Multi-Agenten-System besteht aus mehreren Agenten – großen Sprachmodellen, die autonom Werkzeuge in einem Zyklus verwenden – und diese arbeiten zusammen. Ihre Forschungsfunktion umfasst einen Agenten, der den Forschungsprozess auf Grundlage von Benutzeranfragen plant und anschließend Werkzeuge nutzt, um parallele Agenten zu erstellen, die gleichzeitig nach Informationen suchen.
Warum Multi-Agenten-Systeme einzelnen Modellen überlegen sind
Forschungsarbeit umfasst offene Probleme, bei denen es sehr schwierig ist, die erforderlichen Schritte im Voraus vorherzusagen. Für die Untersuchung komplexer Themen lässt sich kein fester Weg fest codieren, da der Prozess von Natur aus dynamisch und vom Verlauf abhängig ist. Wenn Menschen Forschung betreiben, neigen sie dazu, ihren Ansatz auf Grundlage neuer Entdeckungen kontinuierlich anzupassen und Spuren zu verfolgen, die sich während der Untersuchung ergeben.
Diese Unvorhersehbarkeit macht KI-Agenten besonders geeignet für Forschungsaufgaben. Das Wesen der Suche ist Kompression – die Destillation von Erkenntnissen aus einem umfangreichen Korpus. Unteragenten erleichtern die Kompression, indem sie parallel mit ihren eigenen Kontextfenstern arbeiten und gleichzeitig verschiedene Aspekte einer Frage untersuchen, bevor sie die wichtigsten Token für den leitenden Forschungsagenten verdichten.
Interne Bewertungen von Anthropic zeigten, dass Multi-Agenten-Forschungssysteme insbesondere bei Anfragen vom Typ „breadth-first“ (Breitensuche) herausragen, bei denen mehrere unabhängige Richtungen gleichzeitig verfolgt werden. Sie stellten fest, dass ein Multi-Agenten-System mit Claude Opus 4 als Hauptagent und Claude Sonnet 4 als Unteragenten den Einzelagenten Claude Opus 4 in ihrer internen Forschungsbewertung um 90,2 % übertraf. Als es beispielsweise darum gebeten wurde, alle Vorstandsmitglieder von Unternehmen aus dem Informationstechnologiesektor des S&P 500 zu identifizieren, fand das Multi-Agenten-System die richtigen Antworten, indem es diese Aufgabe in Aufgaben für Unteragenten aufteilte, während das System mit einem einzelnen Agenten aufgrund langsamer, sequenzieller Suchvorgänge keine Antwort finden konnte.
Architektur und Funktionsweise des Systems in der Praxis
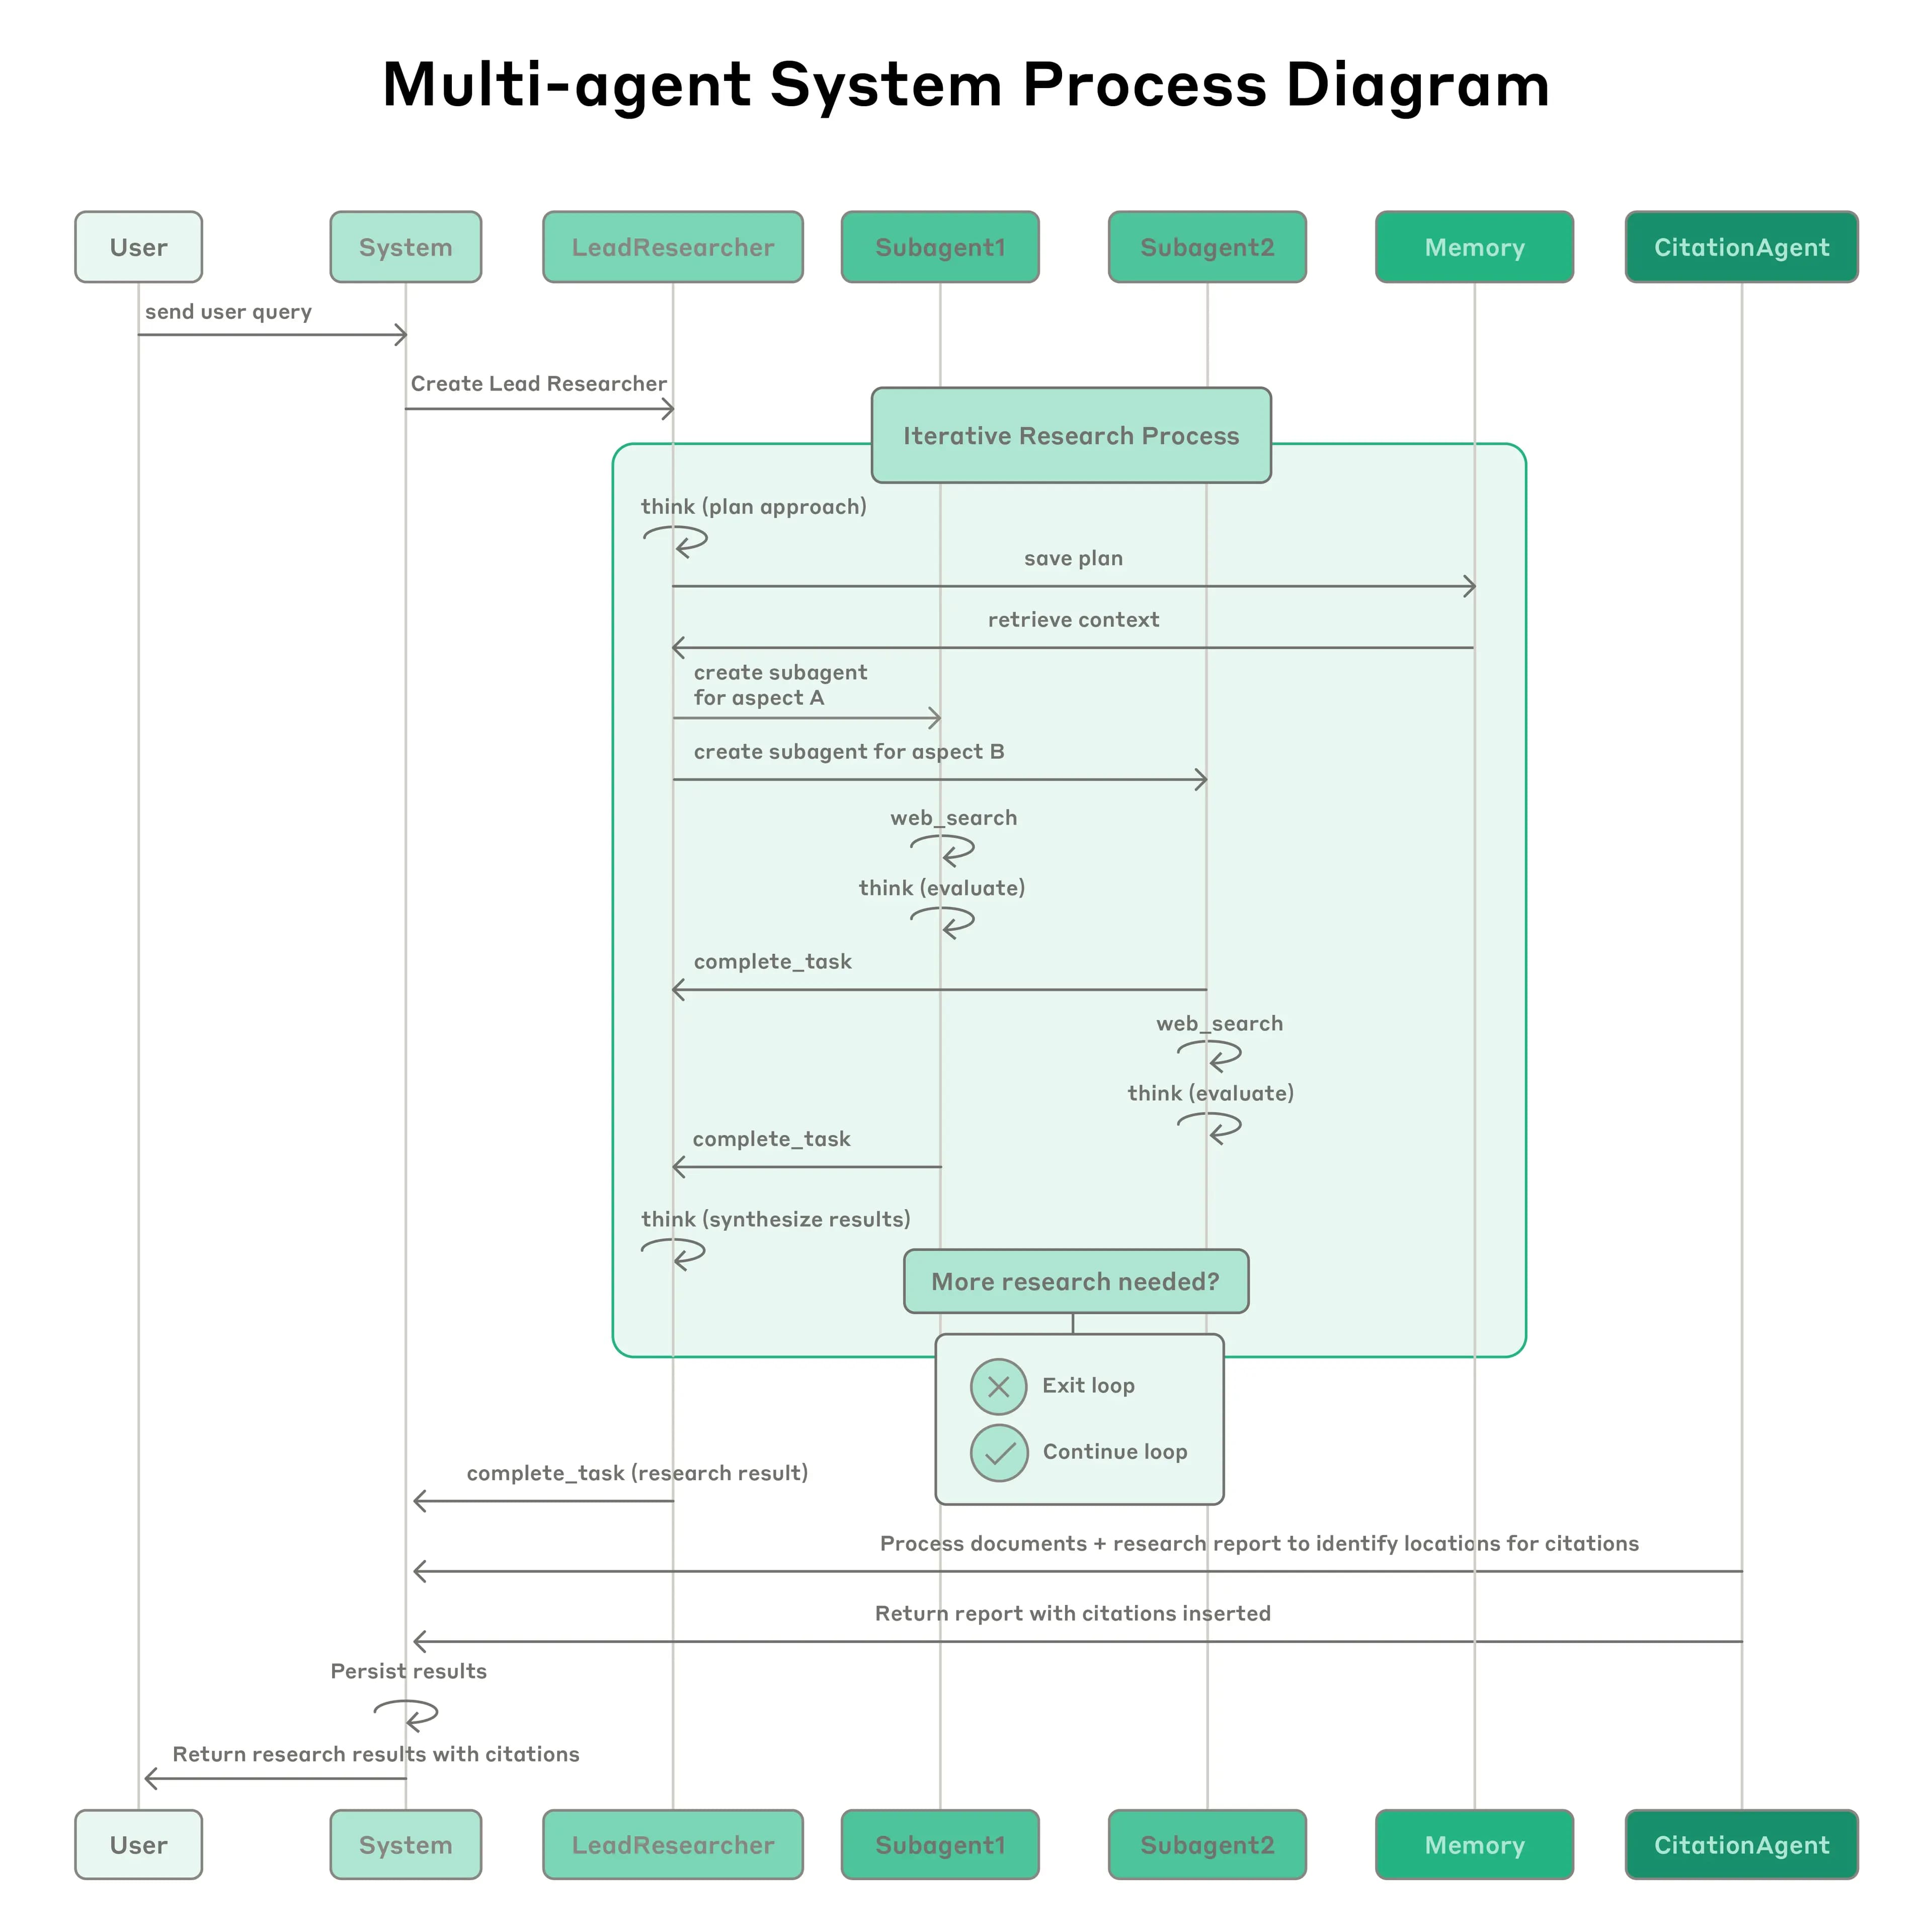
Das Forschungssystem von Anthropic verwendet eine Multi-Agenten-Architektur nach dem Orchestrator-Worker-Muster (orchestrator-worker pattern), bei der der Hauptagent den Prozess koordiniert und Aufgaben an spezialisierte Unteragenten delegiert, die parallel arbeiten. Wenn ein Benutzer eine Anfrage stellt, analysiert der Hauptagent sie, entwickelt eine Strategie und erstellt Unteragenten, die gleichzeitig verschiedene Aspekte untersuchen.
Die Unteragenten fungieren als intelligente Filter, indem sie iterativ Suchwerkzeuge verwenden, um Informationen zu sammeln, und anschließend dem Hauptagenten eine Liste von Unternehmen zurückgeben, damit dieser die endgültige Antwort zusammenstellen kann. Herkömmliche Ansätze mit abrufgestützter Generierung (Retrieval Augmented Generation – RAG) verwenden eine statische Suche – sie laden einige Abschnitte, die der Eingabeanfrage am ähnlichsten sind, und nutzen diese Abschnitte, um eine Antwort zu generieren. Im Gegensatz dazu verwendet ihre Architektur eine mehrstufige Suche, die relevante Informationen dynamisch findet, sich an neue Erkenntnisse anpasst und die Ergebnisse analysiert, um qualitativ hochwertige Antworten zu formulieren.
Technische Herausforderungen und Lösungen
Multi-Agenten-Systeme verbrauchen schnell Token. Ihren Daten zufolge verwenden Agenten üblicherweise etwa viermal mehr Token als Chat-Interaktionen, und Multi-Agenten-Systeme verbrauchen etwa 15-mal mehr Token als Chats. Damit Multi-Agenten-Systeme wirtschaftlich tragfähig sind, benötigen sie Aufgaben, deren Wert hoch genug ist, um die gesteigerte Leistung zu rechtfertigen.
Die Entwickler mussten Probleme bei der Koordination der Agenten lösen – frühe Agenten machten Fehler, etwa indem sie für einfache Anfragen 50 Unteragenten erstellten, das Web endlos nach nicht existierenden Quellen durchsuchten und sich gegenseitig durch übermäßige Aktualisierungen ablenkten. Da jeder Agent durch einen Prompt gesteuert wird, war Prompt Engineering ihr wichtigster Hebel zur Verbesserung dieser Verhaltensweisen.
Bewertung und Tests im realen Betrieb
Die Bewertung von Multi-Agenten-Systemen bringt einzigartige Herausforderungen mit sich. Herkömmliche Bewertungen gehen häufig davon aus, dass eine KI jedes Mal dieselben Schritte ausführt, doch Multi-Agenten-Systeme funktionieren nicht auf diese Weise. Selbst bei denselben Ausgangspunkten können Agenten völlig unterschiedliche gültige Wege wählen, um ihr Ziel zu erreichen. Anstatt zu prüfen, ob die Agenten die im Voraus festgelegten „richtigen“ Schritte befolgt haben, sind flexible Bewertungsmethoden erforderlich, die beurteilen, ob die Agenten die richtigen Ergebnisse erzielt und dabei zugleich einen sinnvollen Prozess eingehalten haben.
Anthropic begann die Bewertung mit kleinen Stichproben von etwa 20 Anfragen, die tatsächliche Nutzungsmuster repräsentierten. Außerdem setzten sie einen LLM-basierten Bewerter ein, der jede Ausgabe anhand folgender Kriterien bewertete: faktische Richtigkeit, Genauigkeit der Quellenangaben, Vollständigkeit, Qualität der Quellen und Effizienz der Werkzeuge. Die menschliche Bewertung erfasst, was der Automatisierung entgeht – darunter halluzinierte Antworten auf ungewöhnliche Anfragen oder subtile Verzerrungen bei der Auswahl von Quellen.
Benutzer berichten, dass Claude ihnen geholfen hat, bislang unberücksichtigte Geschäftsmöglichkeiten zu entdecken, sich in komplexen Optionen der Gesundheitsversorgung zurechtzufinden, schwierige technische Fehler zu beheben und bis zu mehrere Arbeitstage einzusparen, indem es Forschungsverbindungen aufdeckte, die sie selbst nicht gefunden hätten. Zu den häufigsten Nutzungsarten gehören die Entwicklung von Softwaresystemen (10 %), die Erstellung professioneller Inhalte (8 %), Geschäftsstrategien (8 %), akademische Forschung (7 %) und die Überprüfung von Informationen (5 %).


