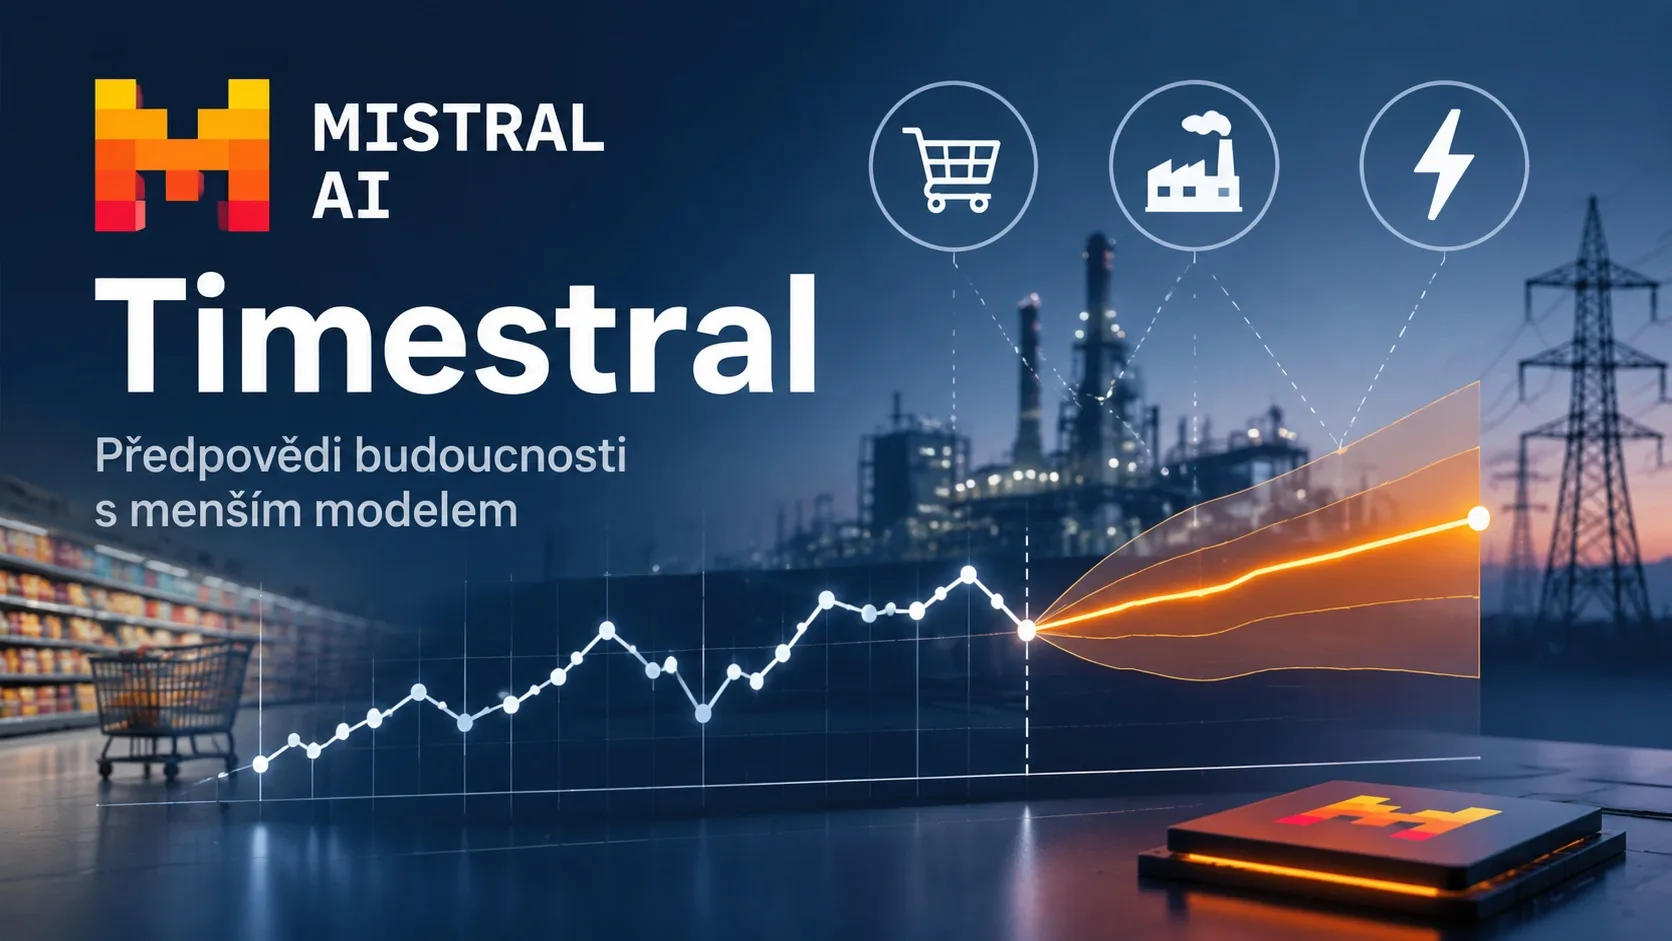
Francouzská firma Mistral AI vydala v polovině října Timestral, svou první rodinu modelů umělé inteligence. Tyto modely negenerují text, ale z historických číselných údajů odhadují jejich budoucí vývoj. Může jít o prodeje v obchodě, spotřebu elektřiny nebo teplotu čerpadla v továrně. Největší verze má jen 209 milionů parametrů, přesto podle tvůrců obsadila první místo ve všech třech hlavních veřejných testech přesnosti předpovědí.
Na předpovědi už nestačí jen chatbot
Firmy každý den pracují s takzvanými časovými řadami. Jde o čísla zapisovaná v pravidelných intervalech, jako jsou denní tržby, hodinová spotřeba proudu nebo údaje z čidel. Vycházejí z nich rozhodnutí o objednávkách zboží, údržbě strojů nebo nákupu energie.
Osvědčené statistické metody, například ARIMA, se obvykle nastavují zvlášť pro každou řadu a učí se jen z její vlastní historie. Modely hlubokého učení sice najdou složitější vzorce napříč mnoha řadami, ale většinou se trénují od nuly pro každou sadu dat a naučené znalosti do jiného oboru nepřenášejí. U tisíců výrobků nebo strojů to znamená spoustu práce. Velké jazykové modely v tomto případě nepomohou, protože se naučily předvídat další slovo, nikoli konkrétní čísla.
Timestral přenáší do světa čísel princip, na kterém stojí jazykové modely. Nejdříve se naučí obecné zákonitosti na obrovském množství různorodých dat a pak je bez dalšího trénování použije na data, která nikdy neviděl. Mistral tvrdí, že to funguje i v oborech s nedostatkem dat.
Obchod například plánuje zásoby na příští měsíc. Vývojář do modelu nahraje historii denních prodejů a požádá o předpověď na 30 dní. Přidat může i doprovodné údaje, jako jsou minulé slevové akce nebo svátky v předpovídaném období. Model nevrací jedno číslo, ale 21 odhadů od pesimistických po optimistické. Skladový systém pak může počítat s vyšším odhadem, aby byl připravený i na silnější poptávku.
Malý model porazil větší soupeře
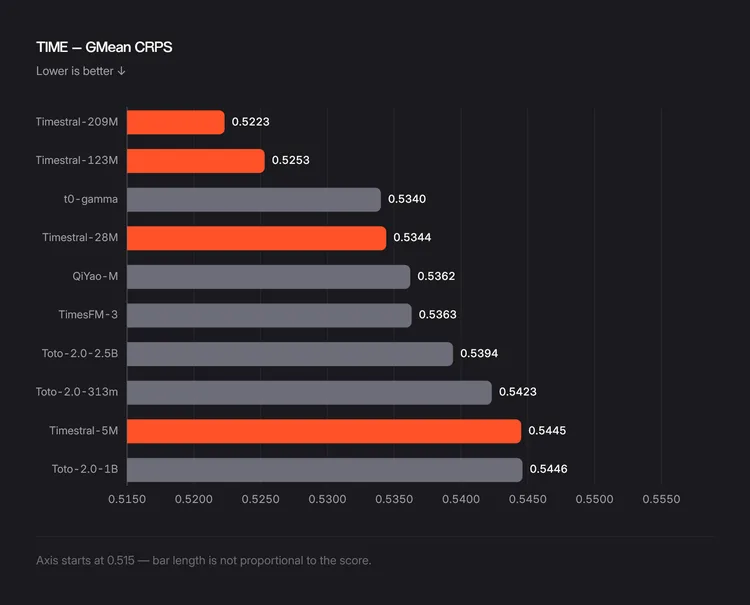
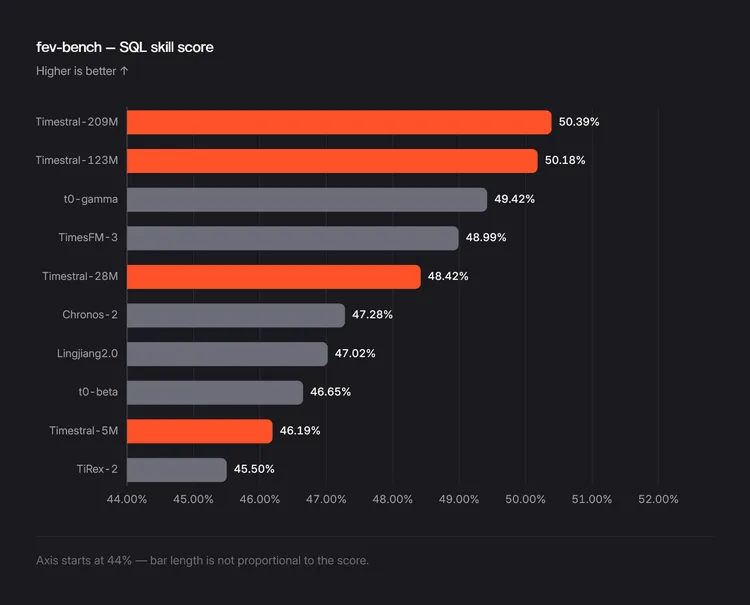
V testech GIFT-Eval, TIME a fev-bench skončil Timestral mezi předtrénovanými modely první ve všech pěti sledovaných měřítkách. Dosavadního lídra překonal se dvěma třetinami jeho parametrů, a to jedinou verzí modelu bez skládání více modelů dohromady.
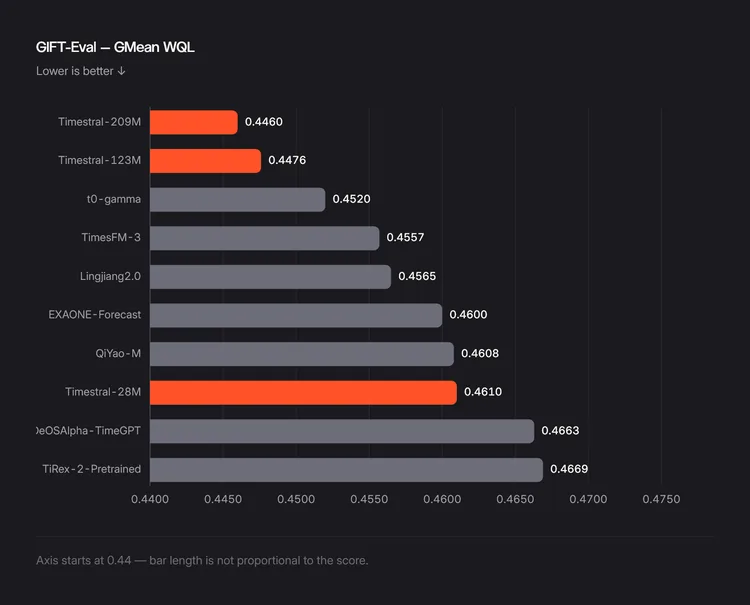
Timestral vychází ve čtyřech velikostech s 5, 28, 123 a 209 miliony parametrů. Větší verze předpovídají přesněji, menší rychleji a levněji. Podle Mistralu žádný veřejně dostupný model stejné velikosti nepředpovídá lépe. Verze s 28 miliony parametrů porazila v testech GIFT-Eval a TIME zhruba čtyřikrát větší Chronos-2, největší verze překonala TimesFM-3 i Falcon-2.0, přestože má méně parametrů.
Model nepotřebuje výkonnou grafickou kartu. Na běžném serverovém procesoru s osmi vlákny trvá předpověď na den dopředu ze tří týdnů dat zaznamenávaných po patnácti minutách nejmenší verzi 17 milisekund a největší 113 milisekund. Verze se 123 miliony parametrů zaostává za největší jen o 0,2 procenta a spotřebuje asi tři čtvrtiny jejího času.
Timestral stojí na stejné architektuře jako jazykové modely, tedy na takzvaném transformeru. Místo slov ale zpracovává balíčky po 32 číselných hodnotách a najednou si prohlédne až 32 768 časových kroků.
Starší modely při učení skrývají hodnoty, které mají předpovědět. Ty pak vypadají jako chybějící data a ztratí se i jako podklad pro další předpovědi. Timestral nechává celou historii na místě a přidává k ní zvláštní prvky zastupující budoucí hodnoty. Každé změřené číslo tak slouží jako cíl i jako souvislost a skutečné mezery v datech zůstávají označené.
Každá vstupní řada dostane svou roli. Buď jde o předpovídanou hodnotu, o údaj známý jen z minulosti, nebo o údaj známý i dopředu, jako je kalendář svátků či předpověď počasí. Informace proudí jen z doprovodných údajů k předpovídaným hodnotám, takže model nemůže nahlédnout do vlastní budoucnosti.
Většinu tréninkových dat tvořila uměle vytvořená čísla s trendy, sezónními výkyvy a šumem, mezi kterými Mistral vytvořil i složitější vzájemné vztahy. V první fázi se model učil jen na umělých datech, ve druhé na kombinaci skutečných a umělých dat se čtyřikrát delším úsekem historie.
Timestral a továrna
Mistral model ukazuje na průmyslovém závodě s tisíci čidly. Vibrace, teplota a tlak čerpadla spolu souvisejí, a Timestral je proto sleduje společně. Zvládne i údaje, které nejsou čísly, jako je den v týdnu nebo stav stroje, a počítá s věcmi známými předem, například s plánem výroby nebo plánovanými odstávkami. Naplánované zvýšení zátěže tak nevyhodnotí jako problém.
Model může běžet v monitorovacích systémech a nepřetržitě hlídat data z čidel. Když narazí na podezřelé chování čerpadla, převezme řízení softwarový agent postavený na jazykovém modelu. Dohledá podobné poruchy z minulosti, nechá další agenty projít záznamy o údržbě, směnové deníky, manuály i údaje ze souvisejících strojů a sepíše návrh diagnózy s podklady a dalšími kroky. Vedoucí závodu tak místo pouhého alarmu dostane vysvětlení a plán.
Na každý úkol jiný model
Timestral zapadá do trendu specializovaných modelů. TabPFN dopočítává hodnoty v tabulkách a v pokusech předčil běžné metody strojového učení. Kumo Relational pracuje s propojenými databázemi zákazníků, objednávek a výrobků a porazil srovnávací modely ve 41 úlohách na 15 databázích. Jev podle stavu aplikace vybírá z předem daných rozhodnutí a třídí záznamy.
Dosud přidání předpovědí do aplikace znamenalo sbírat a připravovat data, trénovat vlastní model a starat se o něj. Agent, který hledá zboží ohrožené vyprodáním, by teď mohl práci rozdělit. Timestral odhadne poptávku, TabPFN riziko vyprodání, Kumo Relational zpoždění dodavatelů a Jev roztřídí výsledky na běžné sledování a případy pro člověka. Jazykový model vše spojí a označí rozhodnutí, která potřebují schválení.
Tyto modely ale stále potřebují čistá data, vlastní testování a průběžnou kontrolu. Nejsou vždy rychlejší ani levnější než tradiční nástroje jako XGBoost nebo CatBoost, jejich výhodou je hlavně úspora práce při vývoji.
Dostupnost a úprava na míru
Data konkrétní firmy se mohou chovat jinak než data v testech a časem se mění. Firmy proto mohou Timestral doladit na vlastních datech přes nástroj Mistral Forge, přidat vlastní doprovodné údaje nebo si nechat vygenerovat umělá data podobná svému oboru. Celé řešení lze provozovat na vlastních serverech, a to i v prostředí úplně odpojeném od internetu.
Model je k vyzkoušení na GitHubu pod upravenou licencí MIT. Podrobnou technickou zprávu s kompletními výsledky Mistral slibuje zveřejnit později.