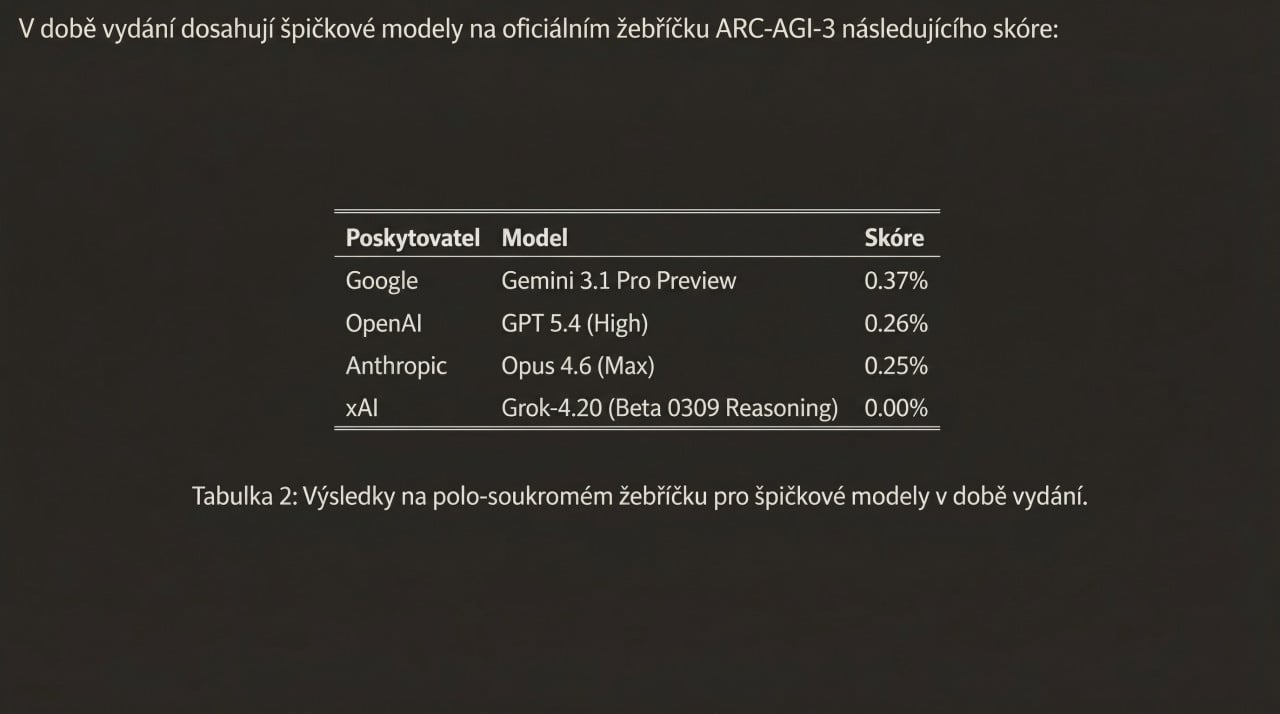
Nezisková organizace ARC Prize Foundation vydala nový test pro umělou inteligenci s názvem ARC-AGI-3. Výsledky jsou pro AI naprosto zdrcující: nejsilnější modely světa jako Gemini 3.1, GPT-5 nebo Claude dosáhly méně než jednoho procenta, zatímco všichni lidští testéři vyřešili úkoly na 100 %.
Předchozí dvě verze tohoto testu zkoumaly takzvanou pasivní plynnou inteligenci. Jednoduše řečeno: ukázaly modelu statický vzor na mřížce a ptaly se, jak vzor pokračuje. Žádná paměť, žádná interakce, žádné hádání cílů. Bylo to jako zkoušet schopnost rozpoznat obrázky. A do roku 2025 přední modely zvládaly tyto testy na 84 až 90 procent, takže test přestal být užitečný.
Výzkumníci přišli na to proč. Modely se s podobnými úkoly setkaly při tréninku, buď náhodou a nebo záměrně. Dokonce i ve svých vlastních "myšlenkových řetězcích" ukazovaly, že data testu znají. Nešlo přímo o to, že si model data prostě zapamatoval, ale systematické využití toho, že tréninkový i testovací soubor dat byly příliš podobné.
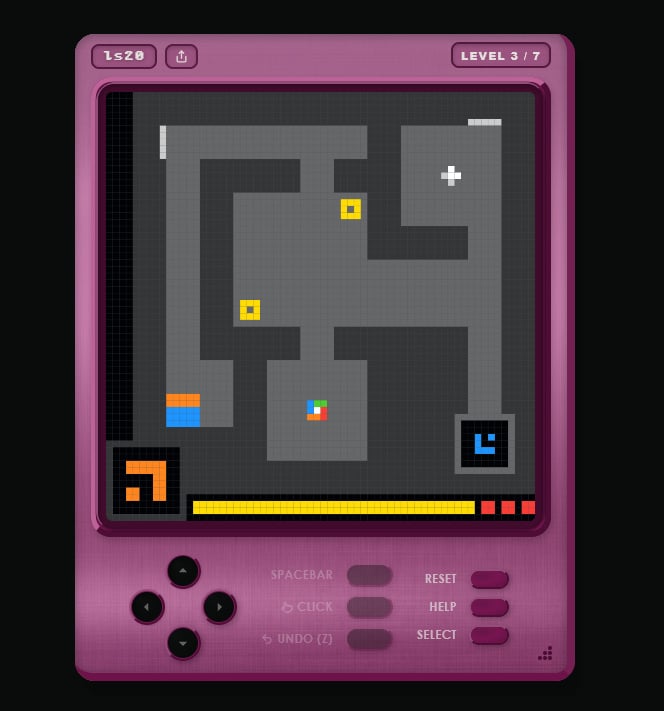
ARC-AGI-3 tento problém vyřešil. Agenti jsou nyní vhozeni do interaktivních her na střídavé tahy. Jediná instrukce: "Hraješ hru. Tvůj cíl je vyhrát. Odpoviš přesnou akcí, kterou chceš provést." Agent vidí barevnou mřížku 64x64 buněk, zvolí akci, sleduje co se změní a musí sám přijít na to, jaký je cíl a jak ho dosáhnout.
Jak se počítalo skóre
Test nepoužívá jednoduché ano/ne hodnocení. Místo toho měří takzvanou RHAE (Relative Human Action Efficiency), česky relativní efektivitu akcí oproti člověku. Počítá se, kolik tahů potřeboval agent ve srovnání s druhým nejlepším lidským výsledkem na stejné úrovni. Výsledek se pak umocní na druhou.
Co to znamená v praxi? Pokud člověk vyřeší úroveň za 10 tahů a agent za 100, nedostane 10 procent, ale pouhé jedno procento. Každý zbytečný tah nezabere jen trochu bodů, vezme jich násobně víc. Navíc existuje strop: pokud agent spotřebuje více než pětinásobek lidských tahů, pokus se okamžitě ukončí.
Proč tak přísně? Protože inteligence není jen o tom, zda úkol zvládneš, ale jak rychle a úsporně se k cíli dostaneš. Slepé zkoušení všech možností, kdy agent zkouší tisíce kombinací, odhaluje nepochopení situace, nikoli schopnost uvažovat.
Během zkušebního období před spuštěním dosáhl nejlepší agent skóre 12,58 procent. Zajímavé je, že to nebyl žádný jazykový model, ale jednodušší systém kombinující posilované učení a prohledávání grafů stavového prostoru. Přední jazykové modely jako Gemini 3.1 skončily na 0,37 procenta na oficiálním žebříčku.
Proč velké jazykové modely selhávají
GPT-5, Claude ani Gemini nejsou hloupé modely. Ve psaní, programování nebo analýze textů jsou mimořádně užitečné. Takže v čem je problém?
Jazykové modely jsou navrženy pro vstup textu a výstup textu. Každý dotaz zpracovávají jako relativně samostatnou jednotku. ARC-AGI-3 naproti tomu vyžaduje, aby agent udržoval ucelený model světa přes stovky po sobě jdoucích kroků, aktualizoval ho s každou novou informací a dělal to celé bez jediného slova v prostředí. Mřížka nemluví, tudíž neexistuje prompt k optimalizaci.
Výzkumníci zaznamenali typický vzorec selhání: jak se kontext prodlužuje přes stovky herních tahů, modely se ztrácí v nahromaděné historii. Výkon klesá ne proto, že by krok po kroku hloupěly, ale protože signál se topí v šumu vlastní paměti. To přesně vysvětluje, proč jednoduchý systém s posilovaným učením překonal všechny jazykové modely o více než třicetinásobek. Byl navržen přesně pro sekvenční rozhodování pod nejistotou. Jazykové modely ne.
Co test říká o tvrzeních "AGI je tady"
Šéf Nvidie Jensen Huang prohlásil, že obecná umělá inteligence (AGI) již existuje. Podobná vyjádření zaznívají i z OpenAI. Výsledky ARC-AGI-3 s tím ostře kontrastují.
Je ale potřeba být přesný: obě tvrzení se nevylučují, protože měří jiné věci. Huang pravděpodobně myslí něco jako "AI zvládne většinu ekonomicky hodnotných úkolů lépe než většina lidí většinu času", což lze obhájit na svých vlastních podmínkách. ARC-AGI-3 měří něco specifičtějšího: schopnost adaptivního, na cíl zaměřeného uvažování v novýchprostředích, kde nedostane žádnou nápovědu. Na to existují data, a ta data říkají, že mezera je zatím propastná. Skóre 0,37 procenta od Gemini 3.1 není nejednoznačný výsledek.
Benchmark záměrně neumožňuje AI skórovat nad 100 procent. I kdyby agent vyřešil prostředí efektivněji než lidé, horní hranice zůstává. To odráží filozofii tvůrců: test neexistuje proto, aby ukázal, že AI předčila člověka, ale aby jasně řekl, kdy se k němu přiblížila.
Soutěž pokračuje dál
ARC Prize 2026 běží se celkovým fondem 2 miliony dolarů a je rozdělena do dvou stop: ARC-AGI-3 a ještě finální ročník starší ARC-AGI-2. Ten kdo jako první dosáhne 100 procent na ARC-AGI-3, bere velkou cenu 700 000 dolarů. Mezníkové kontroly jsou v červnu a září 2026.
Zdali se nějaký tým přiblíží k hranici 50 procent do konce roku, je upřímně nejisté. Pod kvadratickým trestem 50 procent znamená výkon téměř srovnatelný s lidskou efektivitou. To je laťka, ke které žádný současný systém nemá ani trochu blízko.
Číslo, které by mělo zastavit každého, kdo sleduje vývoj AI, není 0,37 procenta. Je to 12,58 procenta od jednoduchého algoritmu pro prohledávání grafů. Žádný jazykový model se mu nepřiblížil. To samo o sobě mluví za vše.
Hru si můžete sami vyzkoušet na webu arcprize.org