Firma z Freiburgu, kterou většina lidí zná jako výrobce generátoru obrázků, oznámila model FLUX 3. Umí vyrobit video dlouhé až dvacet sekund se zvukem, který vzniká ve stejném průchodu jako obraz, zvládá tvorbu i úpravy fotografií a stejný základ pohání software, jenž právě teď ovládá roboty na výrobní lince Audi.
Model rozumí fyzice
Nejsilnější schopností FLUX 3 je video. Model vytvoří klip až dvacet sekund dlouhý a současně s ním vytvoří i zvuk. Model má širokou škálu režimů: text na video, obrázek na video (buď jako první snímek animace, nebo jen jako vizuální předloha), video na video, kdy si model z referenčního klipu odnese třeba tu samou postavu do jiné scény, dopočítání navazujícího obrazu i zvuku ze vstupní nahrávky a přechody mezi předem danými snímky.
K tomu zvládá dialogy v různých jazycích, vypisuje text a animovanou typografii a poslouchá i netradiční poměry stran. Jednotlivé klipy je možné navazovat agentně, takže z nich vzniknou několikaminutové sekvence o více záběrech, a vizuální předlohy pomáhají udržet stejnou postavu napříč scénami. Podle vývojářů si model nejlépe poradí s mimikou lidských tváří a s přiřazením zvuku k tomu, co se v záběru fyzicky děje.
Zajímavější než výčet funkcí je způsob, jakým model vznikl. Učil se z obrázků, videa a zvuku najednou, v jedné architektuře, a předpověď videa spolykala víc než 95 procent veškerého výpočetního výkonu. Aby model vygeneroval video, které nepůsobí divně, musí se naučit kontakt těles, pohyb, hmotnost a příčinu s následkem. Když se v tom sekne, člověk to okamžitě pozná. Zvuk je proti tomu snadná disciplína, tvoří méně než půl procenta všech tokenů. Základem je metoda Self-Flow, kterou firma vyvinula už dřív a která propojuje generování obsahu s porozuměním tomu, co je na něm vidět. FLUX 3 je její výrazně zvětšená verze, natrénovaná na desítkách milionů hodin obecného videa a na stovkách tisíc hodin materiálu zaměřeného na to, jak lidé a roboti manipulují s předměty.
Jak si stojí proti konkurenci
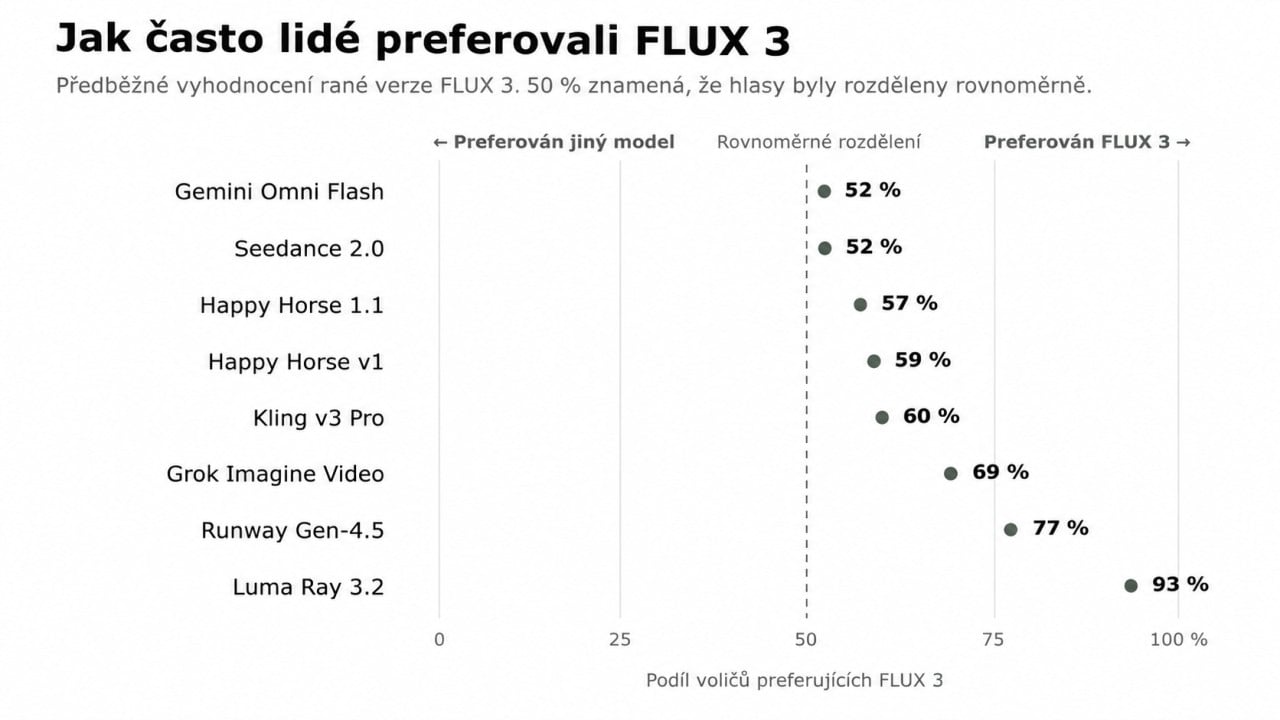
Black Forest Labs pustila do světa výsledky preferenčního testování, kde lidé porovnávali desetisekundové klipy v rozlišení 720p se zvukem, generované z textu. FLUX 3 podle nich vyhrál nad Luma Ray 3.2 v 93 procentech srovnání a nad Runway Gen-4.5 v 77 procentech. Proti Grok Imagine Video mu vyšlo až 69 procent, proti Kling v3 Pro 60, proti Happy Horse v1 59 a proti verzi 1.1 pak 57 procent. Nejtěsněji to bylo se Seedance 2.0 a Gemini Omni Flash, tam skončil na 52 procentech.
Firma sama píše, že jsou to předběžná čísla. VentureBeat ale upozorňuje na věci, které v oznámení úplně chybí: metodika hodnocení, velikost vzorku, počet hodnotitelů, ceník, provozní garance a jakýkoli benchmark obrazového modelu. Bez toho jsou procenta z vlastní kuchyně těžko ověřitelná. Konkurence v generování videa se navíc přetahuje o kvalitu obrazu, přesnost promptu, konzistenci postav i zvuk a nové verze vydává v řádu týdnů, takže žebříček z jednoho týdne nemusí platit v tom dalším.
Obrazová část modelu se veřejnosti otevře až za několik týdnů. Firma hlásí z průběhu tréninku výrazný posun proti starším FLUX modelům především ve dvou věcech: ve zpracování složitých zadání a ve vypisování textu v obraze, a to i v jiných jazycích než v angličtině.
FLUX-mimic, odnož pro roboty, která z modelu vytahuje pohyby
Black Forest Labs si myslí, že model, který dokáže věrohodně předpovědět video, si musel vytvořit vnitřní představu o tom, jak svět funguje. A pokud tam ta představa je, měla by se z ní dát vytáhnout i informace o tom, jak ve světě jednat.
O to jde u modelu FLUX-mimic, který vznikl společně s firmou Mimic robotics. Na základ modelu FLUX 3 se nasadil odlehčený dekodér akcí, který si bere mezivrstvy z té části, jež předpovídá video, a překládá je do pohybů robota. Firma zkoušela i druhou cestu, tedy zabudovat předpověď akcí přímo do FLUX 3. Lidské hodnocení generovaných klipů tehdy nejprve spadlo až o desetinu, po 3500 krocích byl ale model zpátky na původní úrovni a k tomu už předpovídal akce. Na benchmarcích dekodér předčí dosavadní modely typu vision-language-action i tehdy, když se do samotného FLUX 3 vůbec nesahá a učí se jen ten malý dekodér navrch. Starší přístupy takhle ochuzené selhávají, protože fyziku světa v sobě nemají. Když se doladí společně kostra i dekodér, hlásí FLUX-mimic nejlepší dosažené úspěšnosti.
Cílem je obecná manipulace s předměty. Robot má rozumět tomu, co vidí, odhadnout, co se stane, když do věci strčí, a naučit se nový úkon z minima ukázek. Číslo, kvůli kterému se o tom mluví, je právě tohle: u některých úkonů stačí necelá půlhodina robotických dat, kde dřívější postupy potřebovaly třicet a více hodin. „Nejtěžší část robotiky jsou data," říká Elvis Nava, technický šéf mimic robotics. Každý nový úkon podle něj normálně znamená hodiny toho, jak robot opakuje totéž, zatímco FLUX-mimic si ho osvojí během minut. Stojí za zmínku i vedlejší efekt: když robot nechytí předmět, zkusí to znovu a úkon dokončí, aniž by mu to někdo ukázal.
Model běží na montážní hale Audi
Audi patří k nejautomatizovanějším výrobcům v automobilovém průmyslu, což mu dává přesný přehled o tom, kde běžná automatizace pořád naráží. Úkony s poddajnými díly a jemnou manipulací zůstávají ruční hlavně z ekonomických důvodů: u prémiové výroby s mnoha variantami je přestavba robotické buňky pro každý případ moc drahá.
Mimic nasadila FLUX-mimic na skládání dílů do dělených palet, vkládání řídicích jednotek do těsných přípravků, montáž komponent a manipulaci s měkkými materiály typu těsnění a kabelů, na které se konvenční automatizace nikdy nedostala. „Viděli jsme tyto roboty řešit složitou manipulaci s měkkými, poddajnými díly, která by s konvenční robotikou byla jednoduše nemožná," říká Christoph Schneider z Audi Production Lab.
Na lince ovšem nestačí odpovědět správně, ale i včas.Cesta od vstupu senzorů k vnitřní reprezentaci světa zabere pod 80 milisekund na jediné grafické kartě NVIDIA RTX 5090. Mimic doladila i zbytek řetězce, takže celý samostatný robotický systém reaguje asi za 101 milisekund, což je srovnatelné s reakční dobou lidského zraku.
Dostupnost
FLUX 3 se rozpadá do čtyř produktových linií. FLUX 3 Video se zvukem a FLUX 3 Action jsou od minulého týdne v uzavřeném předběžném přístupu, kam se může přihlásit kdokoli, ale schvaluje to firma. FLUX 3 Image se má rozjet během několika týdnů, po něm má přijít běžná dostupnost. Posledním kusem je FLUX 3 Dev, tedy otevřené váhy multimodální kostry. Předpověď akcí zůstane zatím u vybraných výzkumných a komerčních partnerů, prvním z nich je Mimic robotics. Veřejné rozhraní API momentálně neexistuje.