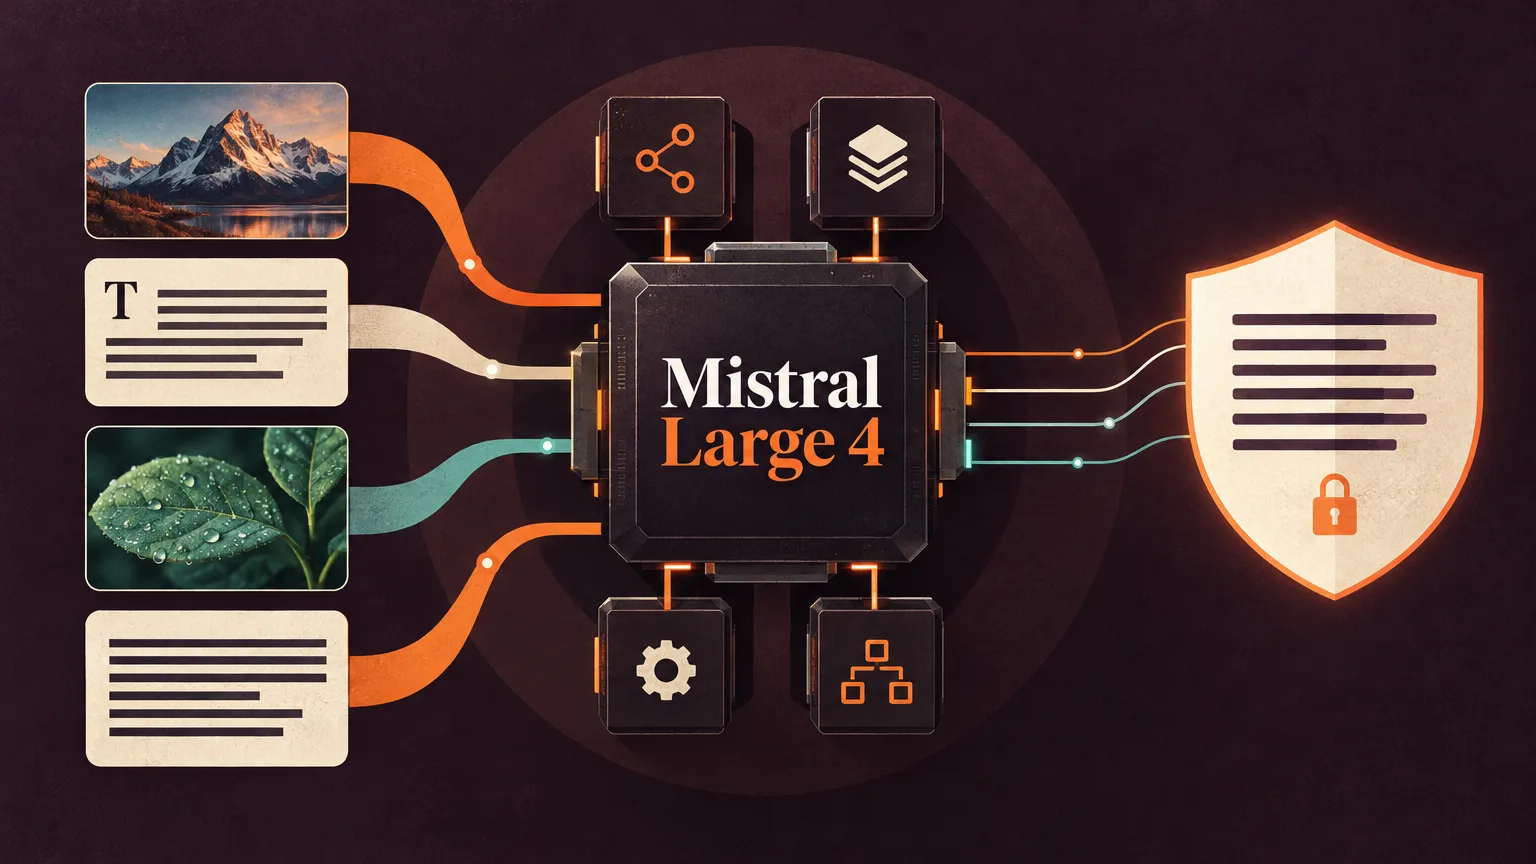
Mistral vydal Large 4, vícejazyčný model s otevřenými vahami, který přijímá text i obrázky a generuje text. Novinka přezdívaná Le Chonk má kontextové okno o milionu tokenů a míří především na obrannou kybernetickou bezpečnost. Vývojáři ji mohou nasadit sami nebo využívat přes vzdálenou službu.
Obrazový vstup a expertní architektura
Large 4 má přibližně bilion parametrů, z nichž je aktivních 49 miliard. Pro práci s obrázky používá obrazový enkodér Pixtral; vedle něj kombinuje expertní sítě s řídkou pozorností.
Podle Hugging Face model pro každý token vybírá čtyři ze 128 expertů a současně používá jednoho sdíleného experta. Model tak při zpracování jednotlivého tokenu nezapojuje celou expertní síť.
Výsledky v bezpečnosti a programování
V části testu Artificial Analysis Cyber Index, která vyžaduje reprodukovat skutečnou zranitelnost v softwaru s otevřeným zdrojovým kódem a následně ji opravit, dosáhl model podle Hugging Face výsledku 82 %. Mistral uvádí, že při interním testování byl Large 4 užitečný také při analýze malwaru, určování priorit zranitelností a psaní detekčních pravidel. Pro tyto úlohy přitom nebyl výslovně trénován.
Hugging Face dále uvádí úspěšnost 93 % při řešení 40 úloh bezpečnostních soutěží v benchmarku Cybench a 93,3% odolnost proti útokům v testu Lakera B3. U kybernetických zadání z JailbreakBench, StrongREJECT a AgentHarm měl model podle Hugging Face vyšší průměrnou míru odmítnutí než ostatní testované modely s otevřenými vahami.
V programovacích testech získal Large 4 podle Hugging Face 61,7 % v DeepSWE v1.1, 59,4 % v SWE-Atlas-QnA a 28,3 % v Terminal-Bench 4. Souhrnný výsledek 49,8 % v Coding Agent Index jej řadí před DeepSeek V4 Pro 0813 a Qwen3.8 Max.
V testech podnikových pracovních postupů a dlouhodobějších profesionálních úloh uvádí Hugging Face 59,9 % v AutomationBench a 1 393 Elo v AA-Briefcase.
Varianty a možnosti nasazení
Oficiální váhy jsou dostupné ve variantách FP8 a NVFP4. Distribuce se řídí licencí Mistral Ecosystem Open-Weight License, která omezuje nabídky modelu jako služby. Unsloth a tým llama.cpp připravili také verze ve formátu GGUF.
Od vydání model podporují knihovny Transformers, vLLM a llama.cpp. Varianta NVFP4 má menší paměťové nároky a při použití s vLLM vyžaduje GPU NVIDIA Blackwell. Podle Hugging Face lze dvoubitové kvantizované verze od týmu llama.cpp spustit na jednom počítači Apple Silicon Ultra s 512 GB jednotné paměti; ostatní uvedené kvantizace vyžadují distribuovanou inferenci.
Pro vzdálené nasazení nabízí Hugging Face Inference Endpoints, bezserverová inference je dostupná přes Inference Providers. Připravená konfigurace Inference Endpoints používá váhy FP8 na osmi GPU NVIDIA H200, podporuje kontext až 131 tisíc tokenů a současně zpracuje až 16 požadavků. Její API přijímá obrázky a podporuje volání nástrojů, strukturované výstupy i streamování.
Nastavení uvažování a dotrénování
Míru uvažování lze nastavit na low, medium nebo high; výchozí hodnotou je high. Uvažování však nelze vypnout: i při nastavení none se použije high.
Od vydání je podporováno také dotrénování pomocí TRL. Příklad Hugging Face využívá variantu FP8 na uzlu s osmi GPU B300 a učí model uvažovat v jazyce určeném systémovým promptem.