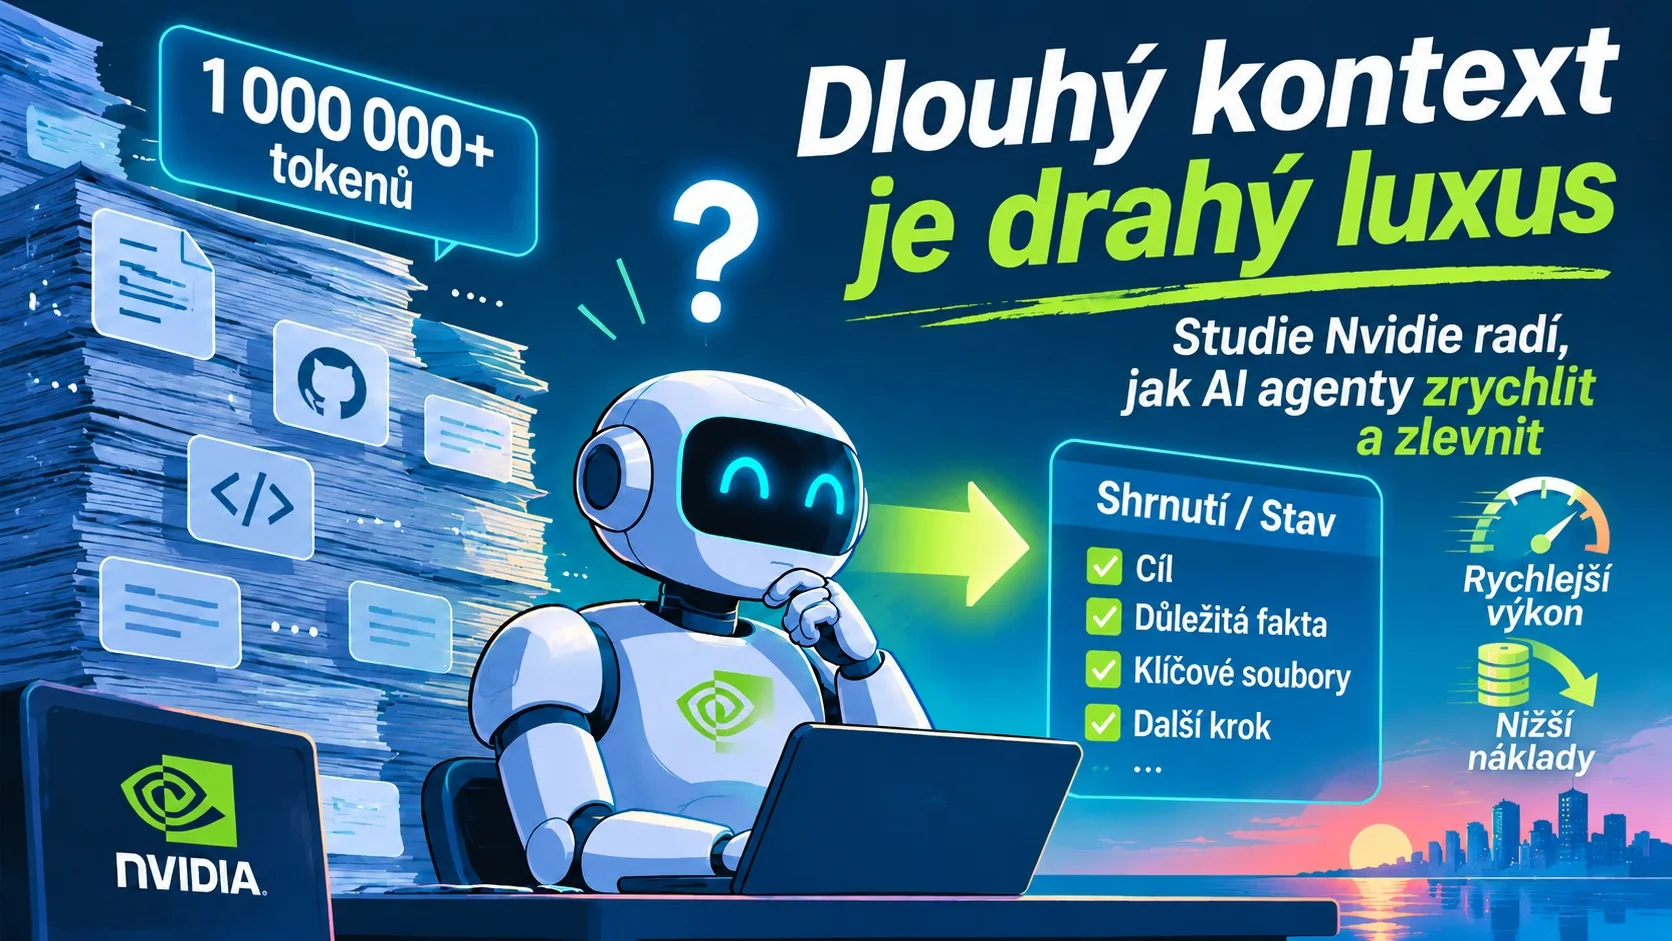
Největší jazykové modely dokážou najednou pojmout více textu, než má Tolkienův Pán prstenů nebo Tolstého Vojna a mír. GPT 5.6 Sol zvládne přes milion tokenů, tedy zhruba 790 tisíc anglických slov. Dvanáct výzkumníků z Nvidie si ale položilo nepříjemnou otázku, zda modely takto obří paměť vůbec potřebují. Jejich odpověď zní ve většině případů ne. Studie s výmluvným názvem You don’t need long context ukazuje, že AI agenti zvládnou i náročné úkoly s výrazně kratším kontextem, přičemž často dopadnou stejně dobře, nebo dokonce lépe.
Čím delší paměť, tím pomalejší model
Každý nový token, který model vygeneruje, musí brát ohled na všechno, co mu předcházelo. Čím více textu se v konverzaci nahromadí, tím více výpočtů a paměti stojí každé další slovo. U AI agentů je to obzvlášť znát. Agent při programování prohledává repozitáře, upravuje soubory a spouští testy, a každý takový krok se přidá do další žádosti pro model. Historie roste, i když většina z ní už dávno není k ničemu.
Výzkumníci to změřili na třech modelech s otevřenými vahami na grafických kartách Nvidia H100. Když zmenšili kontextové okno z 256 tisíc na 16 tisíc tokenů, model GLM 5.2 vygeneroval za stejný čas zhruba 3,6krát více tokenů, Kimi K2.6 přibližně 5,6krát více a Qwen 3 Coder Next dokonce sedmkrát více. Na menším zařízení DGX Spark byla u několika modelů doba generování s dlouhým kontextem zhruba dvojnásobná oproti krátkému. Autoři upozorňují, že běžní uživatelé tyto rozdíly nevidí, protože poskytovatelé účtují pevnou cenu za milion tokenů bez ohledu na délku konverzace.
Agent si nemusí pamatovat všechno
Tým otestoval 13 benchmarků, mezi nimi SWE-bench Verified s reálnými chybami z GitHubu, Terminal-Bench nebo LongBench v2. Hlavní pokusy běžely na modelech Claude Opus 4.5 a GPT 5.6 Sol. Výchozí varianta si pamatovala celou konverzaci. Ta upravená ji ve chvíli, kdy dosáhla nastaveného limitu, třeba 12 tisíc tokenů, nechala modelem stručně shrnout a začala novou konverzaci jen s původním zadáním a tímto shrnutím.
Výsledky překvapily. Na SWE-bench Verified vyřešil Claude Opus 4.5 s plnou historií 70 procent úloh, s pravidelným zkracováním v nejlepším nastavení skoro 75 procent. GPT 5.6 Sol si polepšil z 84,4 na 88,8 procenta. Napříč dlouhými agentními úlohami se přesnost většinou pohybovala jen pár procentních bodů nad nebo pod výchozí úrovní, zatímco odhadované náklady klesly zhruba dvakrát až devětkrát.
Hodně záleží na tom, jak shrnutí vypadá. Výzkumníci zjistili, že obyčejné shrnutí často zachová špatné informace. Převypráví výrazné události z historie agenta, i když už nehrají roli. Mnohem lépe fungovalo něco jako předávací porada. Model v ní zapíše původní cíl, ověřená fakta, důležité soubory a výsledky, provedené změny, slepé uličky, které nemá cenu opakovat, zbývající práci a hned další krok.
Stačí vědět, kam se podívat
U úloh s obrovskými dokumenty zvolili autoři jiný přístup. Místo toho, aby celé texty vložili do zadání, uložili je jako soubory. Agent v nich hledal běžnými příkazy jako grep a do své paměti si přenesl jen pasáže, které opravdu potřeboval. Tato metoda se vyrovnala klasickému postupu nebo ho překonala téměř ve všech sedmi testech s dlouhými vstupy. V testu hledání jehly v kupce sena vystoupaly oba modely na stoprocentní úspěšnost. Claude Opus 4.5 si v úloze AA-LCR, kde musí uvažovat napříč několika reálnými dokumenty, polepšil z 65 na 84 procent. Agenti přitom často dokončil práci, aniž by jedinkrát potřebovali paměť zkracovat. Hlavní přínos tedy nepřinášelo shrnování přečteného, ale chytrý výběr toho, co vůbec číst.
Pak tým zkusil extrém. Agent po každé jednotlivé akci přepsal popis stavu úkolu a předchozí konverzaci zahodil. Další krok tak začínal jen se zadáním a tímto aktuálním popisem. I tak se oba modely na SWE-bench Verified téměř vyrovnaly variantě s plnou historií. Medián nejdelší konverzace přitom klesl na pouhých 7 až 9 tisíc tokenů a maximum se snížilo z rozmezí 130 až 200 tisíc na 15 až 37 tisíc.
Z toho výzkumníci vyvodili nápad na takzvané sémantické stavové modely. Ty by se učily předávat si mezi kroky srozumitelný textový popis stavu úkolu, který si může přečíst i člověk, místo nečitelných čísel uvnitř neuronové sítě. Podle autorů není důvod, proč by takové modely nemohly dosahovat stejných výsledků jako ty, které uchovávají celou historii.
Ne každý model to zvládne
Studie má ovšem svá úskalí. Modely na zkracování paměti reagují velmi rozdílně. Qwen 3 Coder Next klesl na SWE-bench Verified při limitu 16 tisíc tokenů z 53 procent na necelá 4 procenta. Na vině byly jeho upovídané výstupy, které mezi jednotlivými shrnutími nenechaly prostor pro skutečnou práci. Qwen 3.6 27B nebo MiniMax M2.7 si naopak vedly mnohem lépe a ztratily jen málo. Vývojáři by si proto podle autorů měli vše vyzkoušet na vlastních úlohách a různých limitech, místo toho, aby slepě věřili jednomu nastavení.
Nepříjemné překvapení může čekat i u výdajů za cloudové modely. Poskytovatelé nabízejí slevu, když po sobě jdoucí žádosti sdílejí stejný začátek a model může znovu využít dřívější výpočty. Zkrácení paměti ale tento začátek změní a slevu zruší. Při běžných cenách za tokeny tak náklady GPT 5.6 Sol na SWE-bench Verified paradoxně vzrostly zhruba ze 168 na 203 dolarů, přestože model zpracovával kratší konverzace. Úspory, které studie vyčísluje, počítají s tím, že by poskytovatelé za kratší kontext účtovali méně, což zatím běžná praxe není.
Autoři přiznávají i další hranici. Shrnutí vždy něco ztratí, a u úloh, kde záleží na každém detailu, jako jsou přesné záznamy nebo auditní stopy, se na ně spoléhat nevyplatí. Původní data proto doporučují uchovat stranou, aby si je agent mohl kdykoli dohledat. Svou tezi nakonec opírají o Alana Turinga, který už ve třicátých letech minulého století vycházel z toho, že vše vypočitatelné lze spočítat, i když se člověk dívá jen na omezenou část vstupu a v hlavě drží jen konečný stav.
Zdroje: arxiv.org a cryptobriefing.com