Stejná otázka, stejný model a stejný počítač. Přesto se spotřeba energie liší až stonásobně podle toho, v jakém jazyce se uživatel ptá. K tomuto závěru došli výzkumníci z Michiganské univerzity, kteří spolu s kolegy z Aberdeenu a Cambridge poprvé důkladně změřili, kolik elektřiny jazykové modely spotřebují při odpovídání ve 122 jazycích. Výsledek je nepříjemný, protože angličtina vychází nejlevněji, zatímco jazyky jako paštština nebo tibetština stojí řádově více energie a model v nich zároveň odpovídá výrazně hůře.
Proč se do měření pustili
Jazykové modely neboli programy typu ChatGPT dnes používají lidé po celém světě v desítkách jazyků. Když vývojáři zkoumají, jak dobře model zvládá různé jazyky, sledují téměř výhradně přesnost odpovědí. Kolik energie přitom model spotřebuje, zatím nikoho příliš nezajímalo.
Starší práce již ukázaly, že méně rozšířené jazyky potřebují k vyjádření stejné myšlenky více takzvaných tokenů. Token je malý kousek textu, se kterým model pracuje, například celé slovo, slabika nebo jen jeden znak. Čím více tokenů systém zpracovává, tím více výpočtů musí provést. Nikdo ale dosud neměřil skutečnou spotřebu přímo na hardwaru. Autoři proto chtěli zjistit, zda jazyk dotazu soustavně ovlivňuje energetickou náročnost odpovědi a o kolik. Pokud ano, hrozí, že firmy provozující umělou inteligenci začnou z čistě ekonomických důvodů méně rozšířené jazyky odsouvat na vedlejší kolej.
Výzkumníci použili čtenářský test Belebele, který obsahuje stejné texty a otázky přeložené do 122 jazyků. V každém jazyce zadali modelu Qwen3 s osmi miliardami parametrů 900 otázek a přesně změřili spotřebu energie grafické karty. Všechny jazyky přitom běžely za naprosto stejných podmínek. Pro kontrolu pak měření zopakovali s dalšími modely od společností Google a Meta, na dvou typech grafických karet, s různým počtem současně zpracovávaných dotazů a u tří odlišných úloh od porozumění textu přes slovní úlohy z matematiky až po běžný chat.
Angličtina za haléř, paštština za korunu
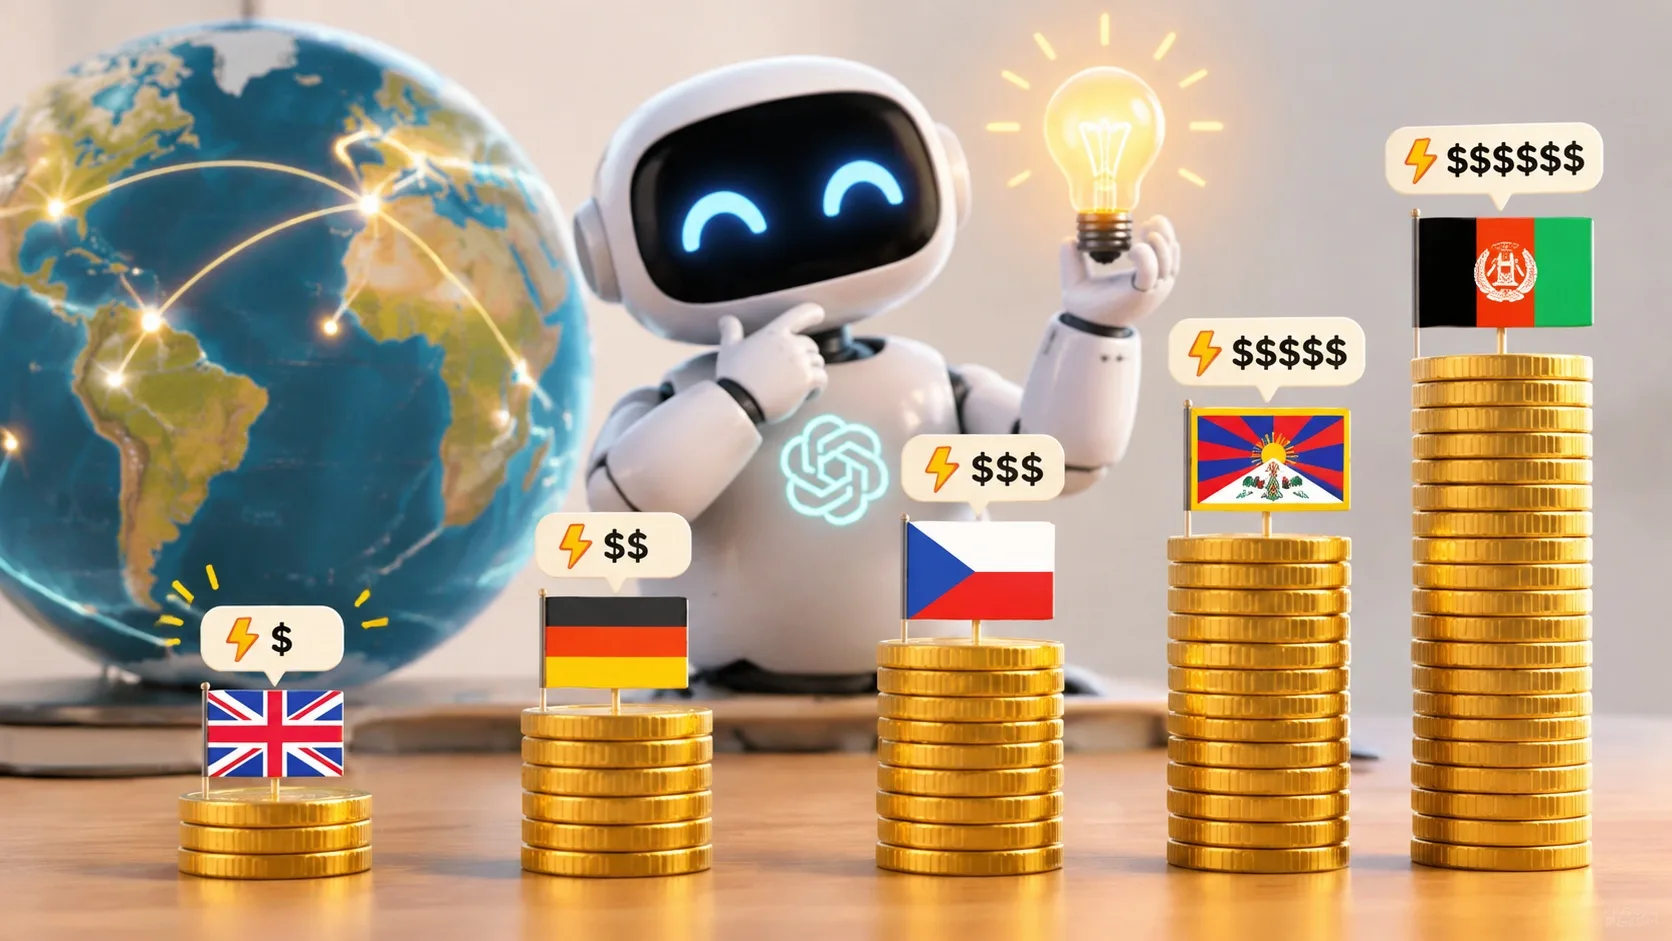
Rozdíly překvapily i samotné autory. Jedna odpověď v angličtině spotřebovala v průměru zhruba 20 joulů. Joule je základní jednotka energie a pro představu stačí vědět, že tisíc joulů tvoří kilojoule. Stejná odpověď v paštštině, kterou mluví lidé hlavně v Afghánistánu a Pákistánu, vyšla na zhruba 3 500 joulů. Za celou sadu 900 otázek pak angličtina spotřebovala necelých 18 kilojoulů, zatímco paštština přes 3 100 kilojoulů, což představuje 179násobný rozdíl.
Těsně za paštštinou skončila tibetština, šanština z Myanmaru a tigriňa, kterou se mluví v Eritreji a Etiopii. Problém se však netýká jen méně rozšířených jazyků. Hindština vyžaduje zhruba osmkrát a bengálština asi patnáctkrát více energie než stejný dotaz v angličtině, přestože každou z nich mluví stovky milionů lidí. Výzkumníci spočítali, že přibližně 5,2 miliardy lidí musí na text ve svém mateřském jazyce vynaložit více než dvojnásobek energie oproti mluvčím angličtiny. Většina západoevropských jazyků se pohybovala na dvojnásobku angličtiny nebo níže.
Čeština dopadla relativně slušně. Model v ní spotřeboval zhruba čtyřikrát víc energie než v angličtině a správně odpověděl na 89 procent otázek. Němčina si vedla ještě o něco lépe, energie spotřebovala zhruba dvakrát víc než angličtina a úspěšnost měla 92 procent. Angličtina měla úspěšnost téměř 95 procent.
Měření odhalilo ještě další nepříjemnou skutečnost. Jazyky, které stojí nejvíce energie, model zároveň zvládá nejhůře. V tibetštině, paštštině, tigriňi, šanštině a amharštině trefil nanejvýš 43 procent odpovědí, v šanštině dokonce jen necelých 11 procent. Mluvčí těchto jazyků tak doplácejí dvakrát, protože odpověď je dražší a často nesprávná.
Kde se ztrácí energie
Rozdíl má podle autorů dvě příčiny, které se navzájem násobí. První je počet tokenů. Model trénovaný hlavně na anglických textech umí anglická slova rozkládat úsporně, takže jedno slovo často odpovídá jednomu tokenu. U písem jako tibetské, etiopské nebo barmské se ale slovo rozpadne na mnoho drobných kousků. V tibetštině připadalo na jeden token v průměru méně než jedno písmeno, v angličtině skoro pět. U čtyř nejdražších jazyků model vytvořil dvacetkrát až pětadvacetkrát více tokenů než v angličtině.
Druhou příčinou je energie na jeden token, která se mezi jazyky lišila až osminásobně. Dlouhé odpovědi totiž zabírají více paměti grafické karty. Server pak nedokáže zpracovávat tolik dotazů najednou, výkon karty zůstává nevyužitý a každý token vyjde dráže.
Výzkumníci se podívali i na to, co model v problematických jazycích vlastně psal. V tigriňi zopakoval stejnou větu pětačtyřicetkrát za sebou, jako by se zasekl ve smyčce. V lotyštině odpovídal správně, ale rozvláčně a vygeneroval více než trojnásobek tokenů oproti angličtině. V khmerštině zase přeskočil do angličtiny a odpověděl v úplně jiném jazyce, než ve kterém dostal otázku.
Výjimky ukazují, že nejde jen o složitost písma. Zjednodušená čínština používá úplně jiné znaky než latinku, a přesto vyšla energeticky stejně jako angličtina, protože model viděl při tréninku obrovské množství čínských textů. Podobně dopadla egyptská arabština. Patří sice mezi méně zastoupené jazyky, sdílí ale písmo se spisovnou arabštinou, kterou model zná dobře, a tak skončila mezi pěti nejlevnějšími.
Propast se neztrácela ani u větších modelů. U Qwen3 se 14 miliardami parametrů se poměr mezi nejlevnějším a nejdražším jazykem dokonce zvětšil na dvanáctinásobek. Nejlevnější byla vždy angličtina nebo čínština, nejdražší tibetština nebo šanština a obě skupiny jazyků se nikdy nepřekrývaly. Stejné to bylo na obou grafických kartách i u všech tří úloh.
Co navrhují výzkumníci
Výzkumníci chtějí, aby se spotřeba energie stala běžnou součástí hodnocení modelů, stejně jako přesnost odpovědí. Vývojáři by podle nich měli u každého modelu uvádět, kolik energie spotřebuje v jednotlivých jazycích. Model, který v angličtině trefí 95 procent odpovědí za pár haléřů a v tibetštině 22 procent za mnohonásobek, představuje podle autorů ve skutečnosti dva úplně odlišné produkty pro dvě skupiny lidí.
Navrhují i praktická řešení. Systém by mohl poznat jazyk dotazu a podle toho omezit maximální délku odpovědi, aby se model nezacyklil. Dotazy v méně rozšířených jazycích by mohl posílat menším modelům specializovaným právě na ně. Další možností je přeložit otázku do angličtiny, nechat model odpovědět a výsledek přeložit zpět. Podle dřívějších výzkumů to u méně rozšířených jazyků může zlepšit i přesnost. Autoři ale upozorňují, že u textů plných kulturních narážek, idiomů nebo místních zvyklostí může překlad znít plynule, a přesto minout smysl.
Autoři si uvědomují, že jejich zjištění může mít i odvrácenou stranu. Firmy by je mohly použít jako výmluvu, proč méně rozšířené jazyky omezit nebo z nabídky úplně vyřadit. Mlčet o problému je podle nich ale horší, protože by se to dělo potichu a bez kontroly. Účet za elektřinu, vodu a emise totiž nakonec platí všichni, zatímco nejhorší služby dostávají mluvčí opomíjených jazyků.
Studie má i své meze. Testy proběhly jen na dvou typech grafických karet od Nvidie a výzkumníci neměli přístup ke komerčním modelům jako GPT, Gemini nebo Claude, které obsluhují velkou část vícejazyčných dotazů na světě. Otázky byly strojově přeložené, ne napsané rodilými mluvčími. Skutečné dotazy lidí bývají chaotičtější, a proto autoři považují naměřené rozdíly spíše za spodní hranici toho, co se ve skutečnosti děje.
Zdroj: aclanthology.org