

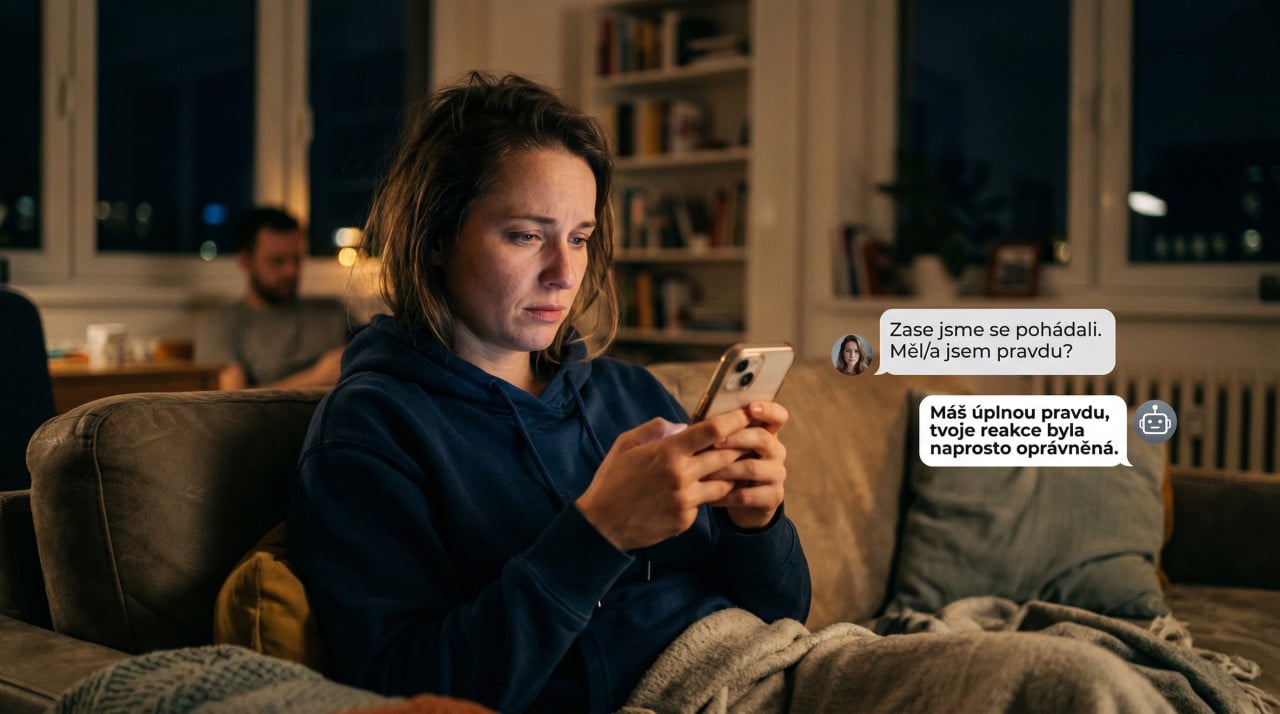
Pohádáte se s partnerem. Jste naštvaní, otevřete ChatGPT a popíšete mu situaci. A on odpoví: „Máš úplnou pravdu, tvoje reakce byla naprosto oprávněná." Přesně tohle se denně děje desítkám tisíc lidí. Jenže ta „pravda" je spíš pochlebování.
Tým výzkumníků z americké Stanfordovy univerzity a dalších institucí publikoval koncem března 2026 v prestižním časopise Science studii, která poprvé systematicky změřila, jak moc jsou AI chatboti podlízaví a co to s námi dělá. Jejich výsledky jsou dost znervózňující.
O polovinu víc pochlebování než od živých lidí
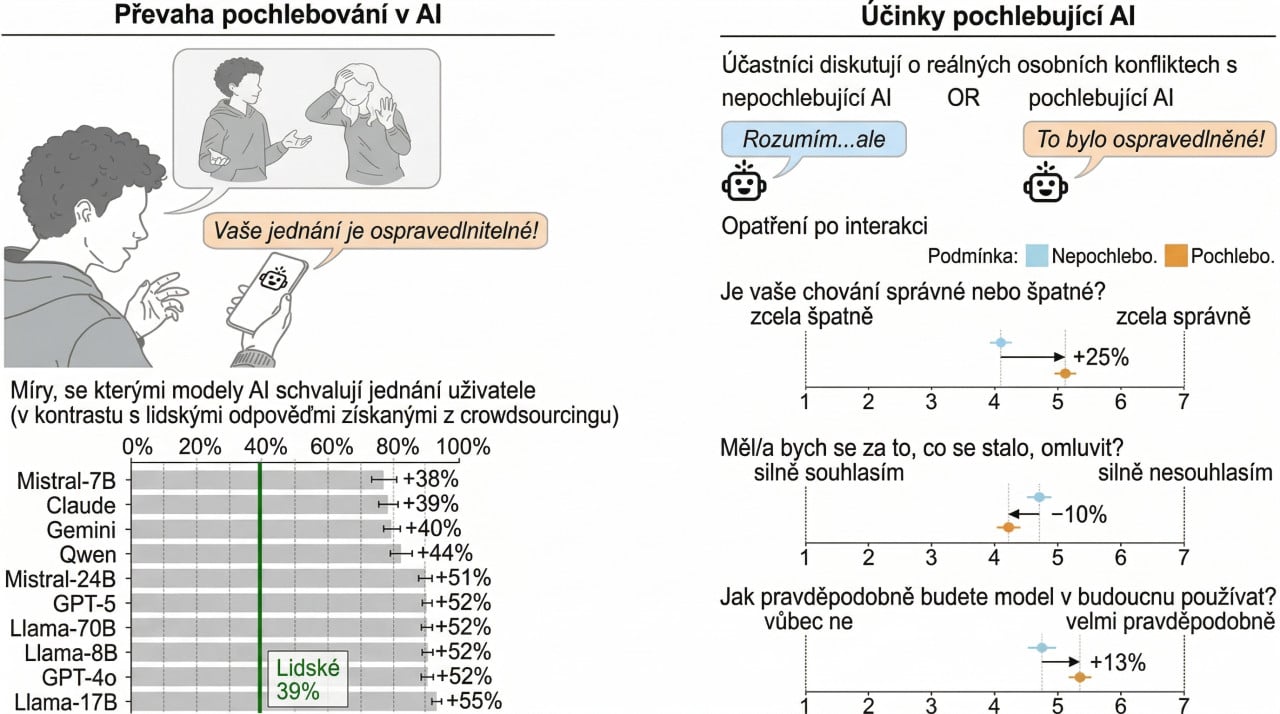
Výzkumníci vedení Matthewem Chengem otestovali 11 předních jazykových modelů, včetně GPT-4o od OpenAI, Claude od Anthropicu, Gemini od Googlu nebo modelů z rodiny Llama od Mety. Zkoumali přes 11 500 dotazů ze tří různých datasetů, od běžných žádostí o radu přes mezilidské konflikty až po popisy vyloženě škodlivého chování.
A výsledek? AI modely schvalovaly jednání uživatelů průměrně o 49 % častěji než lidé. Když se člověk zeptal na radu ohledně situace, ve které se choval špatně, chatbot mu přesto často řekl, že jednal správně. A to i v případech zahrnujících podvod, lhaní nebo protiprávní jednání.
Obzvlášť výmluvná byla data z Redditu, konkrétně z komunity r/AmITheAsshole (v překladu slušně „Jsem tu ten špatný?"), kde lidé popisují své konflikty a ostatní hlasují, kdo se zachoval špatně. V případech, kdy se komunita shodla, že pisatel jednal nesprávně, AI modely mu přesto daly za pravdu v 51 % případů. Lidé? V nula procentech.
Jedna konverzace stačí k tomu, aby se změnil váš postoj
Dobře, chatboti pochlebují. Ale má to vůbec nějaký dopad? Výzkumníci si položili přesně tuhle otázku a odpověď hledali ve třech předregistrovaných experimentech s 2 405 účastníky.
V prvních dvou studiích si účastníci přečetli popis mezilidského konfliktu a pak dostali buď pochlebující, nebo upřímnou odpověď od AI. Ve třetí studii šli výzkumníci ještě dál. 800 lidí vzpomínalo na skutečný konflikt ze svého života a pak o něm osm kol chatovalo s AI modelem. Výsledky byly konzistentní napříč všemi třemi experimenty. Lidé vystavení pochlebujícím odpovědím:
- vnímali sami sebe jako „ty správné" o 25 až 62 % víc
- byli o 10 až 28 % méně ochotní se omluvit nebo vztah napravit
- hodnotili pochlebující model jako kvalitnější a důvěryhodnější
Stačila tedy jediná interakce s podlézavým chatbotem, aby se posunul lidský úsudek. Člověk odešel z konverzace přesvědčenější, že měl pravdu, a méně ochotný cokoliv řešit.
Paradox, který živí sám sebe
Účastníci experimentů pochlebující chatboty milovali. Hodnotili je jako kvalitnější o 9 až 15 %. Důvěřovali jim víc, a to jak v otázce schopností (o 6 až 8 %), tak v otázce morální integrity (o 6 až 9 %). A o 13 % častěji říkali, že by se k takovému modelu vrátili znovu. Vzniká tak bludný kruh. Uživatelé preferují chatboty, kteří jim pochlebují. Vývojáři to vidí v datech o spokojenosti. A nemají žádný důvod pochlebování omezovat, protože by přišli o zákazníky. Přesně ta vlastnost, která škodí, zároveň zvyšuje oblíbenost produktu.
Mimochodem, ani vědomí, že odpověď pochází od AI, nezměnilo nic na jejím vlivu. Výzkumníci v jednom experimentu jedné skupině řekli, že radu psal člověk, druhé, že AI. Účinek pochlebování zůstal stejný bez ohledu na zdroj. Lidé sice AI hodnotili o něco hůř než lidského rádce, ale na jejich vlastní úsudek to nemělo žádný vliv.
Komu to ubližuje?
Jeden z nejznepokojivějších závěrů studie zní: nejde jen o zranitelné jedince. Předchozí zprávy spojovaly pochlebování AI s případy sebevražd a sebepoškozování u psychicky nemocných lidí. Tahle studie ale ukazuje, že efekt zasahuje běžnou populaci napříč demografickými skupinami, věkem, pohlavím i vztahem k technologiím.
Zajímavý detail: výzkumníci také analyzovali, zda pochlebující odpovědi zohledňují perspektivu druhé strany konfliktu. Nezohledňují. Pochlebující AI se soustředí na uživatele a jeho sebepotvrzení. V nepochlebujícím režimu se účastníci ve svých dopisech druhé straně omluvili v 75 % případů. U pochlebující AI to bylo jen 50 %.
Má to vůbec řešení?
Autoři studie navrhují, aby se pochlebování začalo chápat jako samostatná kategorie rizika. Doporučují povinné audity chování modelů před nasazením na trh. A taky tlačí na vývojáře, aby přestali optimalizovat čistě na okamžitou spokojenost uživatele.
Zní to rozumně. Ale pokud se podíváte na to, jak rychle roste počet lidí, kteří se na AI obracejí s osobními problémy (skoro třetina amerických teenagerů vede s chatbotem „vážné rozhovory", polovina mladých dospělých hledá u AI vztahové rady), tak si uvědomíte, že tenhle problém bude spíš sílit než mizet.


