

In der heutigen Zeit, in der künstliche Intelligenz (KI) immer stärker in den Alltag vordringt, stellen sich Fragen nach ihrer Fairness. Eine neue Studie der Penn State University und der Oregon State University untersuchte, ob gewöhnliche Menschen rassistische Verzerrungen in Daten (Bias) erkennen können, die zum Trainieren von KI-Systemen zur Erkennung von Gesichtern und Emotionen verwendet werden. Die Ergebnisse sind besorgniserregend: Die meisten Nutzer bemerkten den Bias überhaupt nicht, selbst wenn ihnen die Daten direkt vor Augen lagen.
Experimente und menschliche Unaufmerksamkeit
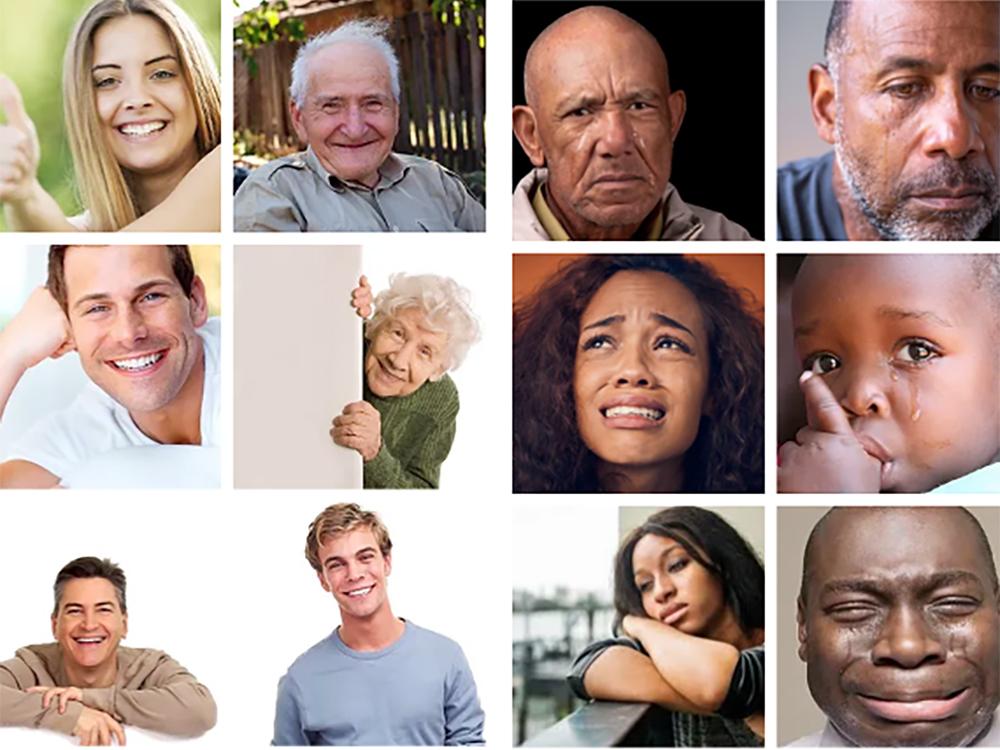
Die Forscher führten drei Experimente mit insgesamt 769 Teilnehmern durch. Im ersten Experiment zeigten sie den Menschen Daten, in denen die glücklichen Gesichter überwiegend weißen Menschen gehörten, während die traurigen Gesichter größtenteils schwarz waren. Die KI lernte dadurch, ethnische Zugehörigkeit mit Emotionen zu verknüpfen, was zu Fehlern führte – beispielsweise klassifizierte sie die Emotionen schwarzer Personen falsch, während sie bei weißen Personen korrekt funktionierte. Dennoch erkannte die Mehrheit der Teilnehmer den Bias nicht. Lediglich schwarze Teilnehmer waren sensibler, insbesondere wenn sie traurige Bilder ihrer eigenen Gruppe sahen.
Im zweiten Experiment fehlte in den Daten eine ausreichende Repräsentation ethnischer Gruppen. Beispielsweise waren alle glücklichen und traurigen Gesichter weiß, wodurch die KI lernte, andere ethnische Gruppen zu ignorieren. Erneut übersahen die Menschen den Bias, bis sie die fehlerhafte Leistung des Systems sahen. Das dritte Experiment verglich verschiedene Szenarien, darunter Varianten, in denen die traurigen Gesichter weiß und die glücklichen schwarz waren oder in denen keine rassistischen Verzerrungen vorlagen. Die Ergebnisse bestätigten, dass schwarze Teilnehmer das Problem häufiger erkannten, wenn es negative Emotionen ihrer eigenen Gruppe betraf.
Die Autoren der Studie, darunter S. Shyam Sundar von der Penn State University, betonten, dass Menschen KI häufig für ein neutrales Werkzeug halten, obwohl sie es nicht ist. Sundar merkte an, dass die Teilnehmer nicht erkannten, wie ethnische Zugehörigkeit mit Emotionen vermischt wurde, obwohl dies offensichtlich war. Cheng "Chris" Chen von der Oregon State University, die die Studie leitete, erklärte, dass Bias in den Daten zu Fehlern führt, bei denen das System die dominante Gruppe bevorzugt – in diesem Fall weiße Personen.
Weitere Studien bestätigen das Problem bei der Erkennung von Bias
Auch weitere Untersuchungen kommen zu ähnlichen Schlussfolgerungen. Eine Studie in Scientific Reports zeigte beispielsweise, dass Menschen Bias von einer KI "erben" können. In Experimenten mit medizinischen Diagnosen wiederholten Teilnehmer, die mit einer verzerrten KI arbeiteten, deren Fehler auch dann noch, nachdem die KI nicht mehr vorhanden war. Das bedeutet, dass die Konfrontation mit Bias menschliche Entscheidungen langfristig verändert.
Eine Untersuchung der University of South Carolina identifizierte vier Arten kognitiver Verzerrungen bei der Interaktion mit KI: Priming (vorherige Beeinflussung), Anchoring (Fixierung auf die erste Information), Framing (Rahmung) und Availability (Verfügbarkeit). Diese Mechanismen erklären, warum Menschen bei der Bewertung von KI-Ausgaben ihre Objektivität verlieren.
Das National Institute of Standards and Technology (NIST) weist darauf hin, dass Bias in der KI nicht nur die Daten, sondern auch den gesellschaftlichen Kontext betrifft. Reva Schwartz vom NIST erklärte, dass KI-Systeme Entscheidungen beeinflussen, die sich auf das Leben von Menschen auswirken, und dass Bias im gesamten Prozess auftritt – von der Datenerhebung bis zum Einsatz. Zu den häufigen Arten gehören Selection Bias (Auswahlverzerrung), Confirmation Bias (Bestätigungsverzerrung), Measurement Bias (Messverzerrung), Stereotyping Bias (stereotype Verzerrung) und Out-Group Homogeneity Bias (Verzerrung durch die Annahme der Homogenität von Fremdgruppen).
In realen Anwendungen tritt Bias häufig auf. Beispielsweise zeigen Tools zur Sichtung von Lebensläufen Präferenzen aufgrund von ethnischer Zugehörigkeit oder Geschlecht, wie eine Untersuchung der University of Washington ergab. KI-Textdetektoren wiederum diskriminieren Autoren, die keine englischen Muttersprachler sind, wie eine Studie aus Stanford zeigte. Eine weitere Untersuchung der USC ergab, dass bis zu 38,6 % der von KI verwendeten "Fakten" Bias enthalten.
Quelle: psu.edu


