

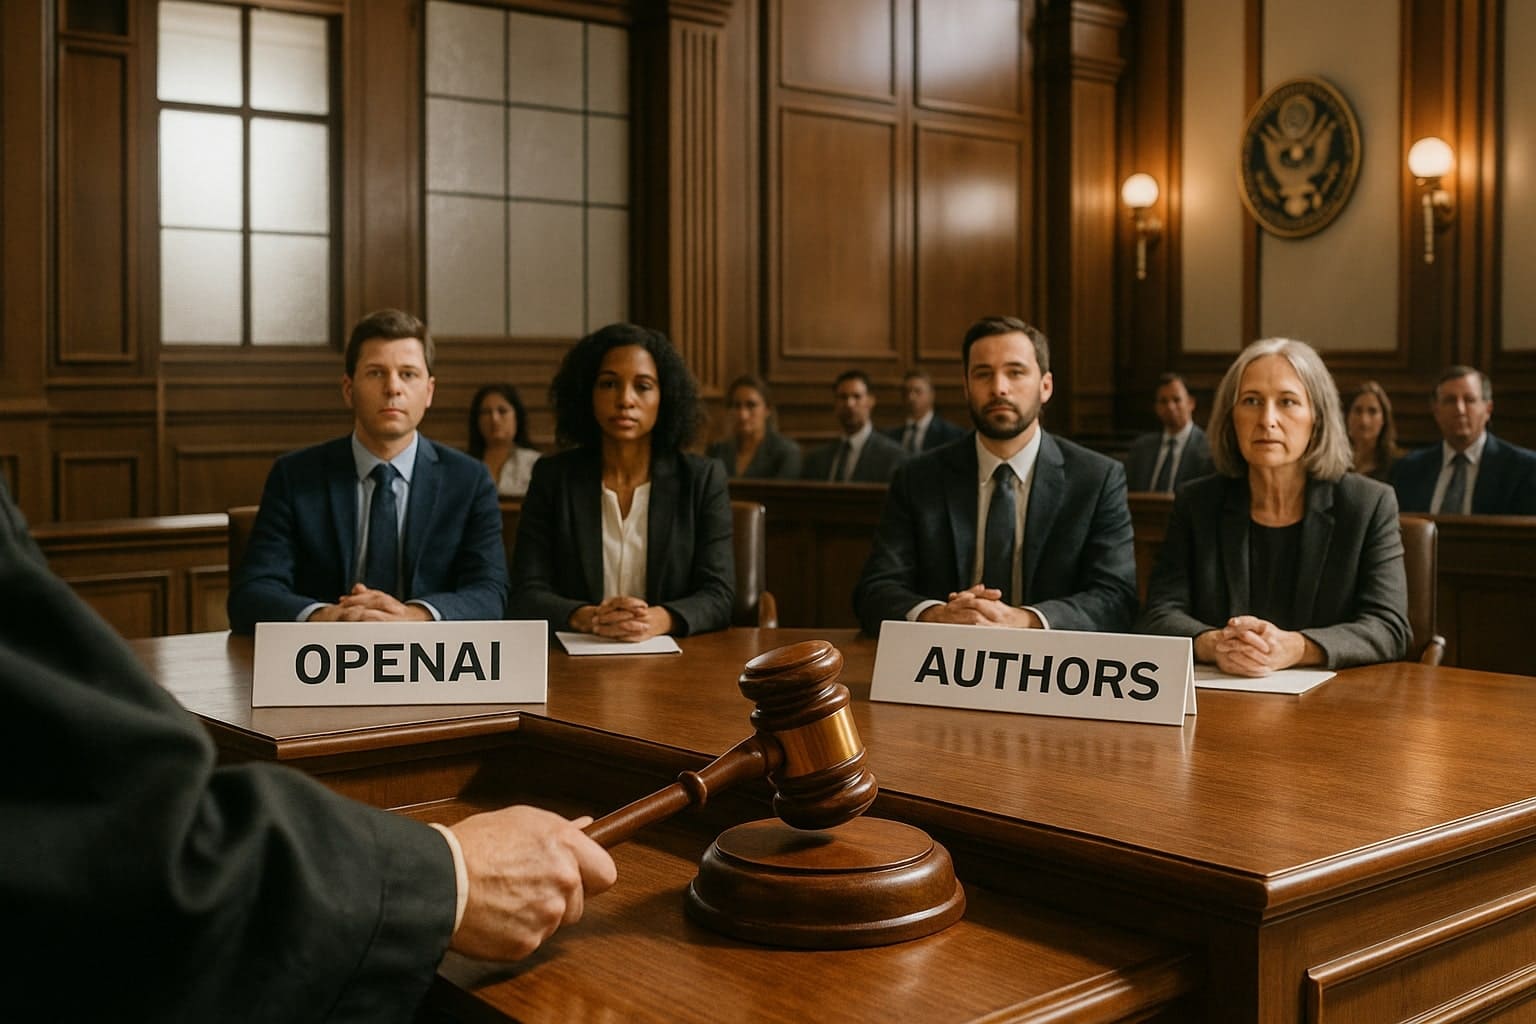
OpenAI steckt in gewaltigen Schwierigkeiten. Im Mittelpunkt steht eine Sammelklage von Buchautoren, die behaupten, ihre Werke seien illegal zum Training künstlicher Intelligenz verwendet worden. Der entscheidende Punkt? OpenAI löschte noch vor dem Start von ChatGPT im Jahr 2022 zwei Datensätze voller raubkopierter Bücher namens Books1 und Books2. Diese Datensätze wurden 2021 von ehemaligen OpenAI-Mitarbeitern erstellt, indem sie das offene Web durchsuchten und den Großteil der Daten aus der sogenannten Schattenbibliothek Library Genesis, kurz LibGen, stahlen. OpenAI behauptet, die Datensätze noch im selben Jahr nicht mehr verwendet und intern beschlossen zu haben, sie zu löschen. Doch die Autoren vermuten, dass mehr dahintersteckt, und nun sieht es so aus, als würde das Gericht ihnen recht geben.
Vergangene Woche entschied die US-Richterin Ona Wang, dass OpenAI sämtliche interne Kommunikation mit den Anwälten des Unternehmens über die Löschung dieser Datensätze offenlegen muss. Darüber hinaus muss das Unternehmen alle internen Erwähnungen von LibGen herausgeben, die OpenAI unter Berufung auf das Anwaltsgeheimnis zurückgehalten hatte. Wang ordnete an, dass OpenAI diese Unterlagen bis zum 8. Dezember übergeben und seine internen Anwälte bis zum 19. Dezember für eine Befragung zur Verfügung stellen muss. Warum diese Entscheidung? Laut der Richterin verhielt sich OpenAI unangemessen – zunächst behauptete das Unternehmen, die „Nichtnutzung“ der Datensätze sei der Grund für deren Löschung gewesen, dann nahm es diese Aussage zurück und erklärte plötzlich sämtliche Gründe für vertraulich. Wang bezeichnete dies als „Schwanken“ und erklärte, OpenAI könne seine Positionen nicht auf diese Weise ändern, um einer Überprüfung zu entgehen.
OpenAI und seine Geheimnisse?
Die klagenden Autoren verdächtigen OpenAI einer vorsätzlichen Urheberrechtsverletzung. Sollte sich herausstellen, dass das Unternehmen von den Risiken wusste und die Datensätze dennoch verwendete, könnte dies enorme Geldstrafen nach sich ziehen. Bei einer vorsätzlichen Verletzung kann das Gericht den Schadenersatz auf bis zu 150.000 Dollar pro verletztem Werk erhöhen, was umgerechnet etwa 3.450.000 CZK entspricht. OpenAI verteidigt sich mit dem Argument, dass sämtliche Gründe für die Löschung durch das Anwaltsgeheimnis geschützt seien, da interne Anwälte an der Entscheidung beteiligt gewesen seien. Das Unternehmen hatte sogar einen Slack-Kanal, der ursprünglich „excise-libgen“ hieß, was so viel wie „LibGen entfernen“ bedeutet. Einer der Anwälte, Jason Kwon, schlug vor, den Namen in „project-clear“ zu ändern, damit er weniger verdächtig wirke.
Richterin Wang prüfte jedoch die Slack-Nachrichten und stellte fest, dass die meisten davon überhaupt nicht vertraulich waren – es handelte sich nicht um Rechtsberatung, sondern lediglich um gewöhnliche Diskussionen. Ihrer Ansicht nach kann OpenAI nicht den gesamten Kanal für geheim erklären, nur weil darin ein Anwalt erwähnt wurde. Die Autoren hoffen, dass diese Nachrichten offenlegen werden, ob OpenAI die Datensätze aus Angst vor rechtlichen Problemen löschte oder ob es sie möglicherweise unter anderen Namen weiterhin verwendet. Einer der Anwälte der Autoren, Christopher Young, deutete in einem Gerichtsschriftsatz an, dass es das Unternehmen schwer belasten könnte, wenn sich herausstellt, dass OpenAI aufgrund rechtlicher Risiken beschlossen hatte, die Datensätze nicht für neuere Modelle zu verwenden.
Richterin kritisiert OpenAI wegen verzerrter Darstellung
Wang zeigte sich außerdem verärgert darüber, wie OpenAI eine Entscheidung in einem anderen Fall mit dem Unternehmen Anthropic falsch dargestellt hatte. OpenAI behauptete, Richter William Alsup habe erklärt, das Herunterladen raubkopierter Bücher sei legal, wenn diese anschließend zum Training von KI verwendet würden. Doch das ist Unsinn – Alsup schrieb tatsächlich, eine solche Piraterie sei „im Grunde unentschuldbar“ und kein Beklagter könne erklären, warum er die Bücher nicht auf legalem Wege heruntergeladen habe. Wang bezeichnete dies als „bizarre“ und „grobe“ Falschdarstellung und betonte, dass OpenAI mit seinem Verhalten genau in die von Alsup kritisierte Kategorie falle: Datenpiraterie und anschließende Löschung der Daten.
Dieser Streit könnte den gesamten Fall beeinflussen. Die Autoren wollen auch Dario Amodei, den Chef von Anthropic, befragen, der diese Datensätze angeblich erstellt hatte, als er noch bei OpenAI arbeitete. Das Gericht entschied im März, dass Amodei Fragen zu seiner Rolle bei der Löschung beantworten muss. OpenAI wehrte sich dagegen, verlor jedoch. Das Unternehmen erklärt nun, mit der Entscheidung von Richterin Wang nicht einverstanden zu sein und Berufung einlegen zu wollen.
Bei OpenAI zieht sich die Schlinge zu
OpenAI versuchte zu behaupten, in gutem Glauben gehandelt zu haben, entfernte dann jedoch Wörter wie „unschuldig“ oder „guter Glaube“ aus den Gerichtsdokumenten, was den Verdacht der Autoren nur verstärkte. Wang merkte an, dass die Geschworenen das Recht hätten, die Grundlage für OpenAIs angeblich guten Glauben zu erfahren. Dieser Fall erinnert an den jüngsten Vergleich mit Anthropic, bei dem die Autoren 1,5 Milliarden Dollar erhielten, umgerechnet etwa 34,5 Milliarden CZK. Dort tauchten Beweise dafür auf, dass Anthropic aus rechtlichen Gründen nicht mehr so begeistert davon war, Modelle mit raubkopierten Büchern zu trainieren. Die Autoren hoffen, ähnliche Beweise auch in den Nachrichten von OpenAI zu finden.
Die gesamte Situation wirft ein Schlaglicht darauf, wie Unternehmen wie OpenAI Daten für KI sammeln. OpenAI behauptet, keine Informationen verdreht zu haben, sondern lediglich unklare Formulierungen verwendet zu haben, die zu einem Missverständnis führten. Richterin Wang ließ dies jedoch nicht gelten und bezeichnete die geltend gemachte Vertraulichkeit als „an den Haaren herbeigezogen“. Nun liegt es an OpenAI, damit umzugehen, andernfalls riskiert das Unternehmen, den gesamten Fall aufgrund seiner eigenen Geheimniskrämerei zu verlieren.
Quelle: arstechnica.com


