

Microsoft AI erreicht bei der Diagnostik eine Erfolgsquote von 85 %, viermal besser als Ärzte
Das Microsoft-AI-Team hat bahnbrechende Forschungsergebnisse vorgestellt, die zeigen, wie künstliche Intelligenz schrittweise die komplexesten diagnostischen Herausforderungen der Medizin untersuchen und lösen kann – Fälle, mit denen selbst Experten Schwierigkeiten haben.
Revolutionäre Ergebnisse des Microsoft AI Diagnostic Orchestrator
Bei Tests mit realen Fällen aus der Praxis, die jede Woche im New England Journal of Medicine veröffentlicht werden, zeigte Microsoft AI, dass sein System Microsoft AI Diagnostic Orchestrator (MAI-DxO) bis zu 85 % der Fälle aus dem NEJM (New England Journal of Medicine) korrekt diagnostiziert, was einer mehr als viermal höheren Erfolgsquote als bei einer Gruppe erfahrener Ärzte entspricht. Darüber hinaus gelangte MAI-DxO kosteneffizienter zur richtigen Diagnose als die Ärzte.
Angesichts der steigenden Nachfrage nach Gesundheitsversorgung wachsen die Kosten in einem untragbaren Tempo, und Milliarden von Menschen sind mit zahlreichen Hindernissen auf dem Weg zu einer besseren Gesundheit konfrontiert – darunter ungenaue und verspätete Diagnosen. Menschen greifen für medizinische Beratung und Unterstützung zunehmend auf digitale Tools zurück. In den verbraucherorientierten Produkten von Microsoft AI wie Bing und Copilot verzeichnen wir täglich mehr als 50 Millionen gesundheitsbezogene Sitzungen.
Überwindung der Grenzen herkömmlicher Tests
Um in den Vereinigten Staaten als Arzt praktizieren zu dürfen, müssen Ärzte die United States Medical Licensing Examination (USMLE) bestehen, eine anspruchsvolle und standardisierte Bewertung klinischer Kenntnisse und Entscheidungsfindung. USMLE-Fragen gehörten zu den frühesten Benchmarks, die zur Bewertung von KI-Systemen in der Medizin eingesetzt wurden.
Innerhalb von nur drei Jahren hat sich die generative KI so weit entwickelt, dass sie beim USMLE und bei ähnlichen Prüfungen nahezu perfekte Ergebnisse erzielt. Diese Tests stützen sich jedoch hauptsächlich auf Multiple-Choice-Fragen, die das Auswendiglernen gegenüber einem tiefgreifenden Verständnis bevorzugen. Indem sie Medizin auf einmalige Antworten auf Multiple-Choice-Fragen reduzieren, überschätzen solche Benchmarks die vermeintliche Kompetenz von KI-Systemen und verschleiern deren Grenzen.
Sequential Diagnosis Benchmark (SD Bench)
Microsoft AI konzentrierte sich auf die sequenzielle Diagnostik, einen Grundpfeiler der medizinischen Entscheidungsfindung in der Praxis. Bei diesem Prozess beginnt ein Kliniker mit der anfänglichen Vorstellung des Patienten und wählt anschließend iterativ Fragen und diagnostische Tests aus, um zu einer endgültigen Diagnose zu gelangen.
Jede Woche veröffentlicht das New England Journal of Medicine (NEJM) – eine der weltweit führenden medizinischen Fachzeitschriften – den Case Record of the Massachusetts General Hospital, der den Behandlungsverlauf eines Patienten in einem detaillierten, narrativen Format darstellt. Diese Fälle gehören zu den diagnostisch komplexesten und intellektuell anspruchsvollsten der klinischen Medizin.
Microsoft AI erstellte interaktive Fallaufgaben auf Grundlage der NEJM-Fallreihe – den sogenannten Sequential Diagnosis Benchmark (SD Bench). Dieser Benchmark verwandelt 304 aktuelle NEJM-Fälle in schrittweise diagnostische Begegnungen, bei denen Modelle – oder menschliche Ärzte – iterativ Fragen stellen und Tests anordnen können.
Microsoft AI Diagnostic Orchestrator (MAI-DxO)
Microsoft AI entwickelte den Microsoft AI Diagnostic Orchestrator (MAI-DxO), ein System, das ein virtuelles Gremium von Ärzten mit unterschiedlichen diagnostischen Ansätzen nachbilden soll, die bei der Lösung diagnostischer Fälle zusammenarbeiten. Microsoft ist überzeugt, dass die Koordination mehrerer Sprachmodelle für die Steuerung komplexer klinischer Arbeitsabläufe entscheidend sein wird.
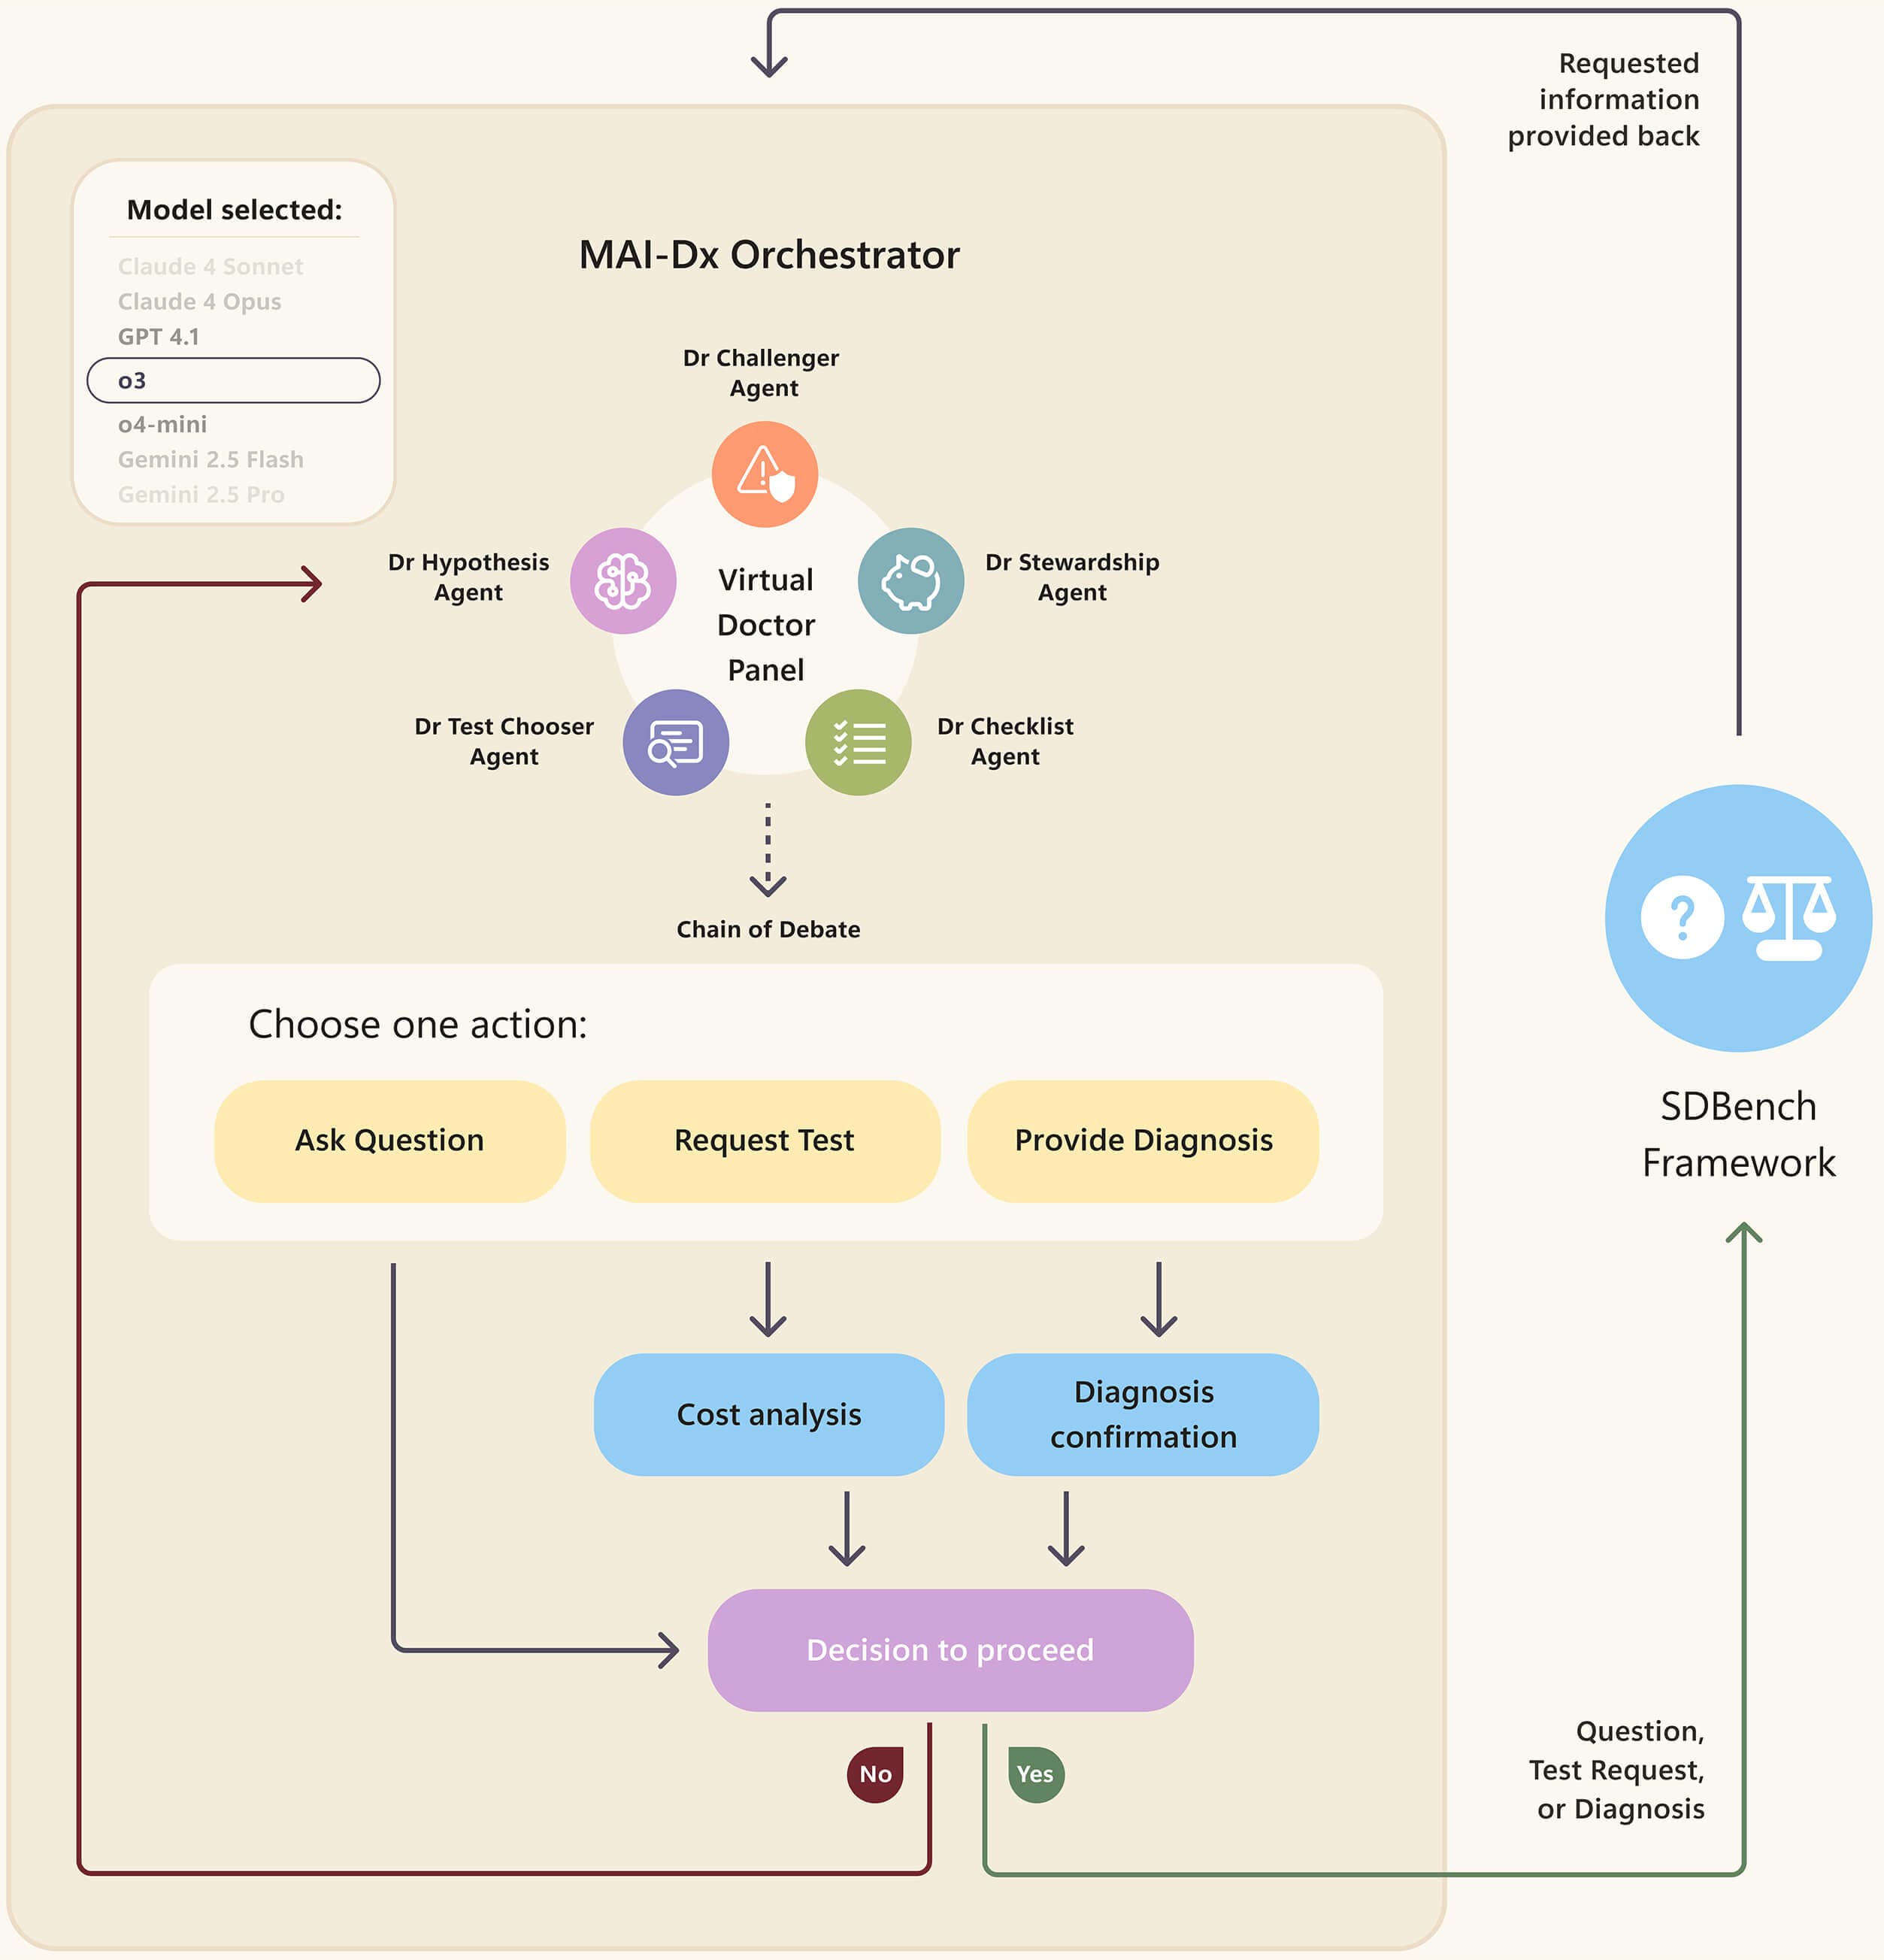
MAI-DxO verwandelt jedes Sprachmodell in ein virtuelles Gremium von Klinikern: Es kann Folgefragen stellen, Tests anordnen oder eine Diagnose stellen, anschließend die Kosten überprüfen und die eigene Argumentation validieren, bevor es entscheidet, ob es fortfahren soll.
Außergewöhnliche Testergebnisse
Microsoft AI evaluierte eine umfassende Auswahl führender generativer KI-Modelle anhand von 304 NEJM-Fällen. Zu den getesteten Basismodellen gehörten GPT, Llama, Claude, Gemini, Grok und DeepSeek.
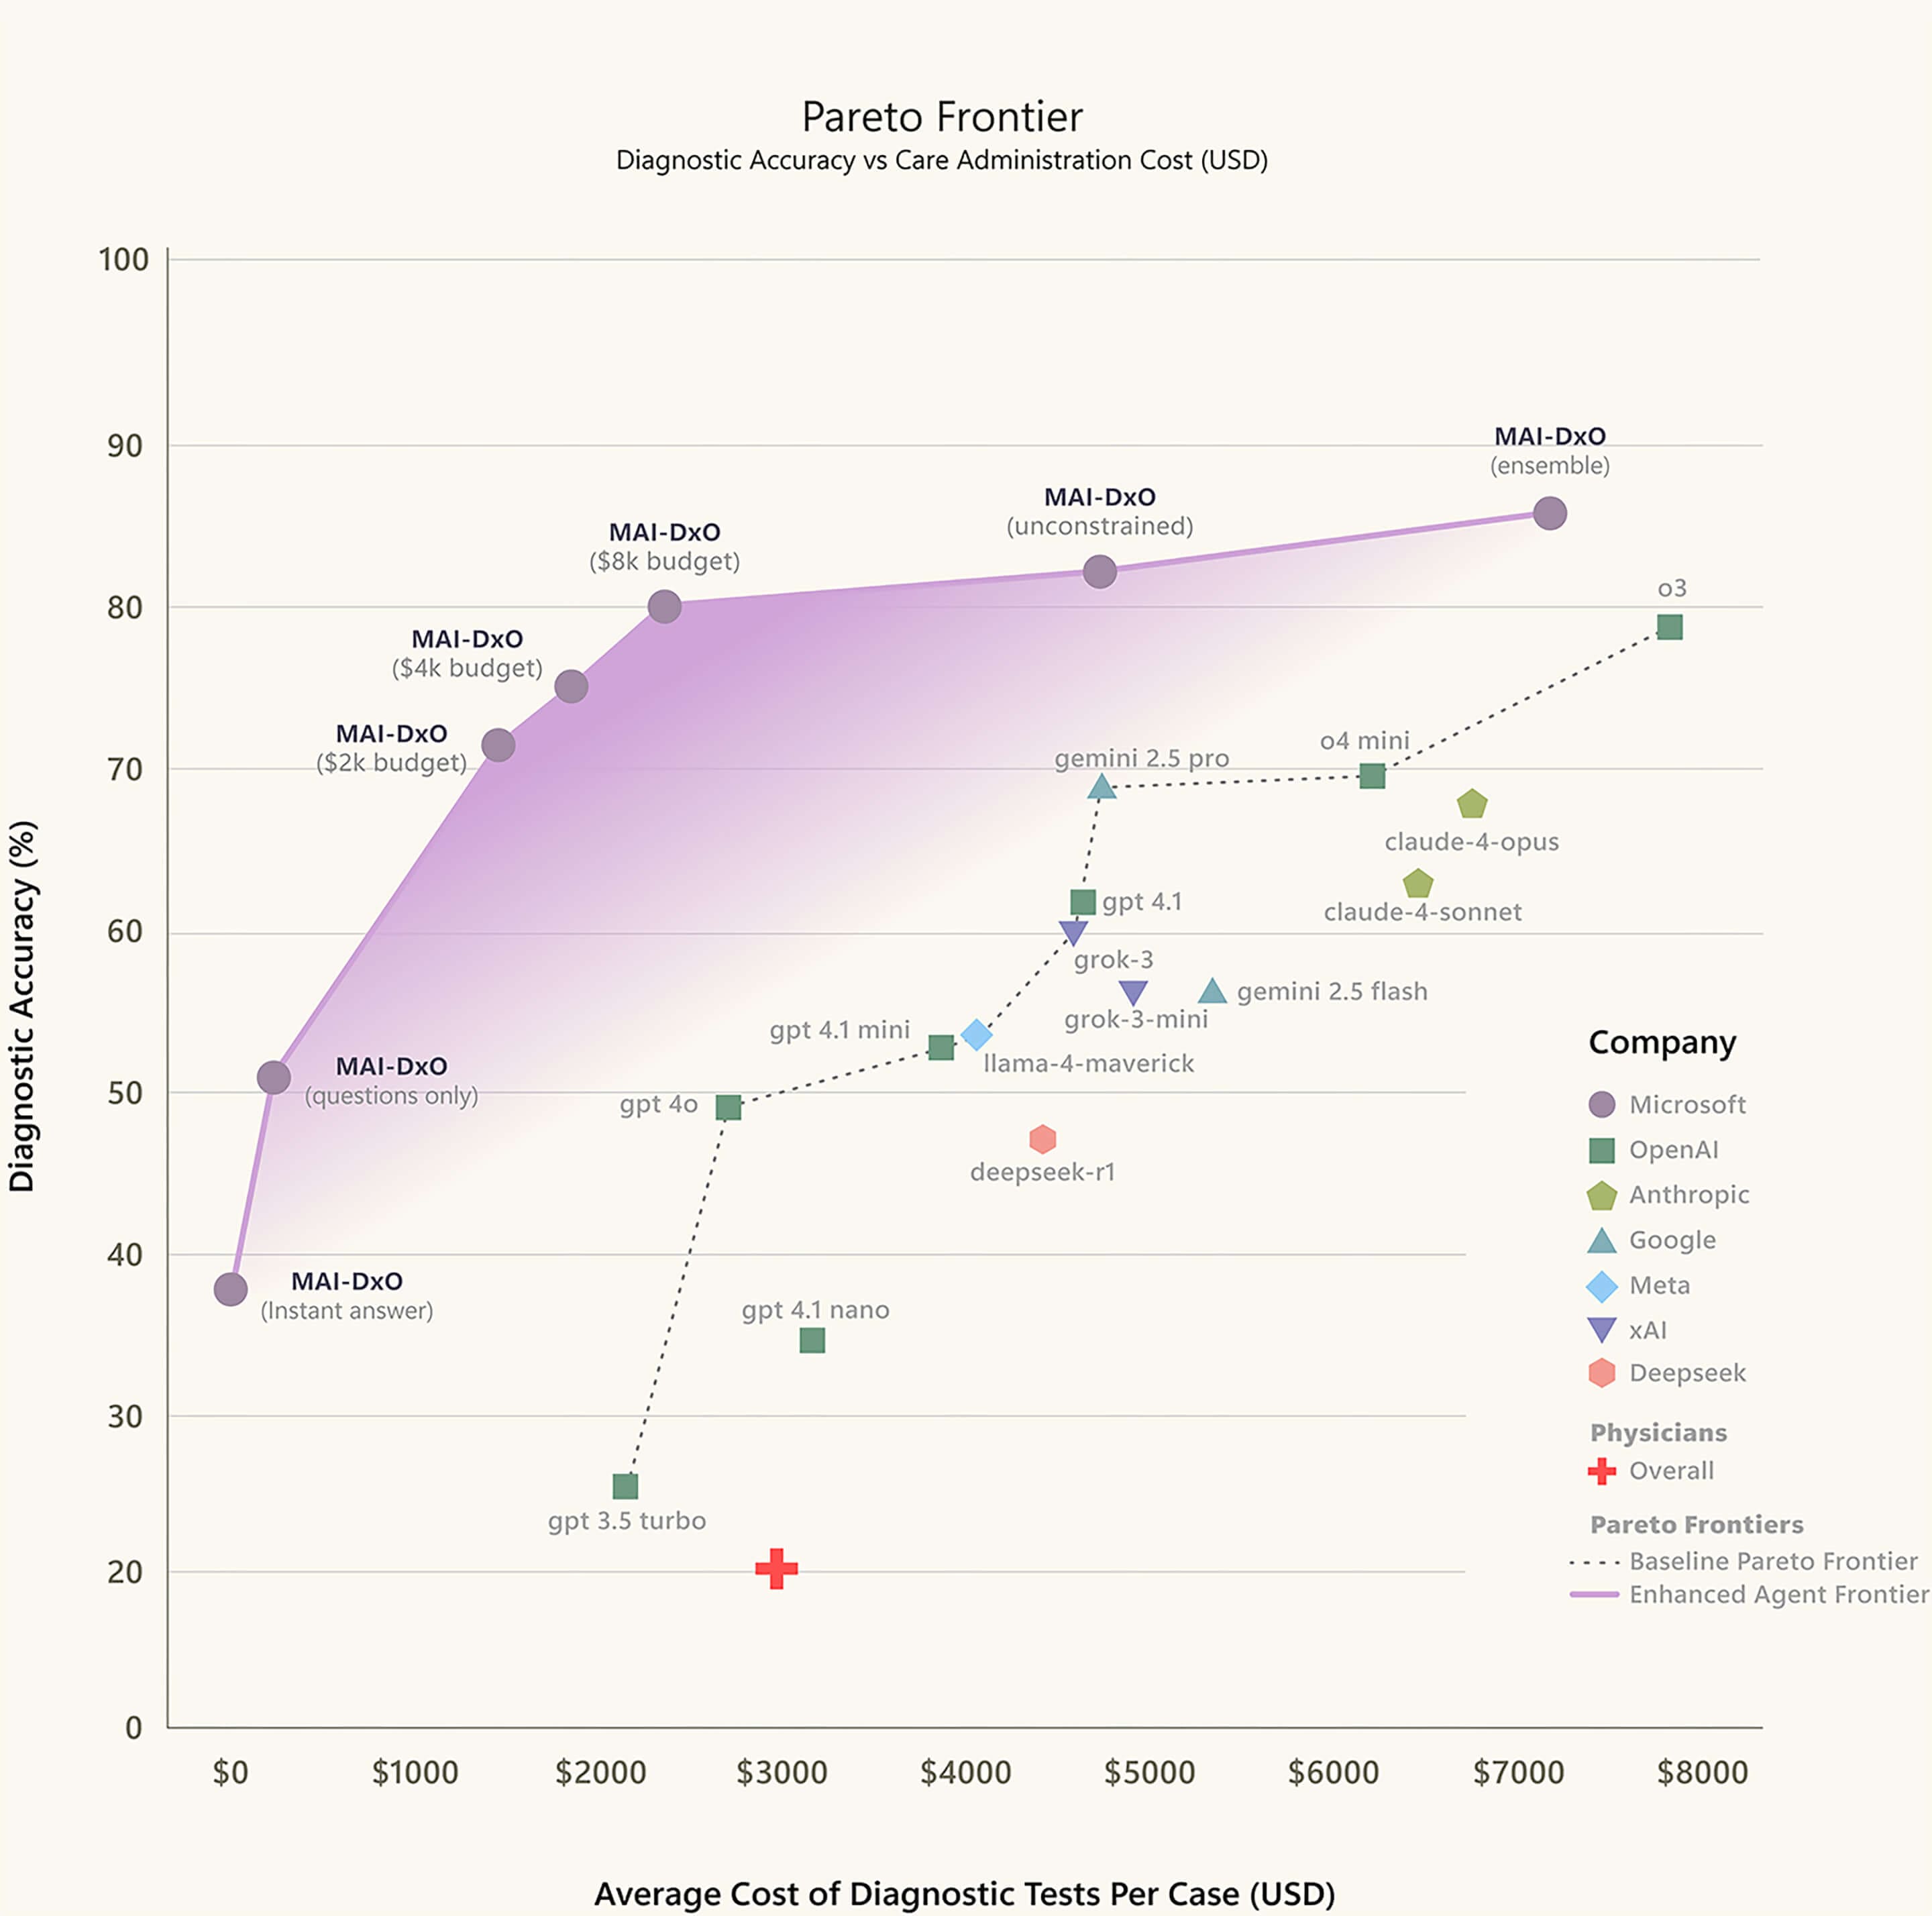
MAI-DxO steigerte die diagnostische Leistung jedes getesteten Modells. Die beste Konfiguration war MAI-DxO in Kombination mit OpenAIs o3, die 85,5 % der NEJM-Benchmarkfälle korrekt löste. Zum Vergleich wurden außerdem 21 praktizierende Ärzte aus den USA und Großbritannien evaluiert, die jeweils über 5 bis 20 Jahre klinische Erfahrung verfügten. Bei denselben Aufgaben erzielten diese Experten bei den abgeschlossenen Fällen eine durchschnittliche Genauigkeit von 20 %.
Kosteneffizienz und Genauigkeit
MAI-DxO ist konfigurierbar und kann innerhalb festgelegter Kostengrenzen arbeiten. Dies ermöglicht eine explizite Untersuchung der dem diagnostischen Entscheidungsprozess innewohnenden Kosten-Nutzen-Abwägungen. Ohne solche Einschränkungen könnte ein KI-System andernfalls standardmäßig jeden möglichen Test anordnen – ungeachtet der Kosten, der Unannehmlichkeiten für den Patienten oder der Verzögerung der Versorgung.
Wichtig ist, dass Microsoft AI feststellte, dass MAI-DxO sowohl eine höhere diagnostische Genauigkeit als auch niedrigere Gesamttestkosten erzielte als die Ärzte oder jedes einzeln getestete Basismodell.
Die Zukunft des Gesundheitswesens
Ärzte werden typischerweise durch die Breite oder Tiefe ihrer Fachkenntnisse charakterisiert. Generalisten wie Hausärzte behandeln ein breites Spektrum von Erkrankungen über verschiedene Altersgruppen und Organsysteme hinweg. Spezialisten wie Rheumatologen konzentrieren sich eingehend auf ein einzelnes System, ein Krankheitsgebiet oder sogar eine bestimmte Erkrankung. Kein einzelner Arzt kann jedoch die gesamte Komplexität der NEJM-Fallreihe abdecken. KI hingegen unterliegt diesem Zielkonflikt nicht. Sie kann sowohl die Breite als auch die Tiefe des Fachwissens vereinen und Fähigkeiten zum klinischen Schlussfolgern demonstrieren, die in vielerlei Hinsicht diejenigen jedes einzelnen Arztes übertreffen.
Diese Art des Schlussfolgerns hat das Potenzial, das Gesundheitswesen neu zu gestalten. KI könnte Patienten dazu befähigen, routinemäßige Aspekte ihrer Versorgung selbst zu übernehmen, und Kliniker bei komplexen Fällen mit fortschrittlicher Entscheidungsunterstützung ausstatten. Die Ergebnisse deuten außerdem darauf hin, dass KI unnötige Gesundheitskosten senken kann.
Einschränkungen und nächste Schritte
Die Forschung weist wichtige Einschränkungen auf. Obwohl MAI-DxO bei der Lösung der komplexesten diagnostischen Herausforderungen herausragt, sind weitere Tests erforderlich, um seine Leistung bei häufigeren, alltäglichen Krankheitsbildern zu beurteilen. Die Kliniker in der Studie arbeiteten ohne Zugang zu Kollegen, Lehrbüchern oder sogar generativer KI.
Für Microsoft AI ist dies nur der erste Schritt. Das Team sieht den bevorstehenden Chancen mit Zuversicht entgegen. Bevor generative KI im gesamten Gesundheitswesen sicher und verantwortungsvoll eingesetzt werden kann, müssen noch wichtige Herausforderungen bewältigt werden. Erforderlich sind Erkenntnisse aus realen klinischen Umgebungen sowie geeignete Steuerungs- und Regulierungsrahmen, um Zuverlässigkeit, Sicherheit und Wirksamkeit zu gewährleisten.


