Sakana AI und Forschende der UC Berkeley haben die Forschungsmethode MASS veröffentlicht, die die Steuerung eines Agententeams mit dem Finetuning eines einzigen Sprachmodells verbindet. Dasselbe Modell bearbeitet Aufgaben, bewertet die Ergebnisse und verändert den Arbeitsablauf. Nach Angaben der Forschenden verbesserten zwei Zyklen ein Modell mit offenen Gewichten und 27 Milliarden Parametern bei Forschungsaufgaben ohne eindeutige richtige Antwort – ohne externe Annotationen oder ein stärkeres Lehrermodell während des Trainings.
Ein Modell, getrennte Rollen und ein genauer Plan
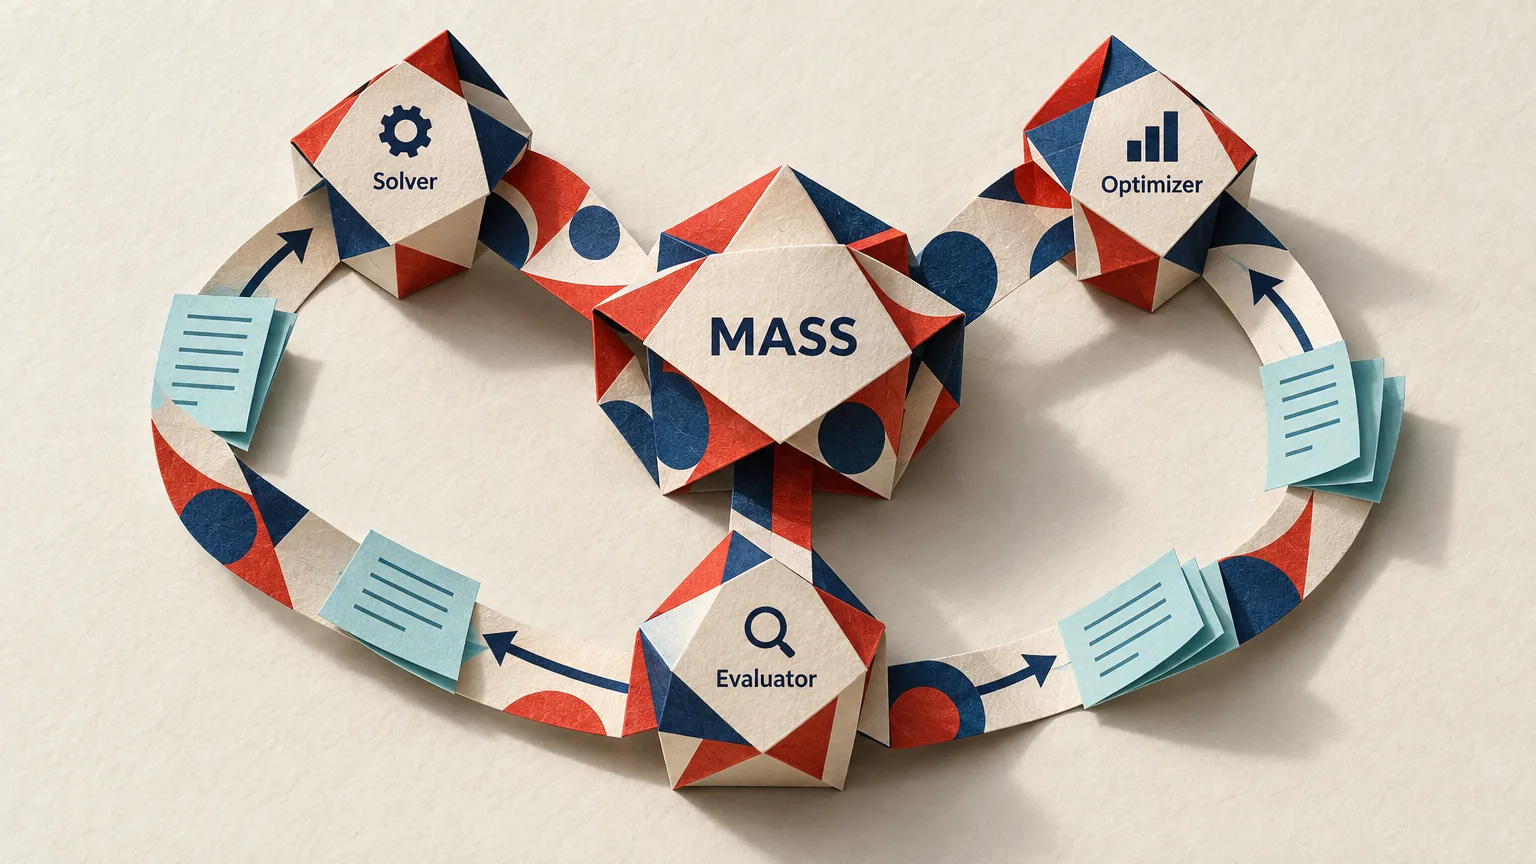
MASS steht für Multi-Agent Self-Supervision. Im Ansatz von Sakana AI und UC Berkeley arbeitet kein Team aus unterschiedlichen Modellen: Separate Aufrufe desselben Modells übernehmen die einzelnen Rollen. Ein ausführendes Team bearbeitet die Aufgabe, ein Optimierer verändert den Arbeitsablauf und ein Evaluator vergleicht die abgeschlossenen Arbeiten.
Ein schriftlicher Plan regelt die Zusammenarbeit. Er weist jedem Unteragenten Verantwortlichkeiten und Anweisungen zu und legt fest, welche Ergebnisse, Belege und Prüfungen dieser liefern muss. Ein weiterer Teil bestimmt die Reihenfolge der Aufrufe und die Übergaben zwischen den Agenten.
Die Forschenden beobachteten, dass erfolgreiche Abläufe im Verlauf der Suche vor allem die Anforderungen an Ergebnisse, Prüfungen und Abhängigkeiten zwischen den Agenten präzisierten. Bei einer Finanzaufgabe musste etwa der Datenspezialist explizite Prüfungen auf Datenlecks liefern, bevor nachgelagerte Agenten Zugriff auf die Daten erhielten.
Erst den Ablauf suchen, dann die Gewichte ändern
Der Trainingsprozess wechselt den Autoren zufolge zwischen zwei Schleifen. In der inneren bleiben die Modellgewichte unverändert, während das System für jede Aufgabe den bislang besten Arbeitsablauf festhält. Es führt einen neuen Kandidaten aus, sammelt dessen Nachrichten und Ergebnisse und lässt den Evaluator diese mit dem bisherigen besten Ergebnis vergleichen. Der Optimierer erhält diesen Vergleich als Grundlage für die nächste Überarbeitung.
In der äußeren Schleife wird der beste Ablauf für jede Aufgabe 18-mal ausgeführt. Das aktuelle Modell vergleicht die Ergebnisse paarweise; ein Bradley-Terry-Modell leitet daraus relative Bewertungen ab. Bis zu 16 ausgewählte Durchläufe pro Aufgabe dienen anschließend dazu, das Modell mit den Gesprächen des koordinierenden Orchestrators und der Unteragenten mittels LoRA nachzutrainieren.
Vor dem Finetuning entfernen die Forschenden den schriftlichen Plan aus dem Prompt des Orchestrators. Nach ihrem Ansatz lernt das Modell die Koordinationsentscheidungen aus erfolgreichen Gesprächen, statt den Plantext direkt zu kopieren.
Ergebnisse bei Forschungs- und Softwareaufgaben
Sakana AI und UC Berkeley experimentierten mit Qwen3.6-27B in der Coding-Agent-Umgebung qwen-code. Das Training umfasste 12 synthetische Forschungsaufgaben aus den Bereichen Finanzen, Robotik und Pharmazie; drei weitere synthetische Aufgaben blieben für Tests reserviert. Die Autoren berichten, dass die Gewinnquote gegenüber dem Basismodell in der paarweisen Bewertung von 53,9 % nach dem ersten Zyklus auf 69,9 % nach dem zweiten stieg. Der zweite Wert bezieht sich auf die reservierten Testaufgaben.
Auf MLR-Bench, DSBench, ScienceAgentBench und AstaBench erreichte MASS nach Angaben der Forschenden nach zwei Zyklen das 1,2- bis 1,6-Fache der Bewertung des Basismodells pro Ausgabetoken. Diese Kennzahl setzt die Leistung ins Verhältnis zur erzeugten Textmenge; das Basismodell ist auf den Wert 1,0 normiert.
Bei Software-Benchmarks fiel das Ergebnis pro Ausgabetoken dagegen schlechter aus. Die Autoren ermittelten für Terminal-Bench 2.0 nur das 0,96-Fache und für SWE-bench Verified das 0,94-Fache der Bewertung des Basismodells pro Ausgabetoken. Der Trainingsdatensatz enthielt keine Aufgaben aus dem Softwareengineering.
Was der Vergleich mit einem einzelnen Agenten zeigte
In einem weiteren Vergleich erreichte das mit MASS trainierte Modell laut Sakana AI und UC Berkeley eine Gewinnquote von 68,3 % nach der Verarbeitung von 28,8 Millionen Trainingstoken. Die beste Variante, die anhand der Arbeit eines einzelnen Agenten trainiert wurde, erreichte 64,0 % bei 42 Millionen Token.
Obwohl das Training ausschließlich Durchläufe zur Aufgabenlösung nutzte, stellten die Forschenden auch Verbesserungen in den Rollen des Optimierers und des Evaluators fest. Die Übereinstimmung des internen Evaluators mit den externen Bewertern stieg über die Zyklen hinweg von 73 % auf 93 %.
Ein separater Test zum Einfluss einzelner Komponenten beließ das Basismodell in der ausführenden Rolle, übertrug aber sowohl die Optimierung als auch die Bewertung an GPT-5.5. In dieser Konfiguration entstanden den Autoren zufolge innerhalb von fünf Iterationen siegreiche Arbeitsabläufe für alle 12 Aufgaben. Wurde nur der Evaluator verstärkt, fiel die Verbesserung geringer aus.
Open-Source-Implementierung und Grenzen gemeinsamer Gewichte
Die Autoren weisen darauf hin, dass getrennte Rollen die Korrelation von Fehlern nicht aufheben, weil die Unteragenten dieselben Gewichte verwenden. Eine falsche Annahme kann sich durch Ausführung, Bewertung und Optimierung ziehen und dabei als Fortschritt erscheinen. Auch die Suche nach Arbeitsabläufen verbessert einen bereits gefundenen guten Plan nicht unbedingt kontinuierlich.
Neben der wissenschaftlichen Veröffentlichung ist eine Open-Source-Implementierung von MASS verfügbar. Für die externe Bewertung nutzten die Forschenden GPT-5.5 und Claude Opus 4.8, deren Beurteilungen MASS während des Trainings nicht zur Verfügung standen. Wer diese Bewertung reproduzieren möchte, benötigt Zugang zu beiden Modellen.