

Llama 4: Meta enthüllt die neue Generation multimodaler KI-Modelle
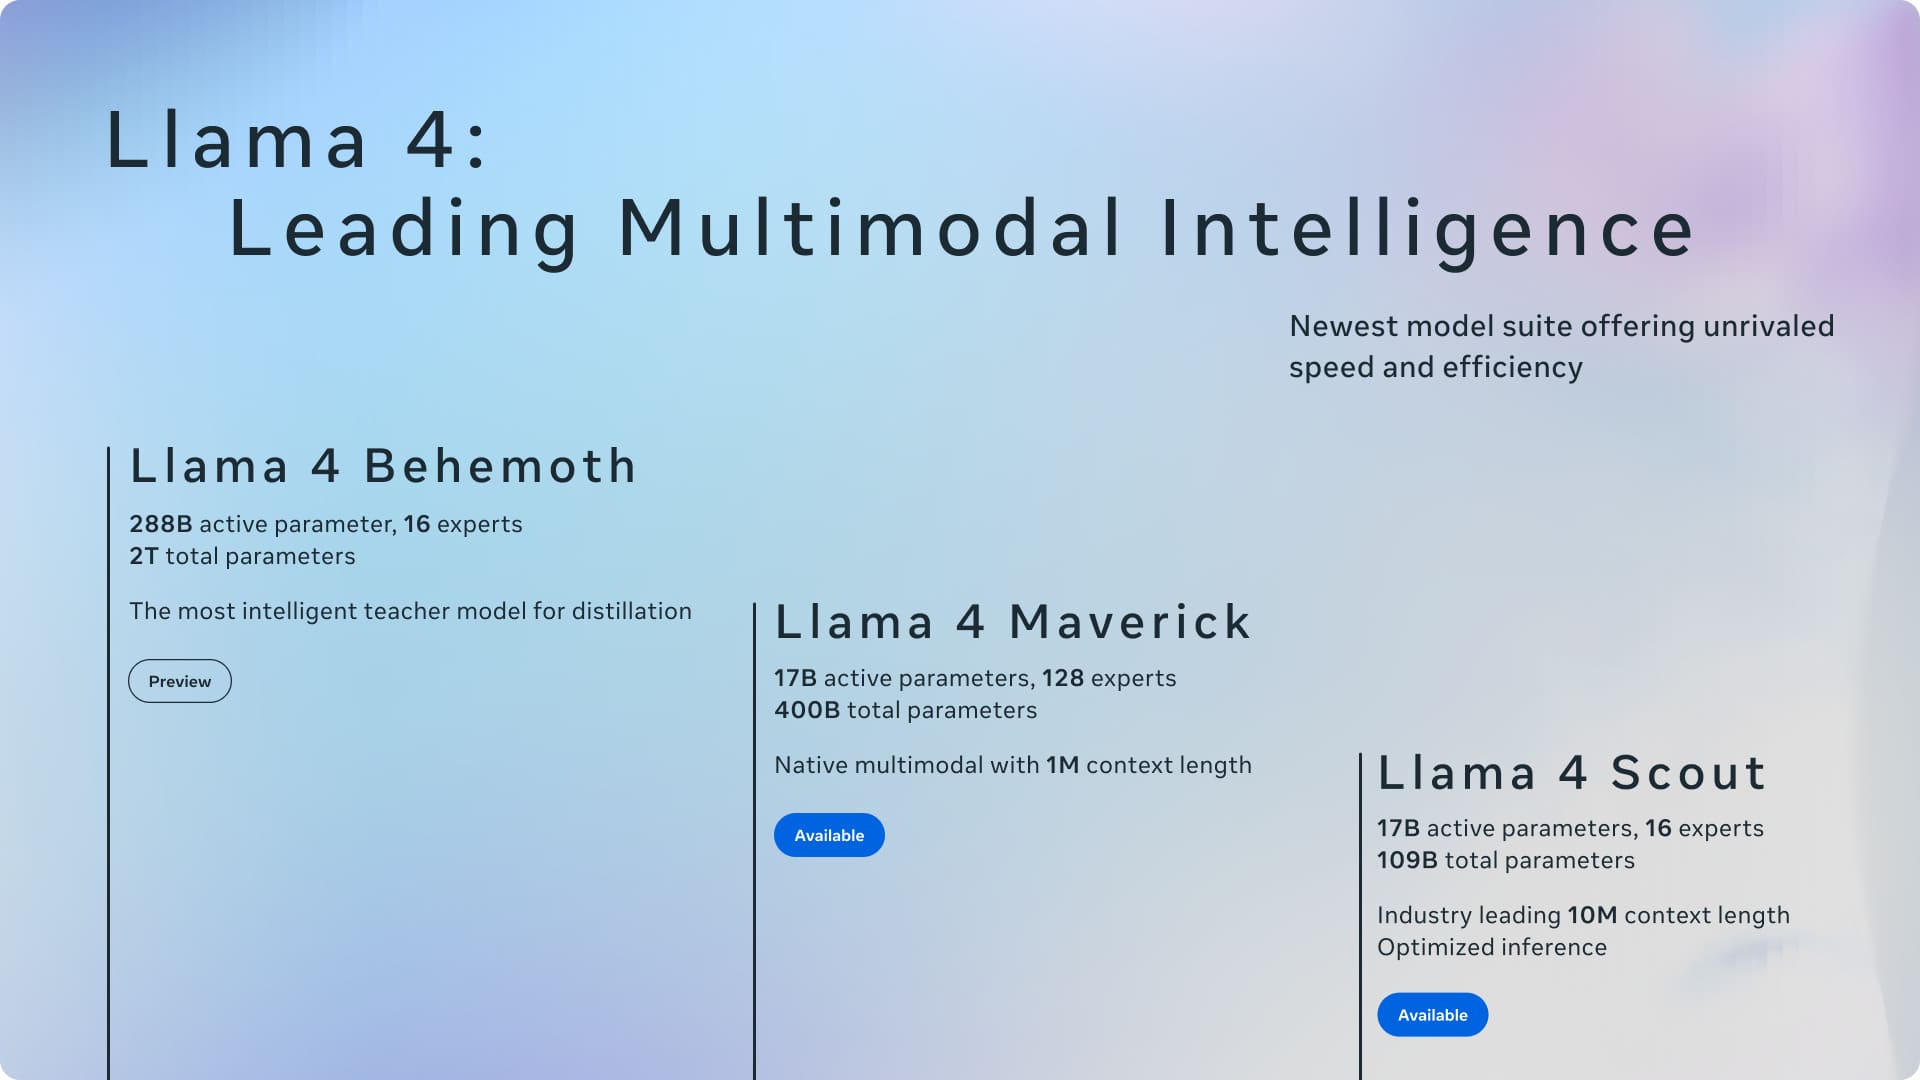
Meta AI hat gerade ihre neue Generation von KI-Modellen vorgestellt, die die Spielregeln verändern könnte. Was bringt Llama 4 und warum sollte Sie das interessieren?
Eine neue Ära der multimodalen künstlichen Intelligenz
Das vergangene Wochenende brachte Veränderungen im Bereich der künstlichen Intelligenz. Meta (ehemals Facebook) stellte ihre neue Generation von Sprachmodellen vor, die sie „Llama 4“ nennt. Es handelt sich nicht nur um eine weitere iterative Verbesserung – Meta behauptet, dass dies der „Beginn einer neuen Ära der nativ multimodalen KI-Innovation“ sei. Was bedeutet das? Einfach gesagt können diese Modelle nicht nur mit Text, sondern auch mit Bildern arbeiten – und das alles innerhalb eines einzigen integrierten Systems. Stellen Sie sich eine KI vor, die die Welt ähnlich wie wir sieht und versteht.
Lernen Sie die Llama-4-Familie kennen
Meta stellte zwei Modelle vor, die sofort verfügbar sind:
Llama 4 Scout
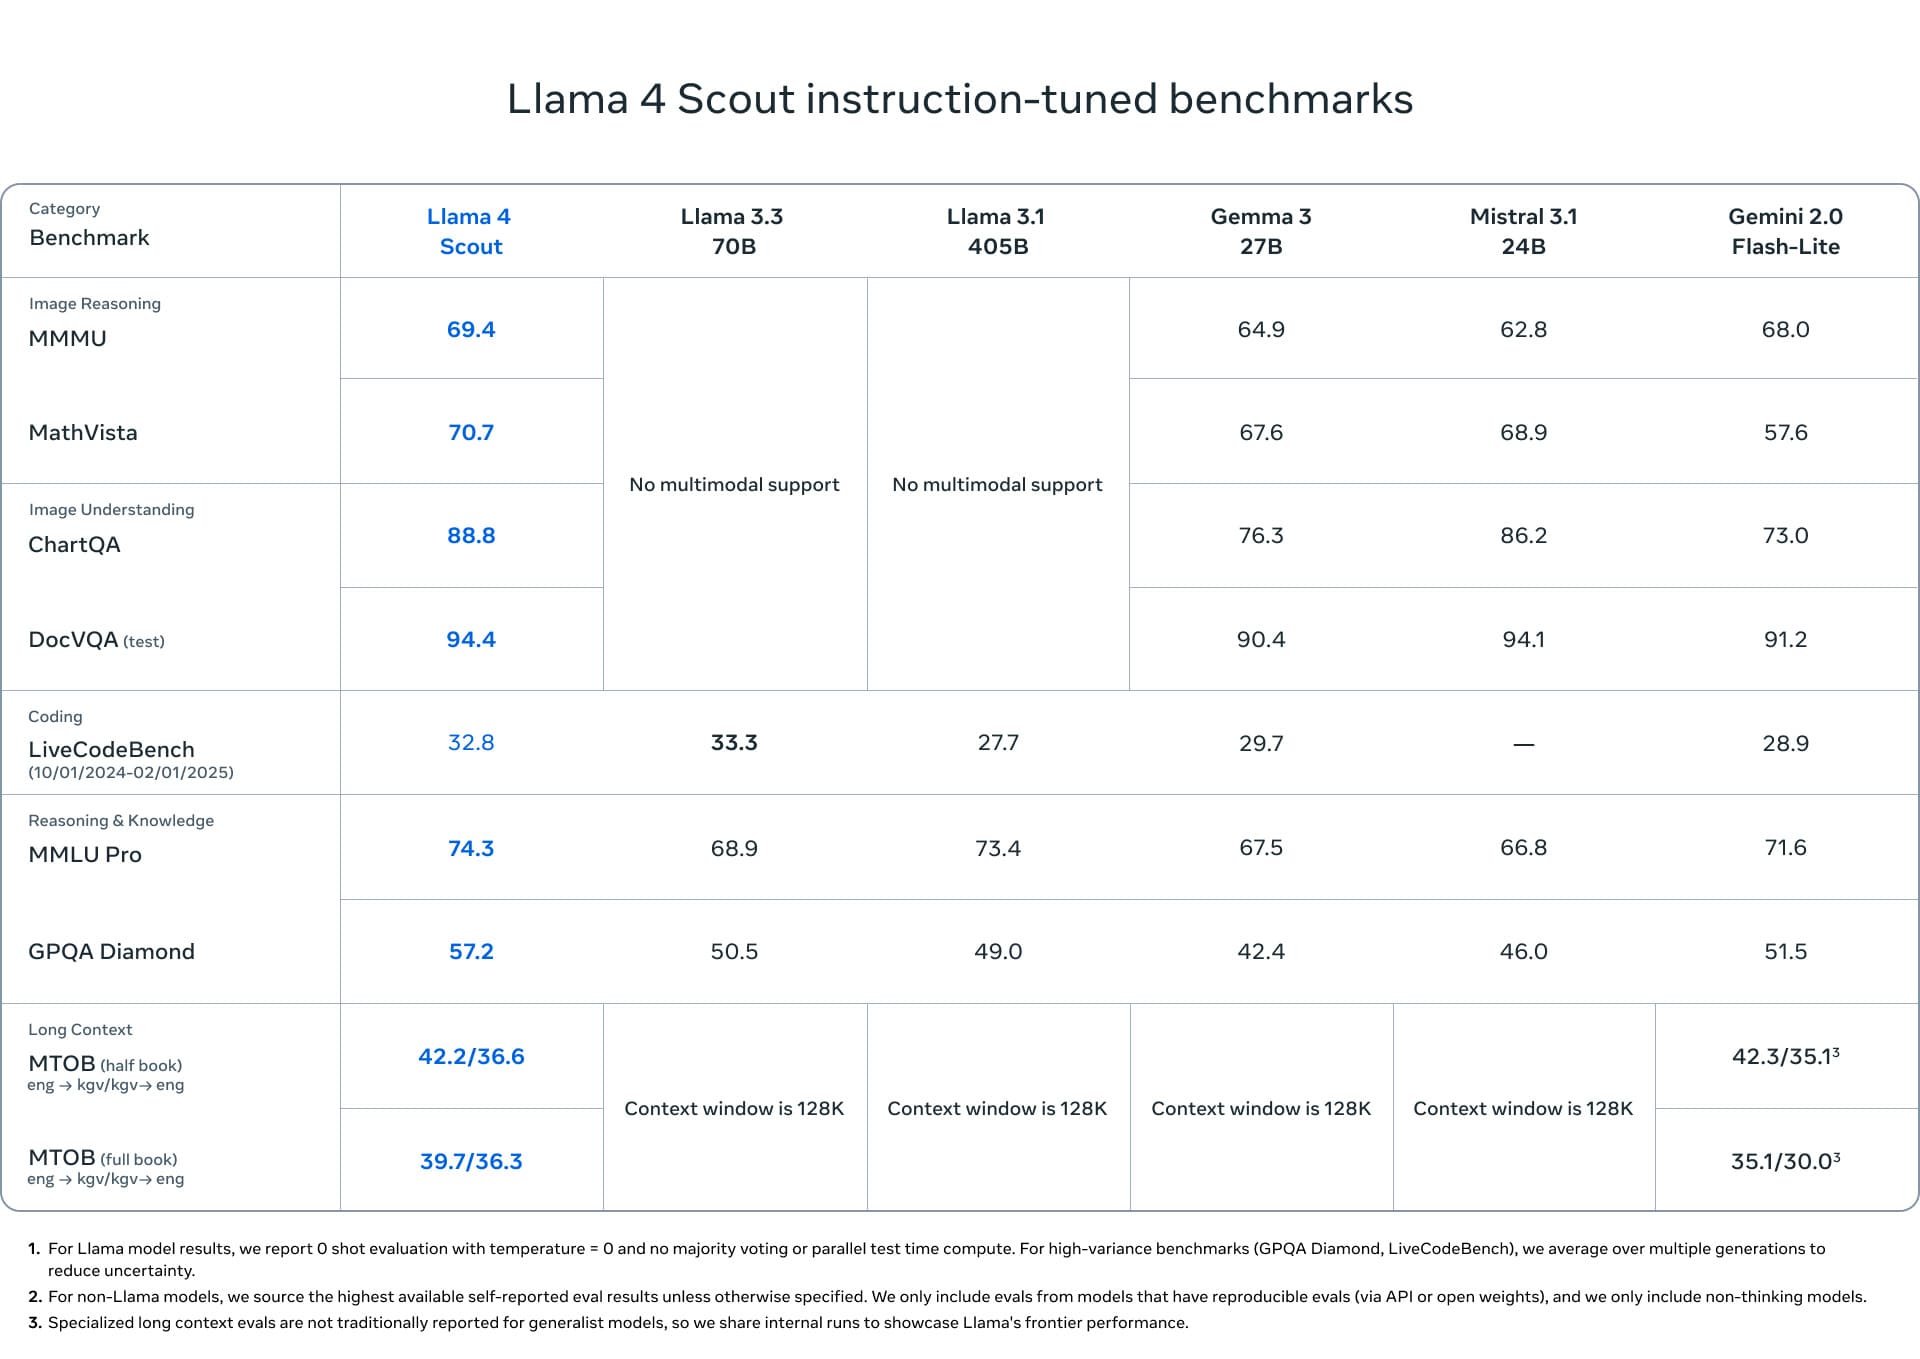
Ein kleineres, aber außerordentlich leistungsfähiges Modell mit 17 Milliarden aktiven Parametern, das 16 Expertenmodule nutzt (insgesamt 109 Milliarden Parameter). Scout zeichnet sich aus durch:
- Ein außergewöhnliches Verhältnis von Leistung zu Größe
- Die Fähigkeit, auf einem einzigen NVIDIA-H100-GPU-Chip zu laufen (mit Int4-Quantisierung)
- Ein beeindruckendes Kontextfenster von bis zu 10 Millionen Token (das ist etwa 33-mal mehr als bei Llama 3!)
Llama 4 Maverick
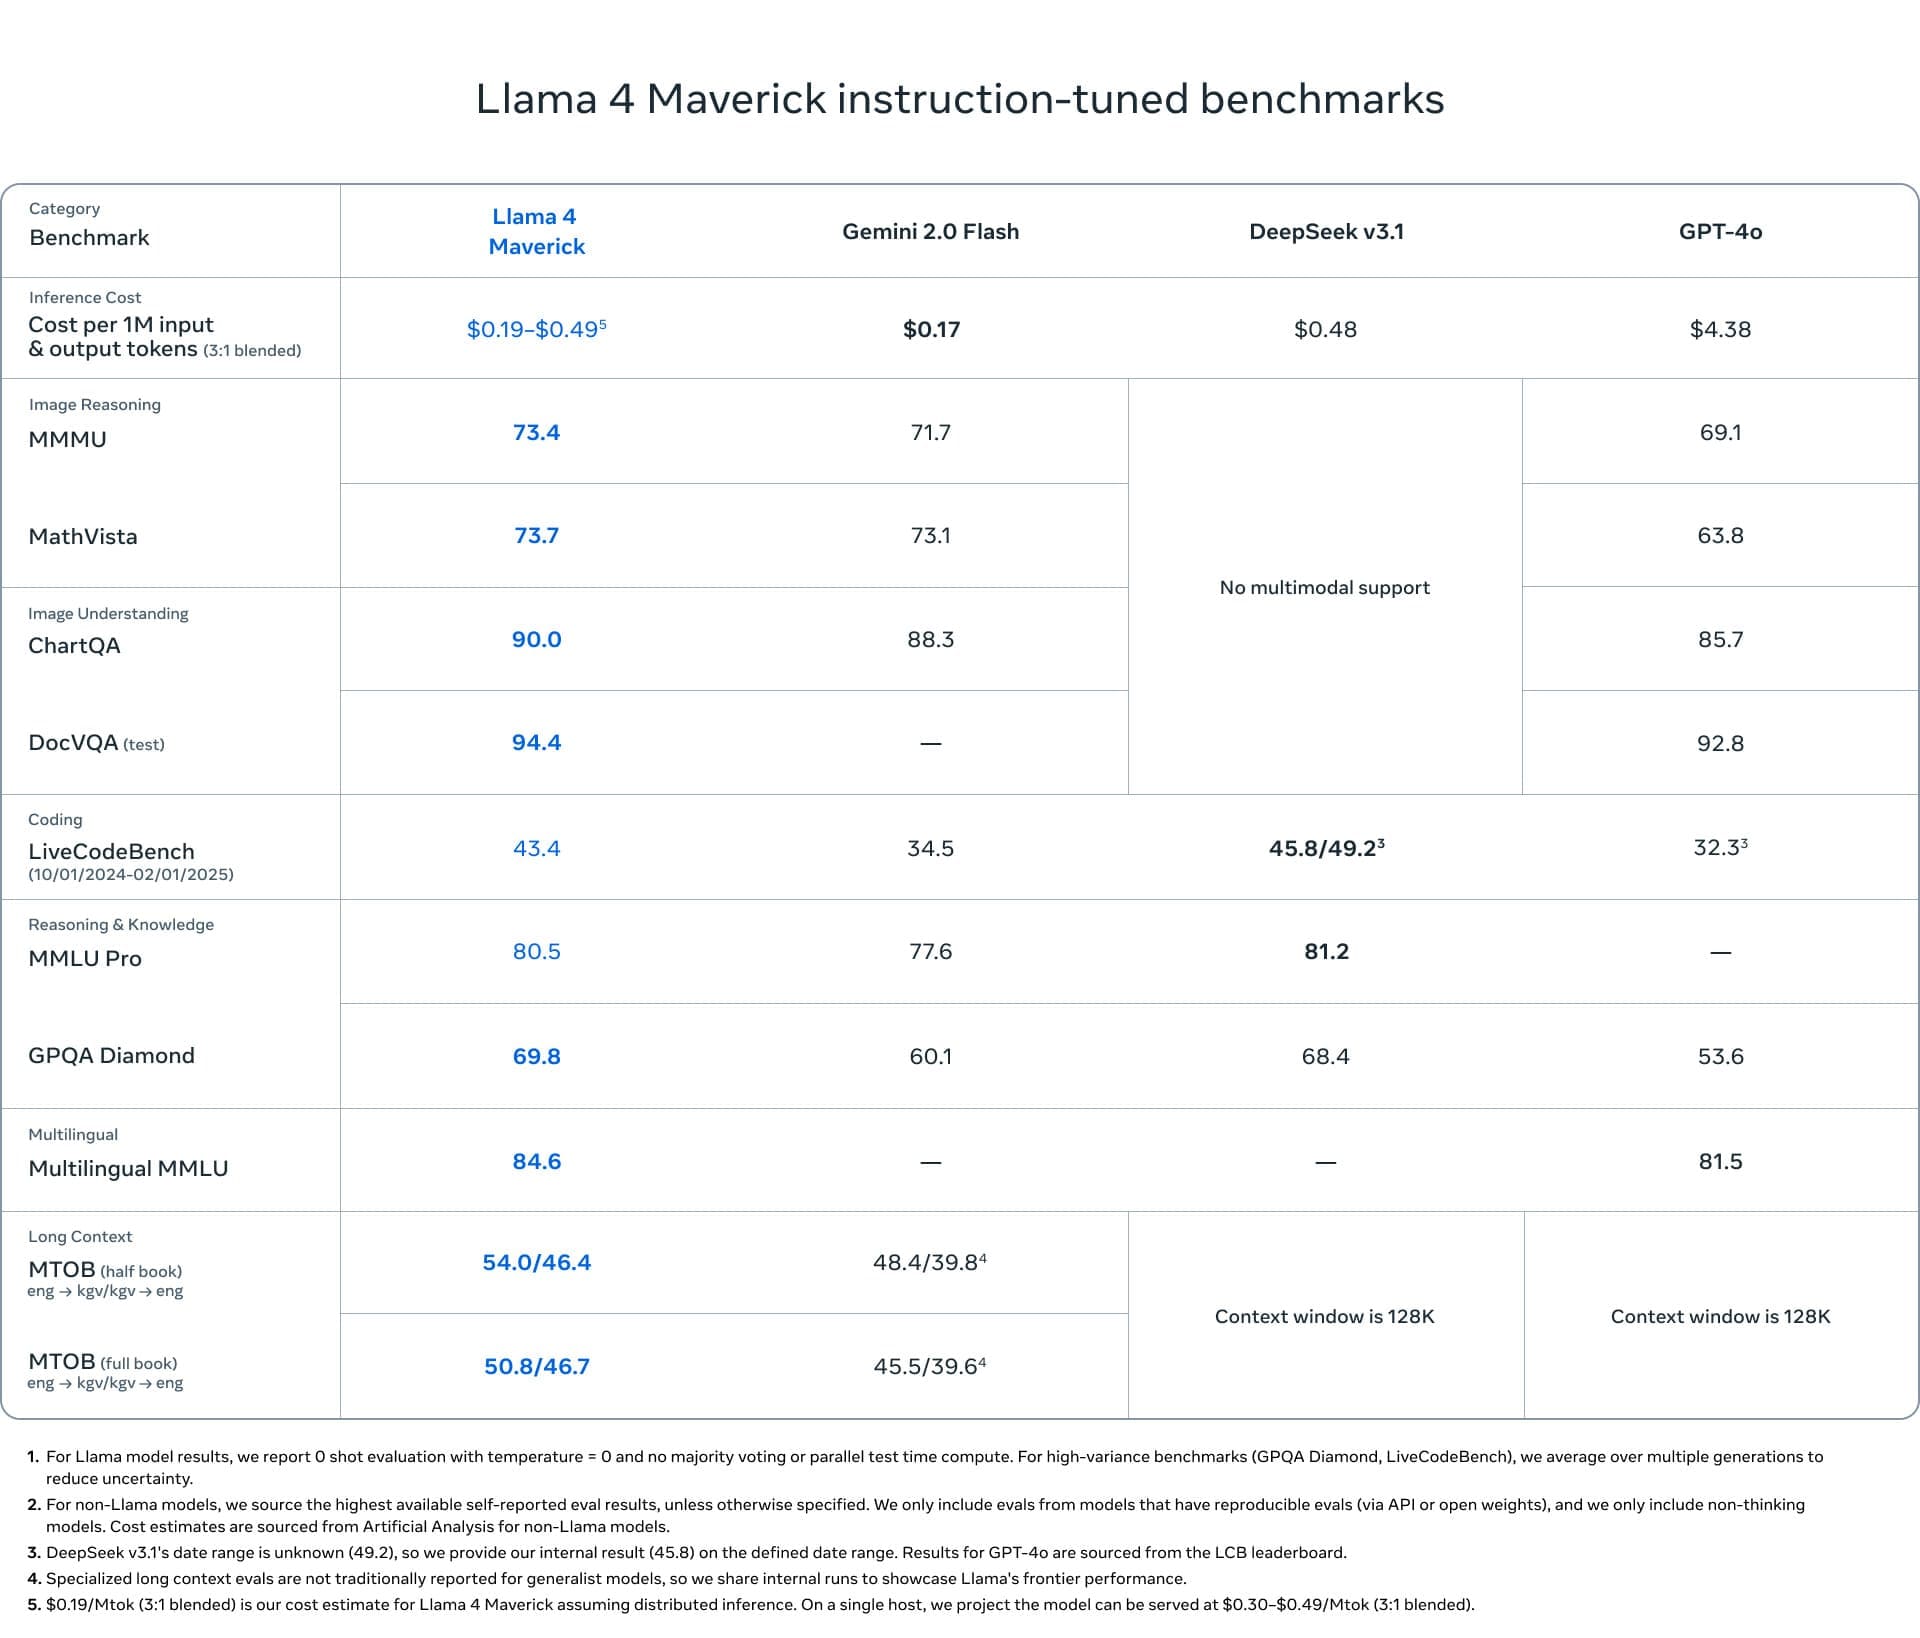
Der leistungsfähigere Bruder mit 17 Milliarden aktiven Parametern, der 128 Expertenmodule nutzt (insgesamt 400 Milliarden Parameter). Maverick bietet:
- Spitzenleistung unter den multimodalen Modellen seiner Klasse
- Bessere Ergebnisse als GPT-4o und Gemini 2.0 Flash in einer breiten Palette von Benchmarks
- Vergleichbare Ergebnisse mit dem neuen DeepSeek v3 in den Bereichen Schlussfolgern und Programmieren – mit weniger als der Hälfte der aktiven Parameter
Die Geheimwaffe: Llama 4 Behemoth
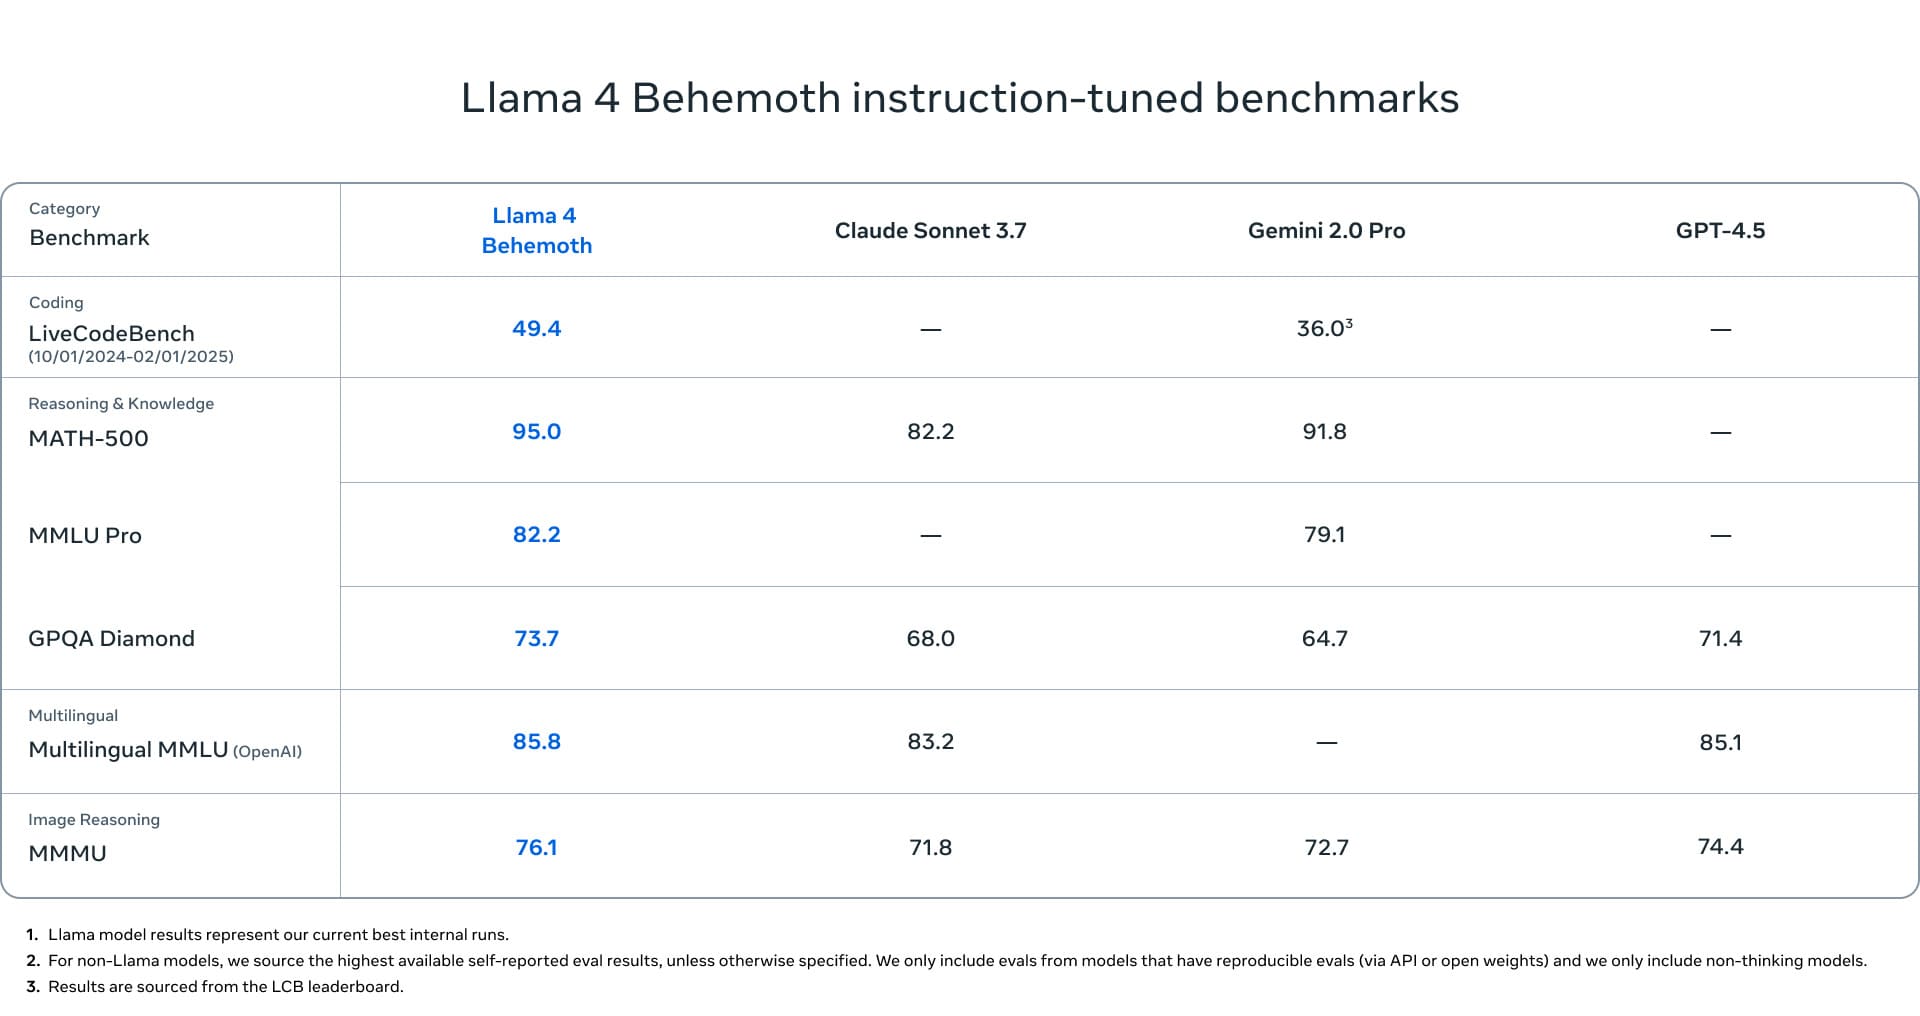
Meta gewährte außerdem einen ersten Einblick in ihr ehrgeizigstes Projekt – Llama 4 Behemoth, ein massives Modell mit 288 Milliarden aktiven Parametern und 16 Expertenmodulen, das insgesamt fast 2 Billionen Parameter umfasst. Dieser Koloss übertrifft angeblich Modelle wie GPT-4.5, Claude Sonnet 3.7 und Gemini 2.0 Pro in mehreren wissenschaftlichen und technischen Benchmarks. Behemoth ist zwar noch nicht verfügbar – es wird weiterhin trainiert –, diente aber als „Lehrer“ für die kleineren Modelle Scout und Maverick. Dieser Ansatz, bei dem ein großes Modell ein kleineres trainiert, ist einer der Schlüssel dafür, dass auch die kompakten Llama-4-Modelle so beeindruckende Ergebnisse erzielen.
Technische Magie: Was steckt unter der Haube?
Für Technikbegeisterte stecken die neuen Llama-Modelle voller Innovationen:
Mixture-of-Experts-(MoE-)Architektur
Zum ersten Mal in der Geschichte der Llama-Modelle hat Meta eine MoE-Architektur implementiert, die die Effizienz dramatisch steigert. Bei MoE-Modellen aktiviert jedes Token nur einen Teil der gesamten Parameter. Das bedeutet, dass das Modell deutlich größer sein kann, ohne dass der Rechenaufwand entsprechend steigt. Bei Llama 4 Maverick durchläuft beispielsweise jedes Token einen gemeinsam genutzten Experten und einen von 128 spezialisierten Experten. Das erklärt, warum das Modell über 400 Milliarden Gesamtparameter, aber nur 17 Milliarden aktive Parameter verfügt.
Native Multimodalität
Anders als bei vielen konkurrierenden Lösungen, bei denen die Bildverarbeitung lediglich an das Sprachmodell „angeflanscht“ wird, wurde Llama 4 von Grund auf als multimodales Modell entwickelt. Meta nennt dies „Early Fusion“ – Text und Bild werden bereits in frühen Verarbeitungsphasen zusammengeführt.
Rekordverdächtiges Kontextfenster
Mit einem Kontextfenster von 10 Millionen Token kann Llama 4 Scout Model auf einmal das Äquivalent einer ganzen Enzyklopädie verarbeiten. Zum Vergleich: Ein gewöhnlicher Roman umfasst etwa 100.000 Token, sodass das Modell 100 Bücher gleichzeitig analysieren könnte. Wie hat Meta das erreicht? Mithilfe einer neuen Architektur namens iRoPE, die verschachtelte Aufmerksamkeitsebenen ohne Positionsembeddings verwendet.
Beispiellose Leistung in Benchmarks
Meta behauptet, dass ihre Modelle die Konkurrenz in allen wichtigen Kategorien übertreffen:
- Llama 4 Scout übertrifft Modelle wie Gemma 3, Gemini 2.0 Flash-Lite und Mistral 3.1 in einer breiten Palette von Benchmarks.
- Llama 4 Maverick übertrifft GPT-4o und Gemini 2.0 Flash beim Programmieren, Schlussfolgern, in mehrsprachigen Tests, Tests mit langem Kontext und Bild-Benchmarks.
- In Konversationstests erzielte die experimentelle Chat-Version von Maverick eine Punktzahl von 1417 ELO auf LMArena.
Sicherheit an erster Stelle
Meta widmete den Sicherheitsaspekten ihrer neuen Modelle große Aufmerksamkeit. Das Unternehmen implementierte mehrere Schutzmechanismen:
- Filterung der Daten während des Vortrainings.
- Umfassende Optimierung nach dem Training für ein sicheres Verhalten.
- Open-Source-Tools wie Llama Guard und Prompt Guard zur Erkennung schädlicher Ein- und Ausgaben.
- Ein neues System namens Generative Offensive Agent Testing (GOAT) zur Simulation von Angriffen.
Interessant ist, dass Meta ausdrücklich auch das Problem der politischen Voreingenommenheit in KI-Modellen erwähnt. Das Unternehmen gibt an, dass Llama 4 so entwickelt wurde, dass es beide Seiten kontroverser Themen unvoreingenommen artikulieren kann und bestimmte Meinungen gegenüber anderen nicht bevorzugt.
Was bedeutet das für die KI-Welt?
Die Veröffentlichung von Llama 4 erfolgt in einer Zeit intensiven Wettbewerbs im KI-Bereich. Microsoft und OpenAI haben kürzlich GPT-4o vorgestellt, Google sein Gemini und Anthropic das Modell Claude. Meta beweist nun, dass das Unternehmen in diesem Rennen nicht den zweiten Platz belegen will. Besonders interessant ist, dass Meta – während die Konkurrenten ihre Modelle meist unter Verschluss halten – weiterhin auf einen offenen Ansatz setzt, der es der Entwicklergemeinschaft ermöglicht, mit den Modellen zu experimentieren und sie zu verbessern. „Wir glauben, dass Offenheit Innovation fördert und gut für Entwickler, gut für Meta und gut für die Welt ist“, schreibt das Unternehmen in seinem Blog.
Meta deutet an, dass die vorgestellten Modelle erst der Anfang sind. Auf der Konferenz LlamaCon am 29. April plant das Unternehmen, mehr über seine Vision zu enthüllen, den Llama-Modellen „Superkräfte“ für natürliche Konversation, die Lösung komplexer Probleme und die Ausführung generalisierter Aktionen zu verleihen. Die Kombination aus Spitzenleistung, Multimodalität, Offenheit und einer effizienten MoE-Architektur macht Llama 4 zu einer der interessantesten Entwicklungen im KI-Bereich der letzten Zeit. Die Frage bleibt, wie schnell es der Entwicklergemeinschaft gelingen wird, diese Fähigkeiten zu nutzen und in praktische Anwendungen zu integrieren.
Wie können Sie Llama 4 ausprobieren?
Meta bleibt ihrer Philosophie der Offenheit treu. Llama 4 Scout und Maverick stehen bereits auf llama.com und Hugging Face zum Download bereit. In den kommenden Tagen werden sie auch über Partnerplattformen verfügbar sein. Wenn Sie das Modell nicht selbst bereitstellen möchten, können Sie die neue Llama-Generation direkt in den Meta-Produkten ausprobieren: WhatsApp, Messenger, Instagram Direct oder auf der Website Meta.AI.


