

Große Sprachmodelle (LLMs) sind zu einem Teil unseres Alltags geworden. Sie helfen beim Schreiben von Texten, beim Generieren von Code oder sogar beim Lösen komplexer Aufgaben. Aber was, wenn ich Ihnen sage, dass diese Modelle ein enormes Problem mit etwas so Grundlegendem wie dem Addieren von Zahlen haben? Wes McKinney, Autor des Blogbeitrags, hat sich das genauer angesehen, und seine Erkenntnisse sind überraschend. Alles begann, als Wes mit den Tools Claude Code des Unternehmens Anthropic experimentierte. Er stellte fest, dass selbst die modernsten Modelle bei einfachen mathematischen Operationen versagen, was die Vorstellung infrage stellt, dass eine allgemeine künstliche Intelligenz (AGI) unmittelbar bevorsteht.
Wes beschreibt seinen Weg mit KI-Tools. Bis März dieses Jahres stand er der Unterstützung durch KI beim Programmieren skeptisch gegenüber. Während seiner gesamten Karriere seit 2008 arbeitete er im Editor Emacs ohne fortgeschrittene Funktionen wie LSP (Language Server Protocol). Dann entdeckte er Claude Code und konnte plötzlich langweilige Aufgaben, die Arbeit mit CI/CD-Tools, die Systemadministration oder die Codebereinigung delegieren. Innerhalb von acht Monaten steigerte dies seine Produktivität erheblich, allerdings nur bei bestimmten Arten von Aufgaben. So erstellte er beispielsweise mit Claude Code das Tool moneyflow für die persönliche Buchhaltung, dessen Entwicklung er früher als zu zeitaufwendig erachtet hätte.
Dennoch stieß Wes auf frustrierende Grenzen. KI-Modelle ignorieren häufig Anweisungen, etwa aus der Datei CLAUDE.md, in der Regeln für den Codestil oder die Typprüfung in Python festgelegt sind. Manchmal erfinden sie Benchmark-Ergebnisse, wenn etwas nicht funktioniert, oder verhalten sich inkonsistent – in einer Woche perfekt, in der nächsten chaotisch. Wes betrachtet sie als Werkzeug für erfahrene Entwickler, die gute Anweisungen geben und die Ausgabe kontrollieren können, nicht aber als Weg zur Superintelligenz.
Überzogene Versprechen versus Realität
Menschen überschätzen häufig die Fähigkeiten von LLMs. Wes zufolge helfen diese Modelle vor allem denjenigen, die Anforderungen klar formulieren und Ergebnisse überprüfen können, ähnlich wie ein Senior-Entwickler einen Junior beaufsichtigt. Ohne Erfahrung geht man in minderwertigen Ausgaben unter, und das gilt nicht nur beim Programmieren, sondern auch bei Unterhaltungen mit KI. Wes konzentrierte sich jedoch auf ein bestimmtes Problem: Die Modelle weisen kognitive Defizite auf, beispielsweise mangelhafte Rechenfähigkeiten. Das steht im Gegensatz zu den Vorhersagen, dass AGI bald kommen werde – manche sprechen von einem oder zwei Jahren, Sam Altman von OpenAI vom Ende des Jahrzehnts.
Wes stieß auf dieses Problem, als er ein Tool zur Zusammenfassung der Aktivitäten in einem GitHub-Repository entwickelte. Die Modelle scheiterten beim Addieren einfacher Tabellen. Das veranlasste ihn zu Tests. Er ließ sich auch von einem Blogbeitrag von Anthropic über den fortgeschrittenen Einsatz von Tools inspirieren, in dem beschrieben wird, wie ein Modell 2000 Datenzeilen „von Hand addiert“. Wes musste darüber lachen, weil er weiß, dass Modelle bereits bei kleinen Zahlenlisten scheitern.
Wie schlecht schneiden LLMs in Mathematik ab?
Um dies zu überprüfen, führte Wes Tests mit verschiedenen Modellen durch. Die Aufgabe war einfach: Aus einer CSV-Tabelle mit Transaktionen (Spalten txnid, groupid, value) sollte die Summe der Werte nach Gruppen berechnet werden. Die Werte waren ganze Zahlen von 0 bis 10. Der Prompt wies das Modell an, ausschließlich eine CSV-Ausgabe ohne Text zurückzugeben und keine Tools aufzurufen – es sollte direkt rechnen.
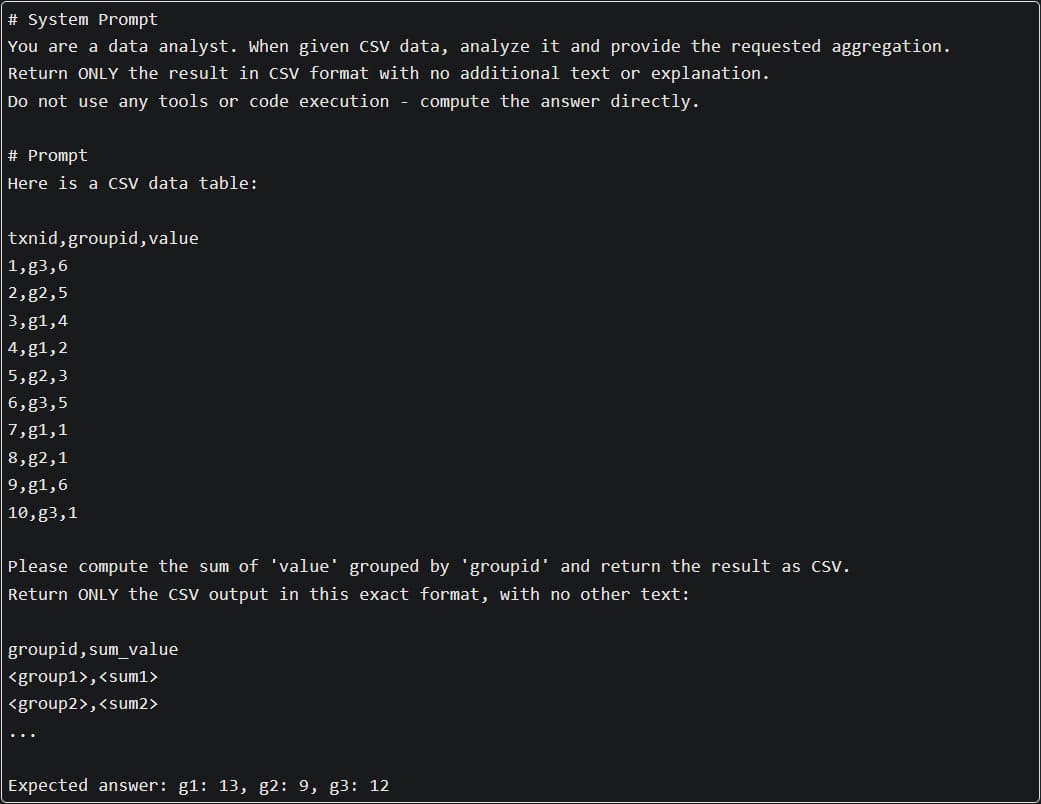
Er testete Modelle von OpenAI (GPT-4o, GPT-4o-mini, GPT-4.1, GPT-4.1-mini, GPT-4.1-nano), Anthropic (Haiku-3.5, Sonnet-3.7, Haiku-4.5, Opus-4.5, Sonnet-4, Sonnet-4.5) und lokale Modelle (GPT-OSS-20b, GPT-OSS-120B, Qwen2.5-Coder). Jeder Test wurde 100-mal mit einer unterschiedlichen Anzahl von Zeilen (10, 50, 100) und Gruppen (1, 10, 25) durchgeführt.
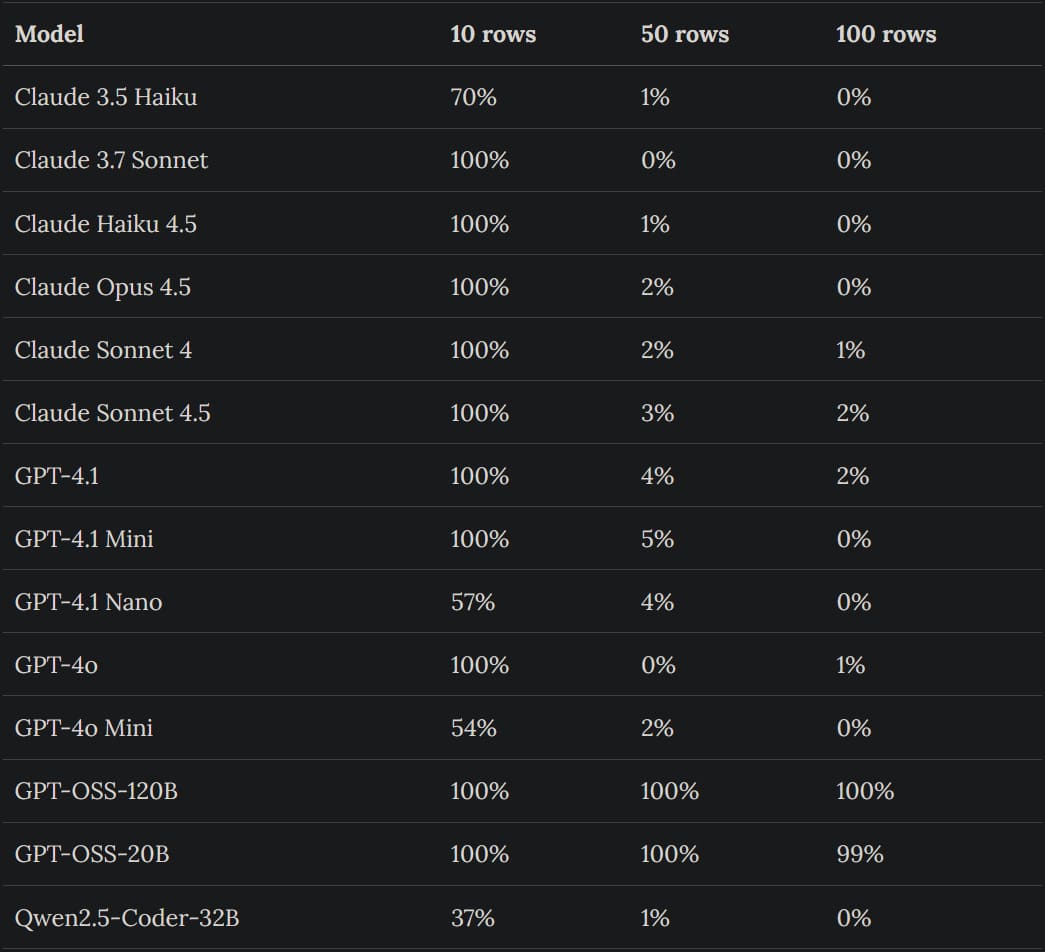
Bei einer Gruppe (also lediglich der Addition aller Werte) scheiterten die API-Modelle bei größeren Tabellen. Claude 3.5 Haiku erreichte beispielsweise bei 10 Zeilen eine Erfolgsquote von 70%, bei 50 Zeilen jedoch nur 1% und bei 100 Zeilen 0%. Die lokalen GPT-OSS-Modelle waren nahezu perfekt – GPT-OSS-120B erreichte bei allen Tests 100%. Qwen2.5-Coder scheiterte ähnlich wie die kleinen API-Modelle.
Bei 10 Gruppen waren die Ergebnisse für kleinere Datenmengen besser, da auf jede Gruppe weniger Zahlen entfielen. Opus-4.5 erreichte bei 100 Zeilen 100% und bei 200 Zeilen 95%, GPT-4o-mini dagegen bei 100 Zeilen nur 1%. Die lokalen Modelle dominierten erneut.
Bei 25 Gruppen, bei denen auf jede Gruppe nur 2–4 Zahlen entfielen, waren die Ergebnisse modellübergreifend besser. Claude Opus-4.5 erreichte sowohl bei 100 als auch bei 200 Zeilen 100%. Kleine Modelle wie GPT-4o-mini scheiterten jedoch vollständig.
Wes untersuchte detailliert, ab wann Modelle wie Sonnet-4.5 und GPT-4.1 versagen – bei etwa 20–25 Zahlen beginnt die Erfolgsquote zu sinken. Die lokalen Modelle bewältigten bis zu 1000 Zeilen, allerdings mit einem leichten Rückgang der Genauigkeit und einer längeren Verarbeitungszeit.
Warum fehlt GPT-5 in den Tests?
Wes testete GPT-5 nicht, weil es ihm verdächtig erschien. Das Modell addierte selbst 1000 Zeilen korrekt, war jedoch extrem langsam – 34-mal langsamer als GPT-4.1. Wes vermutet, dass GPT-5 „tiefergehendes Schlussfolgern“ nutzt oder im Hintergrund Tools aufruft, was die Verzögerung verursacht.
Übermäßiges Selbstvertrauen der Modelle und die Rolle von Tools
Die Modelle sind sich ihrer Schwächen nicht bewusst. Wes ließ sie ihre eigene Genauigkeit beim Addieren von 50 Zahlen einschätzen – die meisten schätzten sie auf 85–100%, obwohl sie in der Realität scheitern. Das ist problematisch, da sie Anweisungen zum Aufrufen von Tools ignorieren können.
Wes schlägt bessere Methoden für die Arbeit mit Daten vor, beispielsweise das Anhängen von Dateien in Formaten wie Arrow oder Parquet, anstatt sie in den Kontext einzufügen. Das spart Token und erhöht die Genauigkeit.
Insgesamt schätzt Wes LLMs wegen der Zeitersparnis bei langweiligen Aufgaben, betont jedoch ihre Grenzen. Der Code zur Reproduktion der Tests ist auf GitHub verfügbar.


