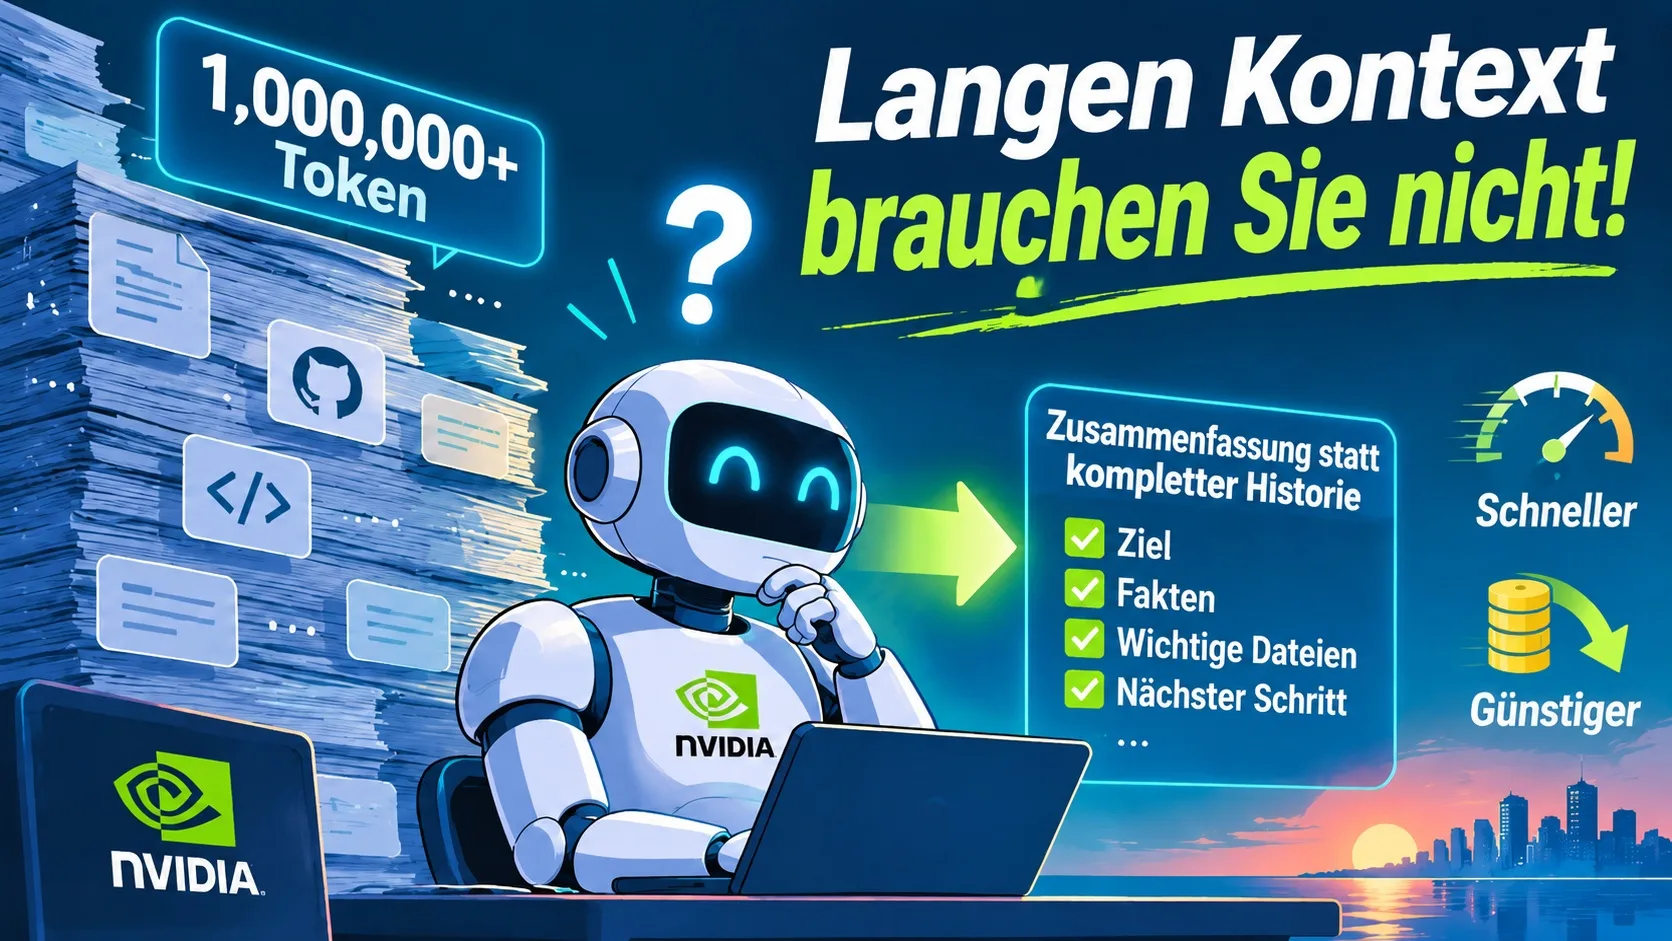
Die größten Sprachmodelle können auf einmal mehr Text erfassen, als Tolkiens Der Herr der Ringe oder Tolstois Krieg und Frieden enthalten. GPT 5.6 Sol bewältigt über eine Million Token, also ungefähr 790.000 englische Wörter. Zwölf Forscher von Nvidia stellten sich jedoch die unangenehme Frage, ob Modelle ein derart riesiges Gedächtnis überhaupt benötigen. Ihre Antwort lautet in den meisten Fällen: nein. Die Studie mit dem vielsagenden Titel You don’t need long context zeigt, dass KI-Agenten auch anspruchsvolle Aufgaben mit einem deutlich kürzeren Kontext bewältigen und dabei häufig genauso gut oder sogar besser abschneiden.
Je länger das Gedächtnis, desto langsamer das Modell
Jedes neue Token, das ein Modell erzeugt, muss alles berücksichtigen, was ihm vorausging. Je mehr Text sich in einer Konversation ansammelt, desto mehr Rechenleistung und Speicher erfordert jedes weitere Wort. Bei KI-Agenten macht sich das besonders bemerkbar. Beim Programmieren durchsucht ein Agent Repositorys, bearbeitet Dateien und führt Tests aus, und jeder dieser Schritte wird der nächsten Anfrage an das Modell hinzugefügt. Der Verlauf wächst, obwohl der größte Teil davon längst nicht mehr von Nutzen ist.
Die Forscher maßen dies bei drei Modellen mit offenen Gewichten auf Nvidia-H100-Grafikkarten. Als sie das Kontextfenster von 256.000 auf 16.000 Token verkleinerten, erzeugte das Modell GLM 5.2 in derselben Zeit etwa 3,6-mal mehr Token, Kimi K2.6 ungefähr 5,6-mal mehr und Qwen 3 Coder Next sogar siebenmal mehr. Auf dem kleineren Gerät DGX Spark war die Generierungszeit mit langem Kontext bei mehreren Modellen ungefähr doppelt so hoch wie mit kurzem. Die Autoren weisen darauf hin, dass gewöhnliche Nutzer diese Unterschiede nicht sehen, da die Anbieter unabhängig von der Länge der Konversation einen festen Preis pro Million Token berechnen.
Ein Agent muss sich nicht alles merken
Das Team testete 13 Benchmarks, darunter SWE-bench Verified mit realen Fehlern aus GitHub, Terminal-Bench und LongBench v2. Die wichtigsten Versuche liefen mit den Modellen Claude Opus 4.5 und GPT 5.6 Sol. Die Ausgangsvariante behielt die gesamte Konversation im Gedächtnis. Sobald die angepasste Variante das festgelegte Limit von beispielsweise 12.000 Token erreichte, ließ sie die Konversation vom Modell kurz zusammenfassen und begann eine neue Unterhaltung, die nur die ursprüngliche Aufgabenstellung und diese Zusammenfassung enthielt.
Die Ergebnisse überraschten. Bei SWE-bench Verified löste Claude Opus 4.5 mit vollständigem Verlauf 70 Prozent der Aufgaben, mit regelmäßiger Kürzung in der besten Konfiguration fast 75 Prozent. GPT 5.6 Sol verbesserte sich von 84,4 auf 88,8 Prozent. Über lange agentenbasierte Aufgaben hinweg lag die Genauigkeit meist nur wenige Prozentpunkte über oder unter dem Ausgangsniveau, während die geschätzten Kosten ungefähr um das Zwei- bis Neunfache sanken.
Entscheidend ist, wie die Zusammenfassung gestaltet ist. Die Forscher stellten fest, dass eine gewöhnliche Zusammenfassung häufig falsche Informationen beibehält. Sie gibt auffällige Ereignisse aus dem Verlauf des Agenten wieder, obwohl diese keine Rolle mehr spielen. Wesentlich besser funktionierte etwas, das einer Übergabebesprechung ähnelt. Darin hält das Modell das ursprüngliche Ziel, verifizierte Fakten, wichtige Dateien und Ergebnisse, vorgenommene Änderungen, Sackgassen, die nicht erneut beschritten werden sollten, die verbleibende Arbeit und den unmittelbar nächsten Schritt fest.
Es genügt zu wissen, wo man nachsehen muss
Bei Aufgaben mit riesigen Dokumenten wählten die Autoren einen anderen Ansatz. Statt die vollständigen Texte in die Aufgabenstellung einzufügen, speicherten sie sie als Dateien. Der Agent durchsuchte sie mit gewöhnlichen Befehlen wie grep und übernahm nur die Passagen in sein Gedächtnis, die er tatsächlich benötigte. Diese Methode war dem klassischen Vorgehen in fast allen sieben Tests mit langen Eingaben ebenbürtig oder überlegen. Beim Test zur Suche nach der Nadel im Heuhaufen erreichten beide Modelle eine Erfolgsquote von 100 Prozent. Claude Opus 4.5 verbesserte sich bei der Aufgabe AA-LCR, bei der es über mehrere reale Dokumente hinweg schlussfolgern muss, von 65 auf 84 Prozent. Dabei schlossen die Agenten ihre Arbeit häufig ab, ohne das Gedächtnis auch nur ein einziges Mal kürzen zu müssen. Der Hauptvorteil bestand also nicht darin, das Gelesene zusammenzufassen, sondern intelligent auszuwählen, was überhaupt gelesen werden sollte.
Danach versuchte das Team ein Extrem. Nach jeder einzelnen Aktion schrieb der Agent die Beschreibung des Aufgabenstatus neu und verwarf die vorherige Konversation. Der nächste Schritt begann somit nur mit der Aufgabenstellung und dieser aktuellen Beschreibung. Dennoch erreichten beide Modelle bei SWE-bench Verified fast das Niveau der Variante mit vollständigem Verlauf. Der Median der längsten Konversation sank dabei auf lediglich 7.000 bis 9.000 Token, und das Maximum verringerte sich von einer Spanne von 130.000 bis 200.000 auf 15.000 bis 37.000.
Daraus leiteten die Forscher die Idee sogenannter semantischer Zustandsmodelle ab. Diese würden lernen, zwischen den einzelnen Schritten eine verständliche textuelle Beschreibung des Aufgabenstatus weiterzugeben, die auch ein Mensch lesen kann, anstelle unleserlicher Zahlen innerhalb des neuronalen Netzes. Nach Ansicht der Autoren gibt es keinen Grund, warum solche Modelle nicht dieselben Ergebnisse erzielen könnten wie jene, die den gesamten Verlauf speichern.
Nicht jedes Modell bewältigt das
Die Studie hat allerdings ihre Tücken. Die Modelle reagieren sehr unterschiedlich auf die Kürzung des Gedächtnisses. Qwen 3 Coder Next fiel bei SWE-bench Verified mit einem Limit von 16.000 Token von 53 Prozent auf knapp 4 Prozent. Schuld daran waren seine ausschweifenden Ausgaben, die zwischen den einzelnen Zusammenfassungen keinen Raum für die eigentliche Arbeit ließen. Qwen 3.6 27B oder MiniMax M2.7 schnitten dagegen wesentlich besser ab und verloren nur wenig. Nach Ansicht der Autoren sollten Entwickler daher alles mit ihren eigenen Aufgaben und verschiedenen Limits ausprobieren, anstatt blind einer einzigen Konfiguration zu vertrauen.
Auch bei den Ausgaben für Cloudmodelle kann eine unangenehme Überraschung warten. Anbieter gewähren einen Rabatt, wenn aufeinanderfolgende Anfragen denselben Anfang teilen und das Modell frühere Berechnungen wiederverwenden kann. Durch die Kürzung des Gedächtnisses verändert sich dieser Anfang jedoch, wodurch der Rabatt entfällt. Bei den üblichen Preisen pro Token stiegen die Kosten von GPT 5.6 Sol bei SWE-bench Verified daher paradoxerweise von ungefähr 168 auf 203 Dollar, obwohl das Modell kürzere Konversationen verarbeitete. Die in der Studie bezifferten Einsparungen setzen voraus, dass Anbieter für einen kürzeren Kontext weniger berechnen würden, was bislang nicht der üblichen Praxis entspricht.
Die Autoren räumen noch eine weitere Grenze ein. Bei einer Zusammenfassung geht immer etwas verloren, und bei Aufgaben, bei denen es auf jedes Detail ankommt, etwa bei präzisen Aufzeichnungen oder Prüfpfaden, lohnt es sich nicht, sich auf sie zu verlassen. Daher empfehlen sie, die ursprünglichen Daten separat aufzubewahren, damit der Agent sie jederzeit nachschlagen kann. Ihre These stützen sie schließlich auf Alan Turing, der bereits in den 1930er-Jahren davon ausging, dass sich alles Berechenbare berechnen lässt, selbst wenn man nur einen begrenzten Teil der Eingabe betrachtet und lediglich einen endlichen Zustand im Gedächtnis behält.
Quellen: arxiv.org und cryptobriefing.com