

Ihre KI-Unterhaltungen waren nie privat – jetzt haben wir die Beweise
Erinnern Sie sich daran, als Sie dachten, Ihre gelöschten ChatGPT-Unterhaltungen seien tatsächlich verschwunden? Nun, was das betrifft ...
Der Gerichtsbeschluss, der alles verändert
Ein US-Bundesrichter hat OpenAI gerade angewiesen, ALLE Benutzerunterhaltungen auf unbestimmte Zeit aufzubewahren. Dazu gehören diejenigen, die Sie gelöscht haben, jene „temporären“ Chats, die verschwinden sollten, die Weitergabe von Geschäftsgeheimnissen über die OpenAI-API – einfach alles. Der Beschluss ist Teil einer laufenden Klage der The New York Times und betrifft Hunderte Millionen Nutzer weltweit.
Magistratsrichterin Wang erließ einen weitreichenden Beschluss, der OpenAI verpflichtet, sämtliche Aufzeichnungen von ChatGPT-Benutzerchats auf unbestimmte Zeit aufzubewahren. Diese Anordnung entstand auf Antrag der The New York Times, die vermutet, dass solche Daten Beweise enthalten könnten, die für ihren Rechtsstreit relevant sind. Die The New York Times verklagte OpenAI und Microsoft mit der Begründung, ihre urheberrechtlich geschützten Artikel seien ohne Genehmigung zum Trainieren großer Sprachmodelle wie ChatGPT verwendet worden.
Gilt der Gerichtsbeschluss auch für tschechische Nutzer?
Ja, dieser US-Gerichtsbeschluss gilt weltweit für alle ChatGPT-Nutzer, einschließlich Nutzern aus der Tschechischen Republik und der gesamten Europäischen Union. Das bedeutet, dass auch Ihre auf Tschechisch geführten Unterhaltungen mit ChatGPT nun auf unbestimmte Zeit aufbewahrt werden, unabhängig davon, ob Sie sie gelöscht oder ihre Löschung beantragt haben.
Diese Situation schafft einen rechtlichen Konflikt mit der europäischen Datenschutz-Grundverordnung (DSGVO), die das Recht auf Löschung von Daten (auch als „Recht auf Vergessenwerden“ bekannt) garantiert. Die DSGVO stellt strenge Anforderungen an die Speicherung und Verarbeitung von Daten, und die unbegrenzte Aufbewahrung von Benutzerunterhaltungen ohne Zustimmung des Nutzers steht in direktem Widerspruch zu diesen Vorschriften.
Für tschechische Nutzer bedeutet dies, dass ihre Daten nun entgegen den europäischen Datenschutzstandards gespeichert werden, an die sie gewöhnt sind. OpenAI muss den US-Gerichtsbeschluss befolgen, auch wenn dies gegen seine Verpflichtungen gegenüber europäischen Nutzern gemäß der DSGVO verstößt.
OpenAI gibt nicht kampflos auf
OpenAI nimmt diesen Beschluss nicht auf die leichte Schulter. In seinem Blogbeitrag bezeichnete das Unternehmen die Forderung als „weitreichende und unnötige“ Überschreitung der Befugnisse, die „grundlegend mit den Datenschutzverpflichtungen kollidiert, die wir gegenüber unseren Nutzern eingegangen sind“. Das Unternehmen betont, dass es Nutzern ermöglicht, sich abzumelden und die dauerhafte Entfernung gelöschter Unterhaltungen aus seinen Systemen innerhalb von 30 Tagen zu beantragen.
Am 3. Juni 2025 beantragte OpenAI beim US-Bezirksrichter Sidney Stein die Aufhebung des im Mai erlassenen Beschlusses zur Datensicherung. Das Unternehmen erhebt aktiv rechtliche Einwände, um die Aufhebung dieser Anordnung zu erreichen, da es argumentiert, dass die unbegrenzte Aufbewahrung von Benutzerunterhaltungen eine zu weitreichende Forderung sei, die seinen langfristigen Verpflichtungen zum Schutz der Privatsphäre der Nutzer widerspreche.
OpenAI erklärte in seiner offiziellen Stellungnahme, dass die technische und rechtliche Umsetzung dieses Beschlusses Monate dauern und erhebliche technische sowie rechtliche Probleme verursachen werde, insbesondere angesichts der widersprüchlichen Anforderungen der EU-Datenschutzgesetze.
Sam Altman und das Konzept des „KI-Privilegs“
Sam Altman, CEO von OpenAI, ging noch weiter und schlug das Konzept eines „KI-Privilegs“ vor. Diese Idee sieht vor, dass Gespräche mit einer KI ähnlich geschützt werden sollten wie die Kommunikation mit Anwälten oder Ärzten. Das würde bedeuten, dass Benutzerchats mit KI-Systemen vertraulich wären und zum Schutz der Privatsphäre vor einer weitreichenden rechtlichen Offenlegung geschützt würden.
Wir haben in letzter Zeit über die Notwendigkeit von etwas wie einem „KI-Privileg“ nachgedacht; dies beschleunigt die Notwendigkeit, dieses Gespräch zu führen, erheblich.
— Sam Altman (@sama) 6. Juni 2025
Meiner Meinung nach sollte das Gespräch mit einer KI dem Gespräch mit einem Anwalt oder Arzt gleichen.
Ich hoffe, die Gesellschaft findet dafür bald eine Lösung.
Altman äußerte im sozialen Netzwerk X seine Bedenken hinsichtlich des Gerichtsbeschlusses und setzte sich öffentlich für die Notwendigkeit eines „KI-Privilegs“ ein, um sicherzustellen, dass die Unterhaltungen der Nutzer mit KI vertraulich bleiben, ähnlich wie Gespräche mit Ärzten oder Anwälten. Das ist keine schlechte Idee, insbesondere wenn man bedenkt, dass viele Menschen ChatGPT tatsächlich als Arzt, Therapeut und Anwalt nutzen.
Wer vom Gerichtsbeschluss betroffen ist
Laut OpenAI betrifft der Beschluss Nutzer der Versionen ChatGPT Free, Plus, Pro und Team sowie reguläre API-Kunden. Wenn Sie ChatGPT Enterprise oder Edu nutzen oder API-Kunde mit einer Vereinbarung über eine Datenspeicherung von null (Zero Data Retention – ZDR) sind, fallen Ihre Daten nicht unter den Beschluss. Diese Unterscheidung zeigt, dass einige Nutzer, die für Premiumdienste bezahlen, einen besseren Datenschutz genießen als gewöhnliche Nutzer. Der Beschluss zur Datensicherung betrifft Nutzer der ChatGPT-Abonnements Free, Plus, Pro und Team sowie API-Nutzer ohne ZDR-Vereinbarung. Enterprise-, EDU- und API-Nutzer mit ZDR sind von diesem Beschluss nicht betroffen. Dadurch entsteht eine Ungleichheit beim Datenschutz zwischen verschiedenen Nutzertypen, wobei diejenigen, die für die teuersten Dienste bezahlen, einen besseren Schutz genießen.
Für tschechische Nutzer bedeutet dies konkret, dass Ihre Daten vom Beschluss zur Datensicherung erfasst werden, wenn Sie gewöhnliche ChatGPT-Versionen (Free, Plus, Pro oder Team) verwenden. Nur Unternehmen und Institutionen mit den teuersten Enterprise- oder Edu-Lizenzen sind von dieser Anordnung ausgenommen.
Sicherheitsgarantien und Zugriff auf Daten
OpenAI versichert, dass die aufbewahrten Daten nicht automatisch an die The New York Times oder Dritte weitergegeben werden. Der Zugriff auf diese Daten wird gemäß rechtlichen Protokollen streng kontrolliert. Das Unternehmen prüfte außerdem die Möglichkeit, die gespeicherten Daten als Kompromiss zur Lösung der Datenschutzbedenken zu anonymisieren. Der Beschluss zur Aufbewahrung bleibt jedoch in Kraft, solange die Berufungsverfahren laufen.
Daten, die KI-Unternehmen sammeln
Diese Entscheidung wirft die Frage auf: Über welche Daten sprechen wir eigentlich? Während der Gerichtsbeschluss neu ist, ist die Datenerfassung das keineswegs. Kürzlich erschien auf Reddit eine Grafik, die einen Überblick darüber bietet, wie viele Daten KI-Chatbots möglicherweise anhäufen könnten (basierend auf ihren eigenen Datenschutzhinweisen im App Store).
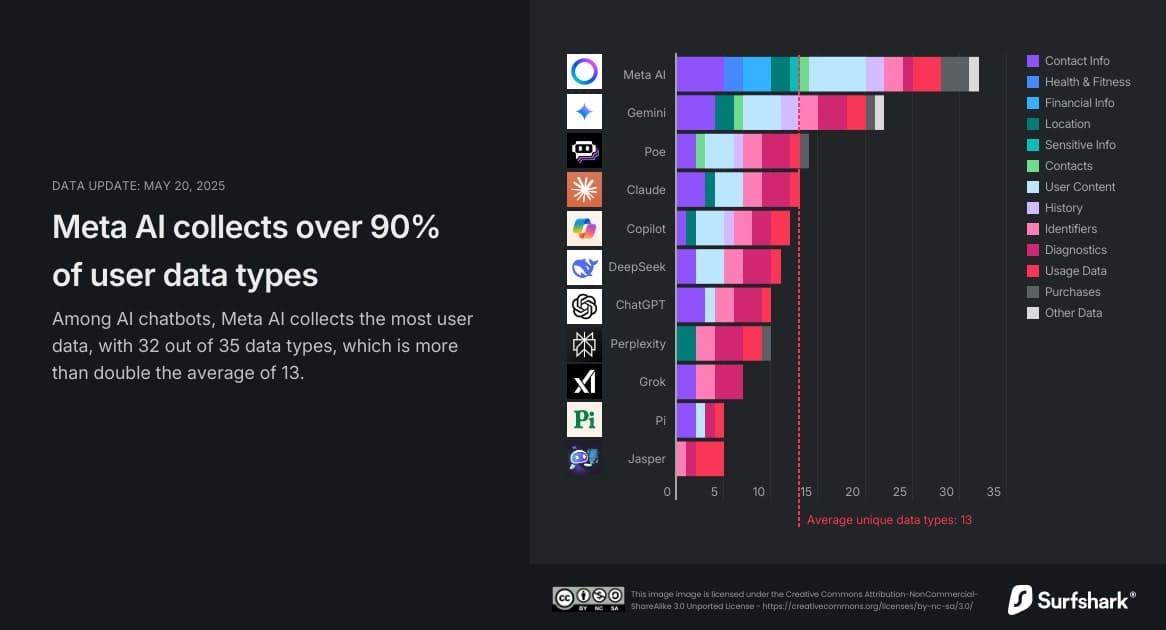
Meta AI trägt die Krone, da es erstaunliche 32 von 35 möglichen Datentypen sammelt, darunter Finanzinformationen, Gesundheitsdaten und sogar „sensible Informationen“ wie Ihre politischen Ansichten. Google Gemini belegte mit 22 Datentypen den zweiten Platz, darunter Ihr genauer Standort und Ihre Kontakte. Keine Überraschung – Google bleibt Google. ChatGPT und Microsoft Copilot sind überraschend zurückhaltend und sammeln jeweils nur 10 Datentypen. Und Elons Grok gehört zu den Diensten auf der Liste, die am wenigsten Daten sammeln.
Irreführende Angaben zur Datenerfassung
Der Haken ist, dass dies darauf basiert, was die Unternehmen nach eigenen Angaben sammeln. Wie einige angemerkt haben, können diese Kennzeichnungen problematisch sein. ChatGPT weist unter Android eine Standortverfolgung aus, unter iOS jedoch nicht. Meta hat wahrscheinlich jedes Kästchen angekreuzt, nur um sich rechtlich abzusichern. Und Apples Überprüfungen können die serverseitige Nachverfolgung nicht erfassen, die stattfindet, nachdem Sie auf „Senden“ geklickt haben. Diese auf den Selbstauskünften der Unternehmen beruhenden Angaben können irreführend sein. Die tatsächliche Datenerfassung kann erheblich von dem abweichen, was die Unternehmen offiziell melden. Die serverseitige Nachverfolgung, die nach dem Absenden einer Nachricht erfolgt, entzieht sich häufig der Kontrolle und kann wesentlich umfangreicher sein als die offiziell angegebenen Verfahren.
DSGVO versus US-Gerichtsbeschluss
Für tschechische und europäische Nutzer schafft dieser Fall eine beispiellose Situation, in der US-Recht mit europäischen Datenschutzstandards in Konflikt gerät. Die DSGVO verlangt von Unternehmen, das Recht der Nutzer auf Löschung ihrer personenbezogenen Daten zu respektieren und die Datenspeicherung auf die kürzestmögliche Dauer zu beschränken.
Die unbegrenzte Aufbewahrung sämtlicher ChatGPT-Unterhaltungen, einschließlich derer, die Nutzer gelöscht haben, steht in direktem Widerspruch zu diesen Grundsätzen. Dadurch entsteht ein rechtliches Paradoxon, bei dem OpenAI gegen europäische Datenschutzgesetze verstoßen muss, um den US-Gerichtsbeschluss einzuhalten.
Die tschechische Datenschutzbehörde und andere europäische Aufsichtsbehörden könnten künftig eingreifen, falls dieser Zustand anhält. Dies könnte zu Geldbußen für OpenAI gemäß der DSGVO führen, die bis zu 4 % des weltweiten Jahresumsatzes des Unternehmens betragen können.
Bedeutung des Rechtsstreits für die Zukunft
Der Gerichtsbeschluss gegen OpenAI beweist, dass es im Grunde bedeutungslos ist, was diese Unternehmen auch immer über die Löschung von Daten behaupten, wenn ein Richter sagt: „Bewahren Sie alles auf.“ Ihre nächtlichen Angstspiralen, Ihre Besprechungen zur Geschäftsstrategie, Ihre geheimen Projektanfragen – alles wird für eine mögliche rechtliche Prüfung aufbewahrt.
Dies schafft einen gefährlichen Präzedenzfall. Jedes andere KI-Unternehmen beobachtet, wie sich dies entwickelt, und Sie können darauf wetten, dass dessen Anwälte denken: „Vielleicht sollten wir ebenfalls alles aufbewahren.“ Wenn wir Sams Vision eines Privilegs zwischen Nutzer und KI, das uns schützen würde, nicht verwirklichen, könnten wir in eine Ära eintreten, in der jedes Gespräch mit Ihrer KI Teil einer dauerhaften Aufzeichnung werden könnte.
Der Ausgang dieses Rechtsstreits könnte bedeutende Präzedenzfälle für den Datenschutz und die Datenspeicherung in der KI-Branche schaffen. Sollte das Gericht zugunsten der The New York Times entscheiden, könnte dies dazu führen, dass andere KI-Unternehmen vorsorglich sämtliche Benutzerdaten speichern, um zukünftige rechtliche Probleme zu vermeiden.
Empfehlungen für tschechische Nutzer
Für tschechische Nutzer ist es wichtig, sich bewusst zu machen, dass ihre Unterhaltungen mit ChatGPT nicht mehr so privat sind, wie sie vielleicht dachten. Es wird empfohlen:
- Beschränken Sie die Weitergabe sensibler Informationen – geben Sie keine personenbezogenen Daten, Finanzinformationen oder Geschäftsgeheimnisse in ChatGPT ein.
- Erwägen Sie ein Upgrade auf die Enterprise-Version – wenn Sie Geschäftskunde sind, bietet die Enterprise-Version einen besseren Datenschutz.
- Verfolgen Sie die Entwicklung des Falls – die Situation kann sich abhängig vom Ausgang der Berufung von OpenAI ändern.
- Informieren Sie sich über Alternativen – es gibt KI-Tools mit besseren Datenschutzstandards.
Die neue Realität des KI-Datenschutzes
Dieser Fall offenbart ein grundlegendes Problem mit unserer Wahrnehmung von Privatsphäre im neuen Zeitalter der künstlichen Intelligenz. Was wir als private Unterhaltungen mit KI-Assistenten betrachteten, kann nun zum Gegenstand von Gerichtsverfahren und Rechtsstreitigkeiten werden. OpenAI kämpft aktiv gegen diesen Beschluss, doch das Ergebnis wird weitreichende Folgen für die gesamte KI-Branche haben.
Für tschechische Nutzer ist die Situation besonders kompliziert, da sie sich in einem rechtlichen Vakuum zwischen US-Gerichten und europäischen Datenschutzstandards befinden. Verbraucher sollten sich bewusst sein, dass ihre „gelöschten“ Unterhaltungen mit KI möglicherweise nicht wirklich gelöscht sind und auf unbestimmte Zeit aufbewahrt werden können, was ihren Rechten gemäß der DSGVO widerspricht.
Dieser Präzedenzfall könnte verändern, wie wir über Privatsphäre im digitalen Zeitalter denken, und unterstreicht die dringende Notwendigkeit einer internationalen Abstimmung der rechtlichen Rahmenbedingungen zum Schutz der Privatsphäre bei KI-Technologien. Bis klare Regelungen erreicht sind, sollten Nutzer vorsichtig damit sein, welche Informationen sie mit KI-Systemen teilen, unabhängig davon, wo sie leben.


