

GPT-5 erzielt übermenschliche Ergebnisse in der Medizin
Stellen Sie sich eine Welt vor, in der künstliche Intelligenz Ärzte nicht nur unterstützt, sondern sie in einigen Tests sogar direkt übertrifft. Das ist keine Science-Fiction, sondern laut einer neuen Studie der Emory University Realität. Diese auf arXiv veröffentlichte Arbeit untersucht die Fähigkeiten des GPT-5-Modells von OpenAI im Bereich des multimodalen medizinischen Schlussfolgerns. Die Autoren der Studie – Shansong Wang, Mingzhe Hu, Qiang Li und weitere Forschende vom Department of Radiation Oncology am Winship Cancer Institute – testeten das Modell anhand verschiedener Benchmarks und verglichen es sowohl mit der Vorgängerversion GPT-4o als auch mit menschlichen Experten. Die Ergebnisse sind beeindruckend und zeigen, wie schnell sich KI weiterentwickelt. Sehen wir uns das genauer an.
Wie GPT-5 getestet wurde
GPT-5 ist das neueste große Sprachmodell von OpenAI, das nicht nur Text, sondern auch Bilder wie medizinische Aufnahmen verarbeiten kann. Die Studie bewertete es im Zero-Shot-Modus mit einem Chain-of-Thought-Ansatz (Gedankenkette). Das bedeutet, dass das Modell Schritt für Schritt schlussfolgern musste, ohne zuvor mit spezifischen Daten trainiert worden zu sein. Die Tests wurden mit dem MedQA-Datensatz durchgeführt, der Fragen aus den US-amerikanischen medizinischen Zulassungsprüfungen enthält, sowie mit MMLU in medizinischen Unterkategorien, USMLE-Self-Assessment-Prüfungen und multimodalen Benchmarks wie MedXpertQA und VQA-RAD. Bei multimodalen Aufgaben erhielt das Modell textliche Beschreibungen von Patienten zusammen mit Bildern, beispielsweise CT-Aufnahmen, und musste auf dieser Grundlage eine Diagnose stellen.
In einem konkreten Fall aus MedXpertQA identifizierte das Modell anhand einer Kombination von Laborwerten wie einem Hämoglobinwert von 9 g/dL und einem mittleren Erythrozytenvolumen von 120 μm³ sowie körperlichen Symptomen wie suprasternalem Krepitus und blutigem Erbrechen korrekt das Boerhaave-Syndrom – eine seltene Ruptur der Speiseröhre. Als nächsten Schritt schlug das Modell eine Gastrografin-Schluckuntersuchung vor, einen Test mit Kontrastmittel, und erklärte, warum andere Optionen wie Ondansetron oder eine Epinephrin-Injektion nicht geeignet sind.
Ergebnisse der Benchmarks
Beim textbasierten MedQA-Benchmark (Version mit vier Antwortmöglichkeiten) erreichte GPT-5 eine Genauigkeit von 95,84 %, was 4,80 % besser ist als GPT-4o-2024-11-20 mit 91,04 %. Bei MedXpertQA Text verbesserte das Modell die Punktzahl beim Schlussfolgern um 26,33 % auf 56,96 % und beim Verständnis um 25,30 % auf 54,84 %. Bei MMLU übertraf es das Vorgängermodell in medizinischen Fachgebieten wie Anatomie (92,59 %), klinischem Wissen (95,09 %) oder medizinischer Genetik (100 %) um 1–4 %.
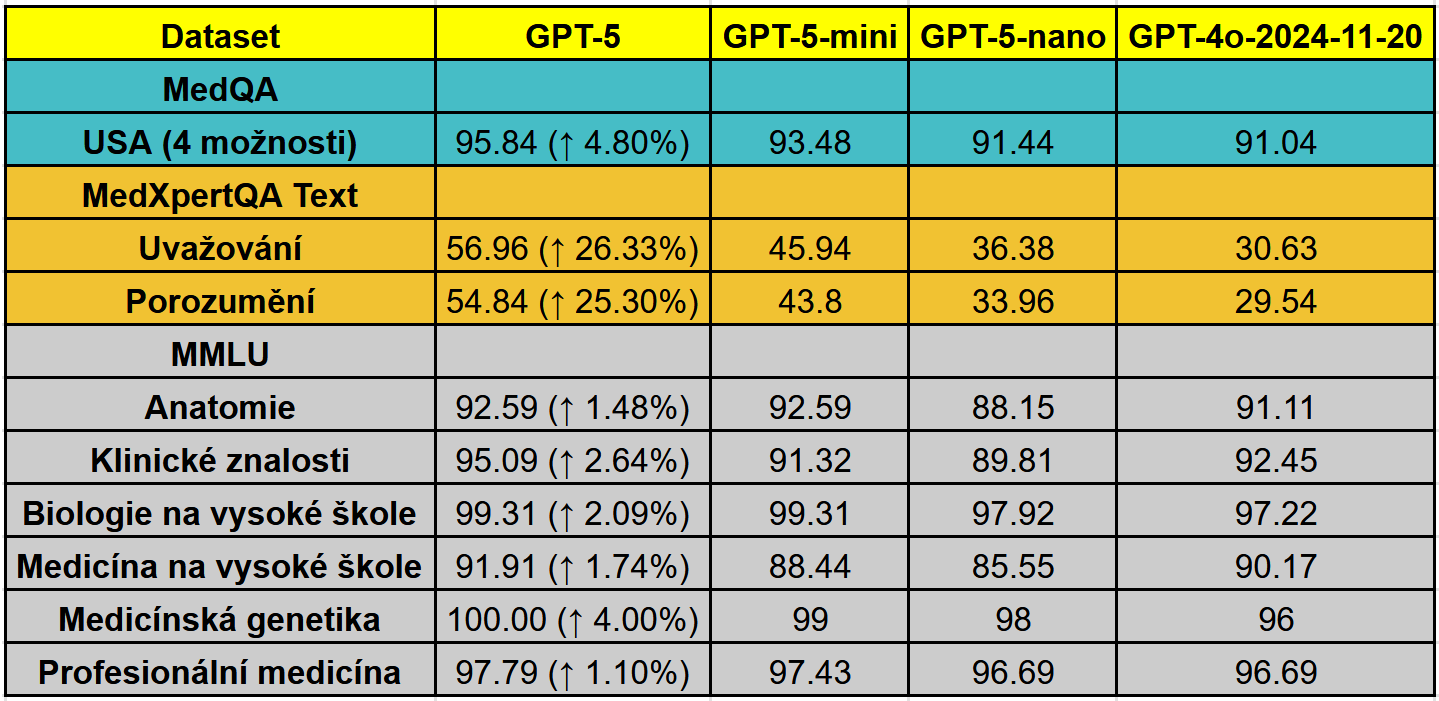
Bei den USMLE-Self-Assessment-Prüfungen, die Fragen aus Step 1, Step 2 und Step 3 umfassen, erreichte GPT-5 eine durchschnittliche Punktzahl von 95,22 %, wobei die größte Verbesserung bei Step 2 erzielt wurde (97,50 %, +4,17 % gegenüber GPT-4o). Das liegt deutlich über dem Niveau, das menschliche Ärzte zum erfolgreichen Bestehen der Prüfungen benötigen.
In den multimodalen Tests mit MedXpertQA MM glänzte das Modell mit 69,99 % beim Schlussfolgern (+29,26 % gegenüber GPT-4o) und 74,37 % beim Verständnis (+26,18 %). Bei VQA-RAD, das sich auf radiologische Bilder konzentriert, erreichte es 70,92 %. Das ist etwas weniger als bei der kleineren Variante GPT-5-mini, aber dennoch ein solides Ergebnis. Diese Ergebnisse zeigen, wie GPT-5 textbasierte Angaben wie Vitalzeichen (z. B. einen Blutdruck von 90/63 mmHg und einen Puls von 130/min) mit visuellen Daten aus Bildern verknüpfen kann.
Vergleich mit menschlichen Experten
Am eindrucksvollsten ist der Vergleich mit Medizinern vor dem Erwerb ihrer Zulassung, etwa Studierenden oder Ärzten in der Weiterbildung. Bei MedXpertQA Text übertraf GPT-5 diese Experten beim Schlussfolgern um 15,22 % und beim Verständnis um 9,40 %. Beim multimodalen MedXpertQA MM war der Unterschied noch deutlicher: +24,23 % beim Schlussfolgern und +29,40 % beim Verständnis. GPT-4o hingegen blieb in den meisten Kategorien unter dem Niveau dieser Experten.
Laut einem Tweet von Dr. Derya Unutmaz, der diese Ergebnisse teilte, deutet dies auf einen Wandel hin: Während GPT-4o auf dem Niveau von Menschen lag, liegt GPT-5 darüber. Das wirft die Frage auf, ob es bald als fahrlässig gelten könnte, wenn Ärzte KI nicht in der klinischen Praxis einsetzen. Die Studie betont, dass GPT-5 Fortschritte bei der Integration heterogener Daten wie Patientengeschichten, strukturierter Daten und Bilder erzielt, was zu besseren klinischen Entscheidungen führen könnte.
Außerdem ist GPT-5 Pro noch besser und erreicht das Niveau führender klinischer Spezialisten.
— Derya Unutmaz, MD (@DeryaTR_) 13. August 2025
Wenn diese KI-Modelle nicht für Diagnose und Behandlung eingesetzt werden, obwohl sie die Behandlungsergebnisse der Patienten eindeutig verbessern könnten, könnte dies bald als eine Form ärztlichen Fehlverhaltens angesehen werden. https://t.co/yffWk68Z4d
Diese Studie der Emory University zeigt, dass GPT-5 einen großen Fortschritt im Bereich medizinischer KI darstellt. Mit Ergebnissen, die menschliche Experten in kontrollierten Tests übertreffen, ebnet es den Weg für Entscheidungsunterstützungssysteme in Krankenhäusern. Die Autoren haben den Code auf GPT-5-Evaluation für weitere Forschung freigegeben. Natürlich ist die reale Welt der Medizin komplexer als Benchmarks, doch die Richtung ist klar: KI wie GPT-5 wird zu einem unverzichtbaren Werkzeug.


