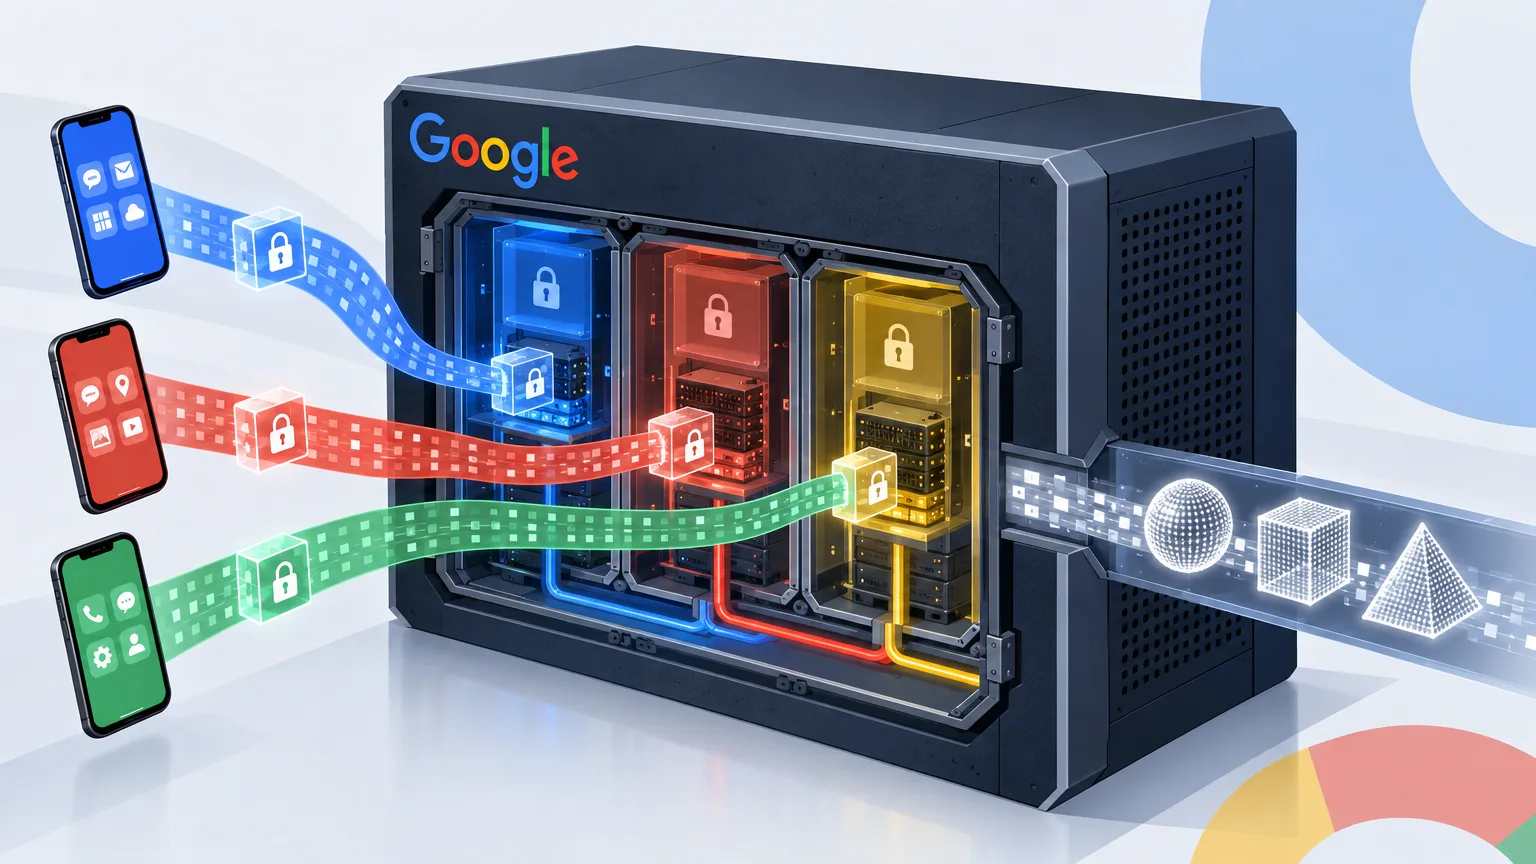
Google Research hat ein neues System für föderiertes Lernen vorgestellt, das Berechnungen von Geräten auf Server in vertrauenswürdigen Ausführungsumgebungen, sogenannten TEEs, verlagert. Dabei lässt sich die Anonymisierung der Daten extern überprüfen und auditieren. Gboard setzt das System bereits für englische und japanische Modelle zur Vorhersage des nächsten Wortes ein, für die Google eine höhere Genauigkeit angibt.
Gboards Training hängt weniger von der Geräteverfügbarkeit ab
Die Umstellung betrifft das Training der Modelle für die Tastatur. Laut Google konnte das Training eines solchen Modells bislang ein bis zwei Monate dauern. Den Fortschritt begrenzten die Verfügbarkeit der beteiligten Geräte, ihre Rechenleistung und die Konkurrenz mehrerer Trainingsaufgaben um dieselben Ressourcen.
Das neue System beschleunigt das Training nach Angaben des Unternehmens erheblich, indem es Berechnungen auf viele Server verteilt. Der begrenzende Faktor ist derzeit die Verfügbarkeit von TEE-Ressourcen. Google sammelt außerdem zunächst sämtliche von den Geräten hochgeladenen Daten und startet erst danach das serverseitige Training, sodass dessen Fortschritt nicht mehr von tageszeitlichen Schwankungen der Geräteverfügbarkeit beeinflusst wird.
Eine genehmigte Richtlinie regelt den Datenzugriff
Nach Googles Beschreibung verschlüsseln die Geräte Trainingsbeispiele zunächst lokal und laden sie anschließend auf den Server hoch. Vor der Verarbeitung genehmigen sie eine Zugriffsrichtlinie, die festlegt, welche konkreten Berechnungen innerhalb der TEEs die Daten verarbeiten dürfen. Diese Berechnungen dürfen ausschließlich anonymisierte Ergebnisse ausgeben; zudem verlangen die Geräte, dass die Richtlinien in einem öffentlichen Register veröffentlicht werden.
Den Zugriff auf die Entschlüsselungsschlüssel steuert das Schlüsselverwaltungssystem KMS. Google beschreibt es als einen Verbund von TEEs, der das Konsensprotokoll RAFT verwendet. Schlüssel erhalten nur serverseitige Aufgaben innerhalb von TEEs, deren Berechnungen mit den Vorgaben der Zugriffsrichtlinie übereinstimmen.
Python steuert parallele Berechnungen und die Wiederherstellung
Das Training wird laut Google von einer übergeordneten TEE gesteuert, in der eine in Python geschriebene Trainingsschleife läuft. Parallel ausführbare Teilaufgaben verteilt sie auf einen Verbund von Arbeits-TEEs. Die verteilte Logik wird mit der quelloffenen Sprache Federated Language beschrieben, die von TensorFlow Federated abgeleitet ist; die Trainingsschleife gibt regelmäßig anonymisierte Modellgewichte an den Datenanalysten weiter.
Für den Fall, dass die steuernde TEE oder eine Arbeits-TEE ausfällt, speichert das Programm am Ende einer Trainingsrunde den zur Wiederherstellung benötigten Zustand. Dieser wird mithilfe des KMS verschlüsselt. Laut Google soll sich das Training dadurch nach einem Ausfall fortsetzen lassen, ohne weitere sensible Informationen preiszugeben.
Auditoren können Richtlinien und Programm-Builds prüfen
Google zufolge sehen die Betreiber der Aufgaben ausschließlich Metriken und Modellgewichte, die durch differenzielle Privatsphäre geschützt sind. Hochgeladene Trainingsbeispiele können nur innerhalb von TEEs entschlüsselt und verarbeitet werden, in denen durch die Zugriffsrichtlinie erlaubte Python-Programme laufen. Diese Verarbeitung ist zudem nur für einen begrenzten Zeitraum nach dem Hochladen möglich.
Für die externe Kontrolle veröffentlicht das Unternehmen die Zugriffsrichtlinien im öffentlichen Register Rekor. Auditoren können laut Google dort sämtliche serverseitigen Aufgaben verfolgen, an denen Geräte potenziell teilnehmen könnten. Die Binärdateien des KMS und der Datenverarbeitungskomponenten lassen sich nach Unternehmensangaben reproduzierbar aus dem offenen Quellcode im GitHub-Repository Confidential Federated Compute erstellen.
TEEs ermöglichen laut Google eine Fernüberprüfung der ausgeführten Logik, schützen ihren internen Zustand vor Einsicht und sichern die Integrität der Berechnung. Das Unternehmen schränkt diese Eigenschaften jedoch auf die Möglichkeiten der aktuellen TEE-Generation ein.
Nicht öffentliche Modellbestandteile lassen sich zur Laufzeit nachladen
Die Auditierbarkeit soll laut Google auch dann erhalten bleiben, wenn das Unternehmen die Modellarchitektur oder die Logik zur Datenvorverarbeitung nicht offenlegen möchte. Die Datenverarbeitungsumgebungen unterstützen deshalb das Nachladen serialisierter Informationen in das Python-Programm zur Laufzeit. Google knüpft die extern überprüfbaren Datenschutzgarantien daran, dass sämtliche datenschutzrelevante Logik fest im Programm verankert bleibt.
Optimierte Teilnahmeplanung und ein Weg zu größeren Modellen
Bei der serverseitigen Verarbeitung kann das Programm laut Google dynamisch einen optimalen Teilnahmeplan für die Geräte berechnen und daran weitere Parameter der differenziellen Privatsphäre ausrichten. Das Unternehmen verglich das neue und das bisherige System beim Training eines englischen Modells zur Vorhersage des nächsten Wortes über jeweils 5.000 Runden mit Kohorten von 6.500 Geräten. Laut diesem Forschungsvergleich ermöglichte die optimierte Teilnahmeplanung stärkere Datenschutzgarantien, kleinere Multiplikatoren für das hinzugefügte Rauschen oder beides.
Auch die Berechnung der Client-Gradienten wurde auf den Server verlagert. Laut Google entfallen damit Einschränkungen durch die Rechenleistung der Geräte, was den Weg zum Training größerer Modelle mit föderiertem Lernen eröffnet. Für solche künftigen Anwendungen hält das Unternehmen die Anbindung von TEEs an Beschleuniger für wichtig.