

Gemma 3 270M: Ultrakompakte KI für mobile Geräte
Die Gemma-Modellfamilie von Google wächst rasant. Nach der Einführung von Gemma 3 und Gemma 3 QAT für die Cloud und Desktop-Systeme folgte Gemma 3n für Mobilgeräte mit multimodaler KI. Nun kommt Gemma 3 270M, ein Modell mit 270 Millionen Parametern (170 Millionen für Embeddings, 100 Millionen für Transformer-Blöcke), das für spezifisches Fine-Tuning entwickelt wurde. Mit einem Vokabular von 256.000 Tokens ist es ideal für Domänen wie Sprachen oder Fachgebiete. Das Kontextfenster umfasst 32.000 Tokens, was für die meisten Aufgaben ausreicht.
Das Modell zeichnet sich durch seine Energieeffizienz aus: Bei INT4-Quantisierung verbraucht es für 25 Unterhaltungen nur 0,75 % des Akkus eines Pixel 9 Pro. Es läuft auf Geräten mit mindestens 4 GB RAM (CPU) oder 2 GB VRAM (GPU), bei einer Dateigröße von rund 550 MB beziehungsweise bis zu 200 MB für quantisierte Versionen. Auf einem Apple M4 Max erreicht es bei niedriger Latenz mehr als 650 Tokens pro Sekunde.
Wichtige Fähigkeiten und Bereitstellung
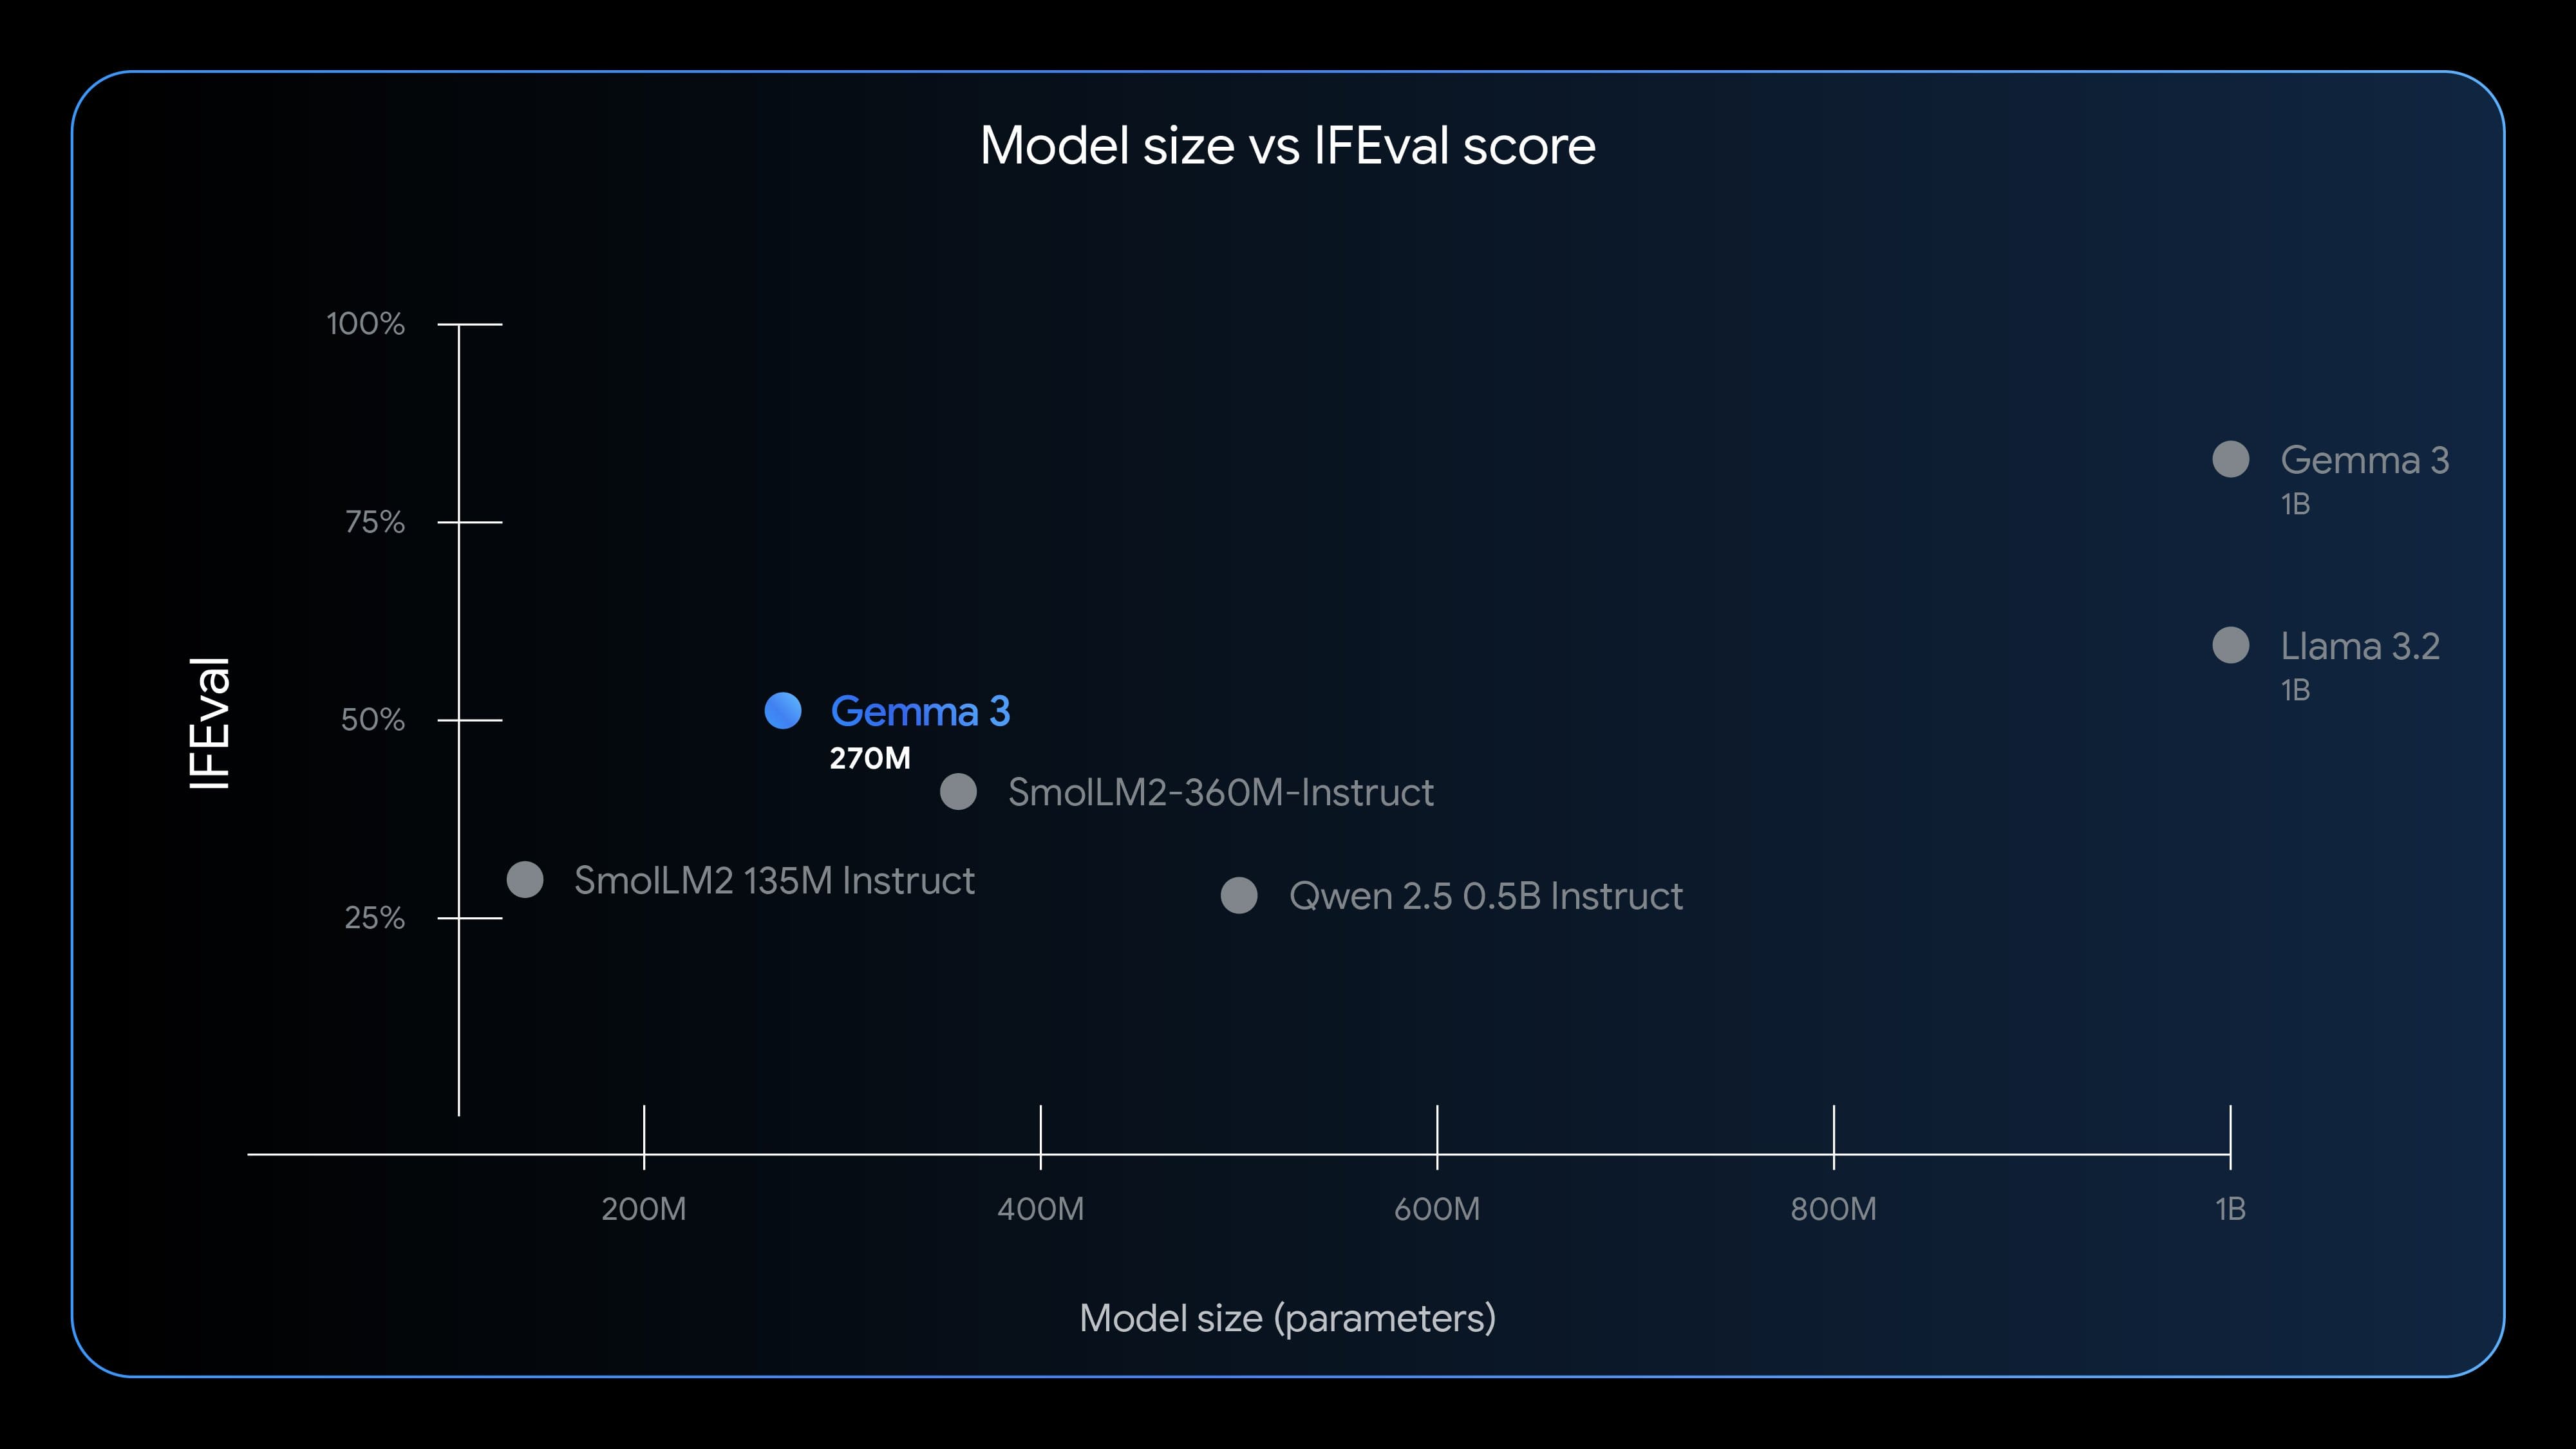
Gemma 3 270M ist multimodal (es verarbeitet Text, Bilder und Videos) und mehrsprachig (über 140 Sprachen) und verfügt laut dem IFEval-Benchmark über integrierte Fähigkeiten zur Befolgung von Anweisungen. Es stehen sowohl vortrainierte als auch auf Anweisungen trainierte Checkpoints zur Verfügung, einschließlich QAT für INT4-Präzision ohne nennenswerten Leistungsverlust.
Das Fine-Tuning ist schnell – es lässt sich mit minimalen Daten mithilfe von LoRA auf Geräten mit 8 GB RAM und 4 GB VRAM durchführen. Unterstützt werden Plattformen wie Windows, macOS und Linux sowie Tools wie Hugging Face, UnSloth oder JAX. Die Bereitstellung ist lokal oder auf Google Cloud Run möglich und eignet sich ideal für datenschutzfreundliche Offline-Anwendungen.
Praktische Einsatzmöglichkeiten
Das Modell ist für klar definierte Aufgaben wie Sentimentanalyse, Entitätsextraktion, Weiterleitung von Anfragen oder kreatives Schreiben vorgesehen. Ein Beispiel ist die Zusammenarbeit von Adaptive ML mit SK Telecom, bei der eine feinabgestimmte Version größere Modelle bei der mehrsprachigen Moderation übertraf. Zu den weiteren Anwendungen gehört der Bedtime Story Generator zur Offline-Erstellung von Geschichten.
Es eignet sich hervorragend für große Aufgabenvolumina, bei denen es Zeit und Kosten spart – es läuft auf kostengünstiger Infrastruktur oder direkt auf dem Gerät. Es ermöglicht den Aufbau einer Flotte spezialisierter Modelle ohne großes Budget.
Einschränkungen und Verfügbarkeit
Als kompaktes Modell kann es stärker zu Halluzinationen neigen und weniger robuste Ausgaben liefern als größere LLMs. Weder die Trainingsdaten noch der Quellcode wurden veröffentlicht, sondern lediglich die vortrainierten Gewichte. Es kann von Hugging Face, Ollama, Kaggle, LM Studio oder Docker heruntergeladen werden. Testen Sie es auf Vertex AI, llama.cpp, Gemma.cpp, LiteRT, Keras oder MLX.
Gemma 3 270M, das Mitte August 2025 vorgestellt wurde, verschiebt die Grenzen der Effizienz für Entwickler, die schnelle und sparsame KI-Lösungen auf Edge-Geräten einsetzen möchten. Wir freuen uns auf Ihre Innovationen im Gemmaverse.


